

Hermes Incident Commander — автономный SRE-агент для реагирования на инциденты
📂 Исходный код на GitHubАвтономный SRE-агент и standalone-watchdog для обнаружения, диагностики и устранения production-инцидентов. Интегрируется с Hermes Agent, поддерживает Claude, безопасную авторемедиацию, уведомления, SQLite-историю, офлайн-дашборд и Prometheus.
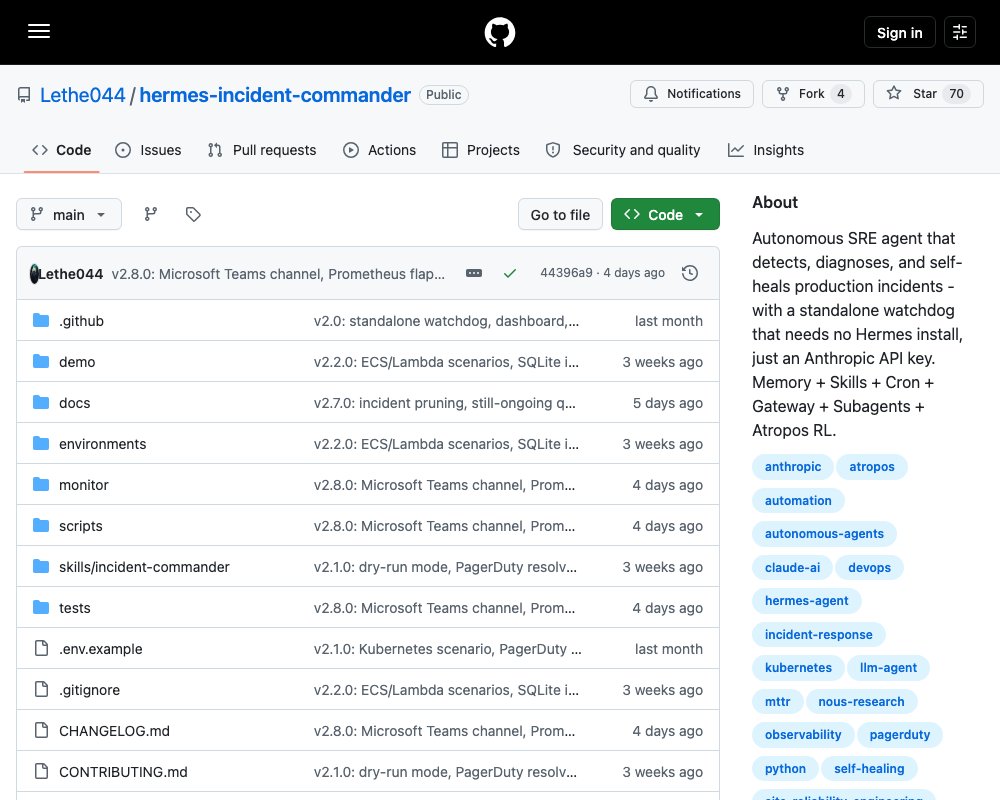
Hermes Incident Commander — автономный SRE-агент, который должен не только поднять тревогу, но и пройти весь цикл реагирования: обнаружить отказ, определить его серьёзность, собрать диагностические данные, предложить или применить исправление, проверить результат и сохранить выводы для следующих инцидентов. Проект создан для хакатона Nous Research и изначально строился поверх Hermes Agent, но теперь предлагает два сценария применения: полноценный workflow внутри Hermes и автономный watchdog, которому достаточно Linux-хоста и ключа Anthropic API.
Как устроен цикл реагирования
В основном сценарии агент проходит пять последовательных этапов:
- Обнаружение. Собираются показатели CPU, памяти, диска, процессов и состояния сервисов.
- Классификация. Инциденту присваивается уровень от P0 до P3 в зависимости от потенциального влияния на систему.
- Диагностика. Агент анализирует логи, процессы, stack trace и другие доступные признаки, чтобы сформулировать первопричину.
- Устранение. Выбирается безопасное исправление из доступных уровней вместо безусловного выполнения произвольных команд.
- Проверка. Метрики до и после исправления сравниваются, чтобы убедиться, что проблема действительно исчезла.
После завершения цикла формируется отчёт об инциденте. В полной версии Hermes Agent также создаёт отдельный SKILL.md с правилами профилактики и обновляет память о топологии конкретной инфраструктуры. Благодаря этому обработка похожих отказов в следующий раз может начинаться не с нуля.
Два режима работы
Hermes Incident Commander внутри Hermes Agent
Полный режим использует возможности Hermes Agent:
- постоянная память хранит карту сервисов и накапливает знания о повторяющихся сбоях;
- автоматически создаваемые навыки превращают новые инциденты в профилактические сценарии;
- планировщик запускает проверки и регулярные отчёты;
- Gateway отправляет уведомления в подключённые каналы;
- субагенты могут параллельно исследовать разные уровни системы;
- полнотекстовый поиск помогает находить похожие случаи в истории;
execute_codeобъединяет многошаговые диагностические пайплайны;- MCP-интеграции позволяют обращаться к API облачных провайдеров.
Установка навыка из репозитория сводится к копированию каталога в ~/.hermes/skills/. После этого в Hermes можно запросить регулярную проверку здоровья, оповещения о критических событиях и утренний отчёт. Отдельный Atropos-контур поддерживает обучение SFT и RL на десяти синтетических сценариях с наградой за устранение проблемы, качество RCA, отчёт, созданный навык, скорость и эффективность работы с инструментами.
Автономный watchdog
Для базового сценария Hermes Agent не требуется. Процесс monitor/watchdog.py работает на Linux-хосте, собирает реальные метрики через psutil и передаёт Claude только числовые значения. В отличие от демонстрационного режима, watchdog не выдаёт модели доступ к оболочке.
Быстрый запуск выглядит так:
pip install -e .

export ANTHROPIC_API_KEY=sk-ant-...

python -m monitor.watchdog --dry-run
python -m monitor.watchdog --cpu-threshold 85 --interval 30
По умолчанию агент только наблюдает. Автоматическое устранение включается отдельным флагом и допускается только для действий из явного allow-list: например, перезапуска конкретного systemd-сервиса или очистки выбранного каталога логов. Перед включением этого режима конфигурацию можно проверить без запуска мониторинга:
python -m monitor.watchdog --config monitor/watchdog_config.yaml --validate-configКоманда выявляет неизвестные параметры, пороговые значения вне диапазона 0–100, отрицательные интервалы, некорректные окна тишины и разрешённые действия, не соответствующие ни одному отслеживаемому сервису.
Контроль шума и ложных срабатываний
Для production-мониторинга недостаточно обнаруживать отказы: слишком чувствительный watchdog способен создавать больше шума, чем пользы. Проект предусматривает несколько механизмов.
Адаптивные пороги строят базовый уровень отдельно для каждого часа суток по собственным наблюдениям watchdog. Они могут только повысить эффективный порог относительно настроенного значения и ограничены множителем 1,5. Поэтому ночная пакетная нагрузка не должна обучить систему игнорировать настоящий инцидент. Механизм выключен по умолчанию.
Тихие часы позволяют подавить внешние уведомления на заданные интервалы UTC, не скрывая сам инцидент. Он всё равно попадёт в отчёт и базу истории. Если проблема сохраняется после окончания окна, watchdog отправит отдельное уведомление о её длительности.
Flapping detection отмечает три и более события одной категории за час. Такой паттерн может означать не устранённую первопричину или слишком чувствительный порог. Для CPU, памяти и диска система предлагает конкретное новое значение порога и ограничивает повторные оповещения о том же продолжающемся событии.
Dry-run выполняет одну проверку, показывает, какие команды были бы выполнены, но не меняет систему и не отправляет уведомления. Это полезный первый шаг перед выдачей агенту права на исправления.
Уведомления, история и наблюдаемость
Notifier поддерживает Discord, Slack, Microsoft Teams, PagerDuty и произвольный webhook. При временной сетевой ошибке доставка повторяется с экспоненциальной задержкой. В PagerDuty агент не только создаёт событие, но и закрывает его после восстановления сервиса.
Каждый инцидент попадает в локальную SQLite-базу. При наличии FTS5 доступен полнотекстовый индекс, иначе используется обычный поиск LIKE. Можно искать прошлые случаи, получать статистику в текстовом, JSON или CSV-формате и удалять старые записи:
python -m monitor.incident_db --sync
python -m monitor.incident_db --search "nginx"
python -m monitor.incident_db --stats --format csv
python -m monitor.incident_db --prune --older-than-days 90
Последняя команда работает в dry-run режиме. Для реального удаления нужен флаг --yes, а флаг --archive позволяет перенести старые отчёты в отдельный каталог холодного хранения.
Для локального анализа генерируется один самодостаточный HTML-дашборд без сервера и внешних запросов. В нём есть статистика по серьёзности и категориям, динамика за 14 дней, доля автоматически устранённых инцидентов, поиск и экспорт видимых строк в CSV. Альтернатива — встроенный endpoint Prometheus:
python -m monitor.watchdog --metrics-port 9877Endpoint слушает 127.0.0.1, доступен только для чтения и публикует метрики CPU, памяти, диска, failed systemd units, текущих нарушений, flapping и тихих часов. Готовый JSON для Grafana можно импортировать из репозитория.
Сценарии и проверка качества
Тренировочный контур включает десять типов отказов: падение nginx, заполнение диска логами, утечку памяти, падение Docker-контейнера, Kubernetes CrashLoopBackOff, цикл сбоя ECS task, недоступность сети, runaway CPU, failed systemd unit и таймауты Lambda. Помимо сценариев, проект содержит smoke test и набор из 220 pytest-тестов; CI запускает их на Python 3.10–3.12.
Это полезный набор для демонстрации полного цикла, но он не заменяет проверку на собственной инфраструктуре. Заявленное в README сокращение MTTR для P0-инцидентов с 45–60 минут до нескольких минут следует рассматривать как цель проекта, а не как результат независимого production-бенчмарка.
Безопасность и практический режим
Демо и RL-окружение дают модели полный доступ к терминалу, поэтому их следует запускать только в одноразовой виртуальной машине или контейнере. Автономный watchdog устроен безопаснее: модель не получает shell-доступ, а исправления ограничены конфигурацией. Перед применением к рабочему серверу всё равно нужно прочитать модель угроз проекта, начать с наблюдения и dry-run, затем постепенно расширять allow-list.
Hermes Incident Commander интересен как пример специализированного агентского workflow: обнаружение, расследование, исправление, проверка и накопление опыта объединены в один цикл. Наиболее безопасно применять его сначала к ограниченному набору метрик и сервисов, сохраняя человека в контуре для изменения политики remediation и первых запусков на production.