

Anthropic переписала систему контроля версий: как Scion заменила git
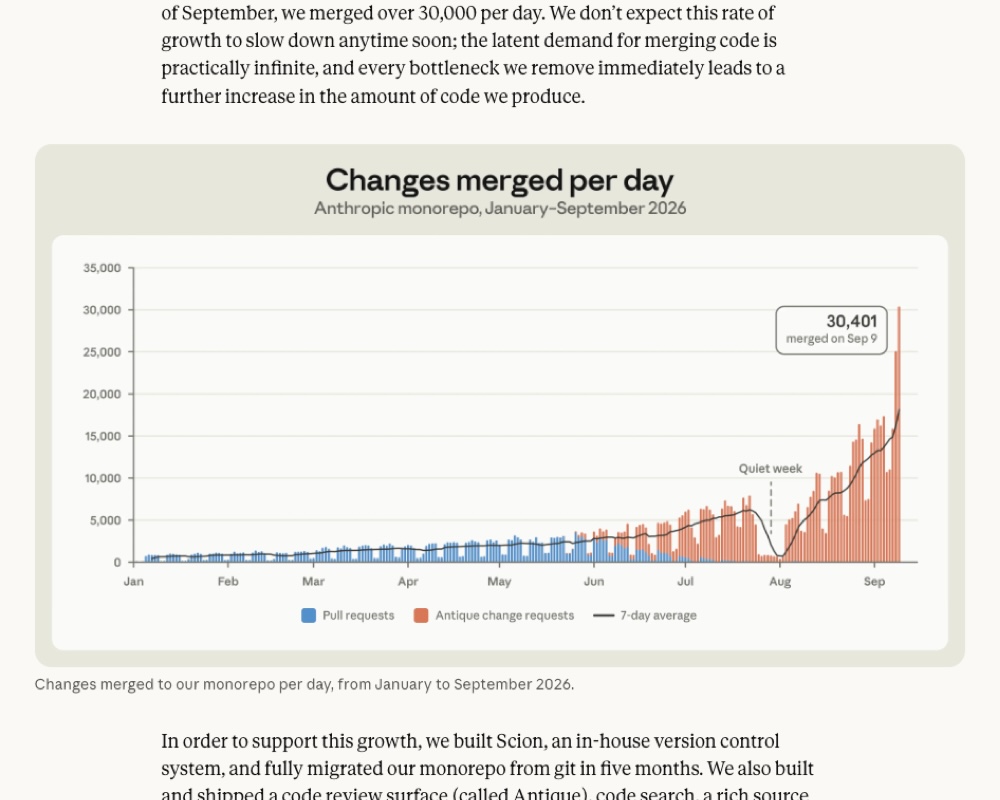
Когда в Anthropic число слитых изменений в день выросло с 2 500 до 30 000, git перестал справляться. Компания построила собственную систему контроля версий Scion и за пять месяцев полностью перевела на неё свой монорепозиторий. Разбираем, что именно сломалось в привычном подходе и какие шесть принципов заложены в новую архитектуру.
Цифры, из-за которых всё началось
В мае 2026 года Anthropic в среднем сливала около 2 500 изменений в день. К сентябрю — больше 30 000 в день. Рост в десять раз за четыре месяца, и компания не ждёт остановки.
Причина простая: писать код больше не узкое место. Claude сам итерирует исследовательские циклы, микрооптимизирует программы и с нуля строит новые сервисы. Узкое место теперь другое — инфраструктура разработки, рассчитанная на человека. Source control, сборки, CI.
Масштаб виден и по цифрам. История главной ветки занимает почти 100 ГБ, а даже сжатая рабочая копия весит больше 25 ГБ. Только для CI компания делает около 25 миллионов распаковок кода в день, без учёта рабочих мест разработчиков, песочниц агентов и исследовательских задач. Если бы всё это качалось обычным способом, поток git-данных превысил бы 600 ПБ в день.
Почему git перестал подходить
Git устроен как децентрализованная система. Каждая копия репозитория самодостаточна: она умеет считать диффы, читать историю, делать blame и работать офлайн. Для большинства репозиториев это правильный дизайн, и именно поэтому git стал стандартом.
Проблема Anthropic в том, что монорепозиторий вырос из этой модели. Компания использовала все доступные костыли: поверхностные клоны, разреженные распаковки, promisor-ремоуты, внутренние зеркала и снапшоты в объектном хранилище. На пике работало несколько сотен внутренних зеркал git. Это купило время, но управлять ими становилось тяжелее, а снапшоты отставали от головы главной ветки всё сильнее.
Ключевое наблюдение: почти все клиенты — агенты и задачи, а они по определению онлайн. Git при этом использовался как централизованная система с одной авторитетной копией. Отсюда вопрос: как выглядел бы source control, если бы его проектировали с учётом того, что агенты всегда подключены?
Прецеденты были. В Google систему контроля версий называли Piper, в Meta — Sapling, точнее его серверная часть Mononoke: https://github.com/facebook/sapling/blob/main/eden/mononoke/README.md. Из неё взяли модель данных Bonsai: https://github.com/facebook/sapling/blob/79071c2a3ea20c36ed71332608535e5801101bba/eden/mononoke/mononoke_types/serialization/bonsai.thrift#L50
Шесть принципов Scion
Клиенты всегда онлайн. Git предполагает, что клиенту нужна полная копия репозитория. В Scion всё построено вокруг всегда доступного сервера, а клиент забирает данные тогда, когда они ему понадобились.
Асимметрия клиента и сервера. В git любой клиент умеет быть полноценным сервером. В Scion всё делает сервер: отвечает на вопросы об истории и blame, создаёт коммиты, делает merge и rebase. Клиент держит небольшой локальный кеш объектов, раскладывает рабочую копию на диск и следит за изменениями в файловой системе. Сам он почти ничего не считает и взамен хранит намного меньше данных.
Сервис контроля версий — это API. В git задаче CI, которой нужно узнать, кто менял строку или как связаны два коммита, приходится держать локальную копию репозитория. В Scion все эти вопросы доступны через API, и во многих случаях задаче вообще не нужен локальный репозиторий. Без этого пайплайны автоматического бисекта и отката не масштабировались бы.
Всё должно масштабироваться вширь. Данные репозитория распределены, каждый компонент масштабируется отдельно. Полной копии репозитория нет нигде, даже на сервере. Аналога packfile нет, поэтому репозиторию не нужно обслуживание.
Коммит должен быть дешёвым. Коммит, rebase и merge выполняются на сервере, пушить нечего. Но стоимость операции обязана зависеть от размера изменения, а не от размера репозитория. Отдельный принцип: ветки и теги поощрять нельзя. Состояние, о котором должны договориться все серверы, рано или поздно станет проблемой.
Рабочая копия не обязательна. Есть разреженные распаковки, которые содержат только запрошенные директории, и виртуальные, которые материализуют файлы по требованию. Клиент платит только за то, что прочитал.
Как устроен Scion
Единица работы — changeset, запись в журнале упреждающей записи. Он хранит почти всё, что привычно видеть в коммите git, но с отличием: коммит git хранит указатель на дерево, а changeset хранит список изменённых файлов относительно первого родителя и адресуемые по содержимому указатели на сжатое содержимое в объектном хранилище. Changeset создаётся на сервере и сразу доступен везде, поэтому принимать packfile не нужно, блокировок и координации между серверами нет, а перенос ссылки сводится к атомарному сравнению с обменом в одной строке Spanner.
Changeset хранит только изменения, поэтому сам по себе не отвечает на вопрос «кто последний менял эту строку». Для таких вопросов Scion строит производные данные: отдельные структуры для blame, для истории путей и списки пропуска для графа коммитов. Все типы считает один общий механизм, и каждый описан рекурсивно — значение для changeset выводится из значений для его родителей. Отсюда три пользы: новый тип данных добавляется одной операцией, для каждого типа отдельно решается, считать его сразу или отложить, а клиент не видит внутренностей и потому не мешает оптимизировать структуры.
Как Scion масштабируется
Небольшой парк серверов отвечает на любые операции: получить changeset, посчитать дифф, найти точку слияния, отдать файл. Все данные адресуемы по содержимому и не меняются после записи, поэтому любой сервер может закешировать их, не договариваясь с остальными. По сути серверы — большие кеши, которые заодно считают производные данные и пишут их в Spanner.
Клиент scn работает иначе, чем git: он не сообщает серверу, что у него уже есть, и запрашивает только нужные деревья и файлы. Начиная с корневого дерева, он ищет недостающие деревья в локальном хранилище и запрашивает их, затем так же проходит по файлам. Каждый запрос — конкретный объект, который никогда не меняется, поэтому ответить на него может любой кеш. Многогигабайтного ответа нет, поэтому процесс устойчив к обрывам и легко продолжается с места остановки. Разреженные распаковки отдельной поддержки не требуют: клиент просто не спрашивает ненужное.
Внутри это трёхъярусная схема. Клиент говорит по сокету с демоном, который хранит объекты для всей ноды. Демон стартует с периодически обновляемого снапшота, а дальше общается только с региональными кешами scion-cache. Те отдают объекты прямо из памяти, уже в нужном демону формате, поэтому им не нужно считать недостающие объекты и делать дельта-сжатие. Нет объекта — кеш спрашивает у основных серверов, а те читают из Spanner и облачного хранилища.
Все три уровня отвечают на одинаковые RPC-вызовы, поэтому клиент не знает о топологии кешей. Но разделение уровней поддерживается строго, чтобы сбой в одном регионе не захлестнёт всю систему.
Что Scion дала в цифрах
Инфраструктура занимает в 200 раз меньше ресурсов, чем прежние зеркала git, по CPU и памяти. Распаковка кода в CI и исследовательских задачах стала в сто раз быстрее: секунды вместо минут. Только CI высвободил 25% процессорной мощности, а доля попаданий в кеш выше 99% на каждом уровне.
Что оказалось неожиданным
Scion начали писать тогда же, когда внутри стали доступны Claude Mythos Preview и Claude Tag: обе задачи сразу усилили потребность в Scion и ускорили разработку.
Показателен пример с конвейером переноса данных из git в Scion. Первую его версию почти целиком написали вручную, а затем дали Mythos Preview задачу переписать конвейер целиком, без дополнительных инструкций. Результат использовал в 20 раз меньше памяти и работал в 4 раза быстрее, сохранив все неявные договорённости про порядок переноса и структуры данных.
Scion и Antique — систему code review — построили семь человек. Плюс ещё около шести связанных систем. И за пять месяцев мигрировали на них всё, пока дневной объём слитого кода вырос в десять раз.
Инженеры не стали менее ценными, но работа изменилась. Все участники проекта оценивают Claude как более сильного именно в написании кода. Но инженеры давали понимание того, как части системы связаны друг с другом, и понимание архитектурных компромиссов. Очень часто роль инженера сводилась к тому, чтобы сказать Claude «нет»: несколько систем выясняли, когда изменение попало в главную ветку, просто перечитывая журнал коммитов вместо обращения к инструменту code review. Мешал и слишком усердный code review — из-за одной настороженной проверки Claude добавил лишние проверки. Инженеры по-прежнему читают каждый запрос на изменения, но теперь смотрят на замысел, а не перечитывают каждую строку.
Про качество тоже есть что отметить. Scion — один из самых хорошо покрытых тестами кодовых баз, с которыми работала команда: даже в жёсткие сроки удалось собрать изолированные симуляции нетривиальных взаимодействий, добавить фаззинг и ограничение нагрузки. За наблюдением следили отдельные Claude-«суперфанаты», у каждого свой компонент и доступ к телеметрии.
И последнее. В агентном масштабе обычная очередь слияния теряет смысл: если сотни изменений сливаются, пока идут тесты, непонятно, что вообще значит CI. Глобальный репозиторный лок воспроизвести не удалось, поэтому компания вложилась в автоматическое тестирование после слияния и перед выкладкой. Конфликты случаются, но Claude чинит их быстрее, чем люди успевают их заметить.
Что из этого стоит взять
Anthropic прямо говорит, что Scion не замена git для общего пользования. Идеи работают только на очень больших монорепозиториях — на десятках тысяч инженентов или на роях агентов, которые пишут код без остановки. Переход с git потребовал бы переписать весь цикл разработки, включая code review, поиск по коду и CI.
При этом компания считает, что такие проблемы станут обычными в ближайшие 6–12 месяцев, и решать их в одиночку не стоит. Поэтому главный совет такой: переносить в git то, что в Scion сработало, не меняя общую модель. Сервер git не обязан работать так же, как клиент git. Платформы могут отдавать полный набор серверных RPC-вызовов, как Scion, возможно даже в стандартизованном виде, а протокол согласования не обязан выглядеть так, как сегодня.
Git-сообщество почти два десятилетия масштабировало платформу для миллионов разработчиков. Вклад Anthropic — ранний взгляд на то, как агентная разработка с этим сталкивается.