DeepSeek V4.1 Flash против Gemini 3.8 Flash: бенчмарки, цены и что выбрать
Два «флэша» — DeepSeek V4.1 Flash и Gemini 3.8 Flash — вышли с разницей в восемь дней в сентябре 2026 года, и оба вендора называют свои модели рабочей лошадкой для кодинг-агентов. Счёт в общих бенчмарках почти равный, но цена отличается в 2,5–3 раза, а по набору возможностей модели заметно расходятся. Разбираем, чем они отличаются на самом деле и какой выбрать под вашу задачу.
Кто есть кто
Gemini 3.8 Flash Google выпустил 2 сентября 2026 года — это уже третий релиз Flash за шесть недель. Модель «старается больше»: на сложных задачах запускает дополнительные шаги рассуждений и итеративно вызывает инструменты, за что может платить повышенным расходом токенов.
DeepSeek V4.1 Flash вышел 10 сентября 2026 года. Это открытая (лицензия MIT) смесь экспертов на 552B параметров, из которых активны 8B на входе и 16B на выходе. Главная фишка — KV-кэш в 890 байт на токен, примерно вчетверо меньше, чем у предыдущей V4 Flash (3514 байт), — именно отсюда экономия.
| Характеристика | DeepSeek V4.1 Flash | Gemini 3.8 Flash |
|---|---|---|
| Релиз | 10 сентября 2026 | 2 сентября 2026 |
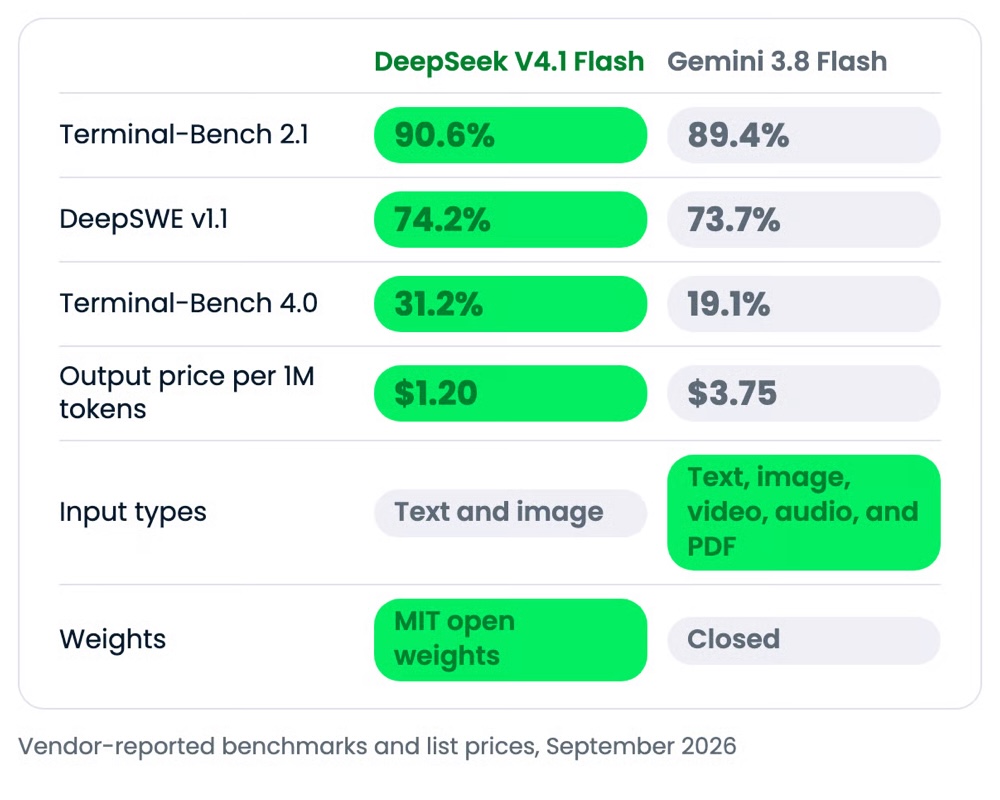
| Веса и лицензия | Открытые, MIT | Закрытые, хостинг |
| Архитектура | 552B MoE, 8B активных на префиле, 16B на декоде | Не раскрыта; на базе Gemini 3.7 Flash |
| Контекст / макс. выход | 1M токенов / 384K | 1M токенов / 64K |
| Входные данные | Текст, изображения | Текст, изображения, видео, аудио, PDF |
Бенчмарки: паритет на общих задачах
По трём агентным кодинг-бенчмаркам, которые публикуют оба вендора, DeepSeek V4.1 Flash выигрывает все три, но два отрыва настолько малы, что их можно считать ничьей:
| Бенчмарк | DeepSeek V4.1 Flash | Gemini 3.8 Flash | Примечание |
|---|---|---|---|
| Terminal-Bench 2.1 | 90,6% | 89,4% | Вендорские прогоны; Claude Opus 5 у обоих — 89,1% |
| DeepSWE v1.1 | 74,2% | 73,7% | Вендорские прогоны; Claude Opus 5 у обоих — 74,0% |
| Terminal-Bench 4.0 | 31,2% | 19,1% | Самый тяжёлый общий набор; Claude Opus 5 — 51,8% |
Пара нюансов:
- Результаты DeepSeek получены на максимальном уровне усилий, который расходует примерно в 2,5 раза больше выходных токенов, чем низкая настройка. По данным техотчёта, уровень 60–80 из 100 восстанавливает большую часть точности при вдвое меньшем расходе — максимум стоит беречь для действительно сложных задач.
- Для терминальных кодинг-агентов модели стоит считать равными и выбирать по цене и способу развёртывания. Заметный отрыв есть только на самых тяжёлых агентных задачах — и это единственное опубликованное преимущество на доске.
Цены: здесь борьбы нет
| Тариф | DeepSeek V4.1 Flash (пик) | Gemini 3.8 Flash (до конца 2026) |
|---|---|---|
| Вход, за 1M токенов | $0,30 | $0,75 |
| Выход, за 1M токенов | $1,20 | $3,75 |
| Чтение кэша, за 1M токенов | $0,006 | $0,075 + $0,50 за час хранения |
| Скидка | Off-peak: −50% вне окон 01:00–04:00 и 06:00–10:00 UTC по будням | Batch или Flex: −50% ($0,375 / $1,875) |
| С 1 января 2027 | Без изменений | $1,50 / $7,50; чтение кэша $0,15 |
Разрыв неоднородный: 2,5x на входе, 3,1x на выходе и 12,5x на чтении кэша. Оба вендора тарифицируют «размышления» по цене выхода, поэтому генерация и рассуждения дорожают быстрее всего.
Примеры реальных нагрузок (по пиковым и вводным ценам соответственно):
| Нагрузка | DeepSeek | Gemini | Разница |
|---|---|---|---|
| Сбалансированный ассистент: 1M входа / 250K выхода | $0,60 | $1,69 | Gemini дороже на 181% |
| Генерация: 1M входа / 4M выхода | $5,10 | $15,75 | Gemini дороже на 209% |
| Кэш-зависимый цикл: префикс 100K, 1000 чтений из кэша | $3,33 | $15,13 | Gemini дороже на 354% |
Кэш — главная развилка: у DeepSeek перечитать 100K-токенный префикс стоит копейки ($0,006 за 1M), а у Gemini те же 100M кэшированных токенов обойдутся в $7,50 плюс плату за хранение. Off-peak у DeepSeek делит все строки пополам, а с 1 января 2027 года все цены Gemini удваиваются — сбалансированный ассистент превратится из $1,69 в $3,38 против неизменных $0,60.
Открытость и развёртывание
DeepSeek V4.1 Flash — единственная из двух моделей, которую можно скачать: веса MIT лежат на https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash. Архитектура — 20-слойный каузальный энкодер, питающий 20-слойный декодер, Compressed Sparse Attention 2 с FP4 KV-кэшем. Но сервинг пока ранний: поддержка в vLLM и SGLang живёт в nightly- и preview-сборках, Transformers ещё не поддерживается. Чекпоинт — около 511 ГБ в 48 шардах, минимальная конфигурация по рецепту vLLM — 614 ГБ VRAM (один узел 8×H200 или трей GB200 NVL4).
Если нужны data residency, on-prem-инференс или fine-tuning — кандидат здесь один. Если хочется нулевой инфраструктуры — проще GA-эндпоинт Gemini.
Мультимодальность, контекст и инструменты
Gemini принимает текст, изображения, видео, аудио и PDF и предлагает хостинговые инструменты, аналогов которым у DeepSeek нет: выполнение кода, grounding на Google Поиск и Карты, file search, URL context и computer use в превью. DeepSeek ограничивается текстом и картинками, зато даёт JSON-выход, вызовы инструментов, Responses API, эндпоинт в формате Anthropic и prefix / fill-in-the-middle дополнение — существующий клиентский код на OpenAI или Anthropic SDK подключается почти без правок.
Обе модели держат контекст 1M токенов, но DeepSeek позволяет выдать до 384K на выходе против 64K у Gemini — шестикратная разница важна для длинной генерации кода и переработки целых документов.
Полевой тест: планировщик репетиций
Автор статьи прогнал через обе модели одинаковую задачу в OpenCode: одностраничное приложение-планировщик репетиций оркестра с детекцией пересечений интервалов и сохранением в localStorage. Ограничения: только чтение и запись файлов, без shell и сети, уровень усилий high, одна попытка, промпт побайтово одинаковый. Нюанс: high — это максимум для Gemini, а у DeepSeek он соответствует 75 из 100.
| Метрика | DeepSeek V4.1 Flash | Gemini 3.8 Flash |
|---|---|---|
| Ходов / вызовов инструментов | 2 / 1 | 4 / 3 |
| Запускаемость | pass | pass |
| Соответствие спецификации | 5 | 4 |
| Логика конфликтов | 5 | 5 |
| Юзабилити и вёрстка | 5 | 4 |
| Средний балл | 5,0 | 4,3 |
Обе решили самую сложную часть — логику пересечений интервалов — корректно: подсветка срабатывала только на реально пересекающиеся брони в одной комнате. Разница оказалась в суждении: DeepSeek написал ровно то, что просили, — один файл на 13 КБ за два хода, а Gemini собрал «маленький продукт» на 76 КБ с фильтрами, редактированием и предзаполненной неделей, и незапрошенная панель статистики сломала раскладку, противоречащую промпту. Вердикт автора: версию Gemini хочется показать менеджеру оркестра, а версию DeepSeek — получить от коллеги.
Это один прогон одной задачи, и он ничего не говорит о расходе токенов и стоимости, но итог согласуется с бенчмарками: на тяжёлых агентных задачах DeepSeek выглядит сильнее.
Что выбрать
DeepSeek V4.1 Flash, если:
- вы гоняете кодинг-агентов в объёме — паритет по Terminal-Bench 2.1 и DeepSWE при цене выхода втрое ниже;
- цикл агента перечитывает большой префикс — 12,5-кратная разница на кэше решает всё;
- нужен self-hosting или fine-tuning — веса MIT уже на Hugging Face, но закладывайте целый узел;
- работа умеет ждать off-peak (минус 50% на всё) или нужны очень длинные выходы: 384K против 64K.
Gemini 3.8 Flash, если:
- на входе аудио, видео или PDF — DeepSeek их просто не принимает;
- нужны хостинговые инструменты без своей обвязки: код, поиск, computer use — всё по одному model ID;
- вы живёте в стеке Google: AI Studio, Gemini Enterprise, Antigravity (там модель уже дефолтная);
- нужны агенты для офисных задач с опубликованными метриками: 61,4% на Vals Finance Agent v2 и 10,0% на Harvey Legal Agent Benchmark — сопоставимых цифр DeepSeek не публикует.
Как начать
API-идентификаторы: deepseek-flash (легаси-имя deepseek-v4-flash тоже резолвится) и gemini-3.8-flash. Оба доступны через OpenRouter. Из кодинг-агентов DeepSeek официально поддерживают OpenCode, WorkBuddy и CodeBuddy плюс собственный DeepSeek Harness; Gemini — дефолт в Antigravity, а также доступен в Android Studio, Stitch, Cursor и OpenCode.
DeepSeek совместим с OpenAI SDK — достаточно сменить base_url:
from openai import OpenAI

client = OpenAI(api_key="YOUR_DEEPSEEK_KEY", base_url="https://api.deepseek.com")
response = client.chat.completions.create(
    model="deepseek-flash",  # DeepSeek V4.1 Flash
    messages=[{"role": "user", "content": "Refactor this function..."}],
)
print(response.choices[0].message.content)
Gemini использует Interactions API из пакета google-genai с настройкой уровня рассуждений вместо параметров сэмплирования:
from google import genai

client = genai.Client()  # reads your Google AI Studio API key
interaction = client.interactions.create(
    model="gemini-3.8-flash",
    input="Refactor this function...",
    generation_config={"thinking_level": "medium"},  # low, medium, or high
)
print(interaction.output_text)
Итог: если ваш профиль — кодинг-агенты, батч-обработка и кэш-зависимые циклы, DeepSeek V4.1 Flash даёт примерно тот же уровень агентного кодинга за треть цены. Если входы мультимодальные или нужны grounding, выполнение кода и computer use с одного хостингового эндпоинта — берите Gemini и закладывайте премию, которая с 2027 года удвоится.