

Grok 4.7: новая флагманская модель SpaceXAI для кодинга по цене Grok 4.6
SpaceXAI выпустила Grok 4.7 — модель, которую компания называет своей самой мощной для кодинга и интеллектуальной работы. Обещание релиза: модель дольше работает над трудными задачами, тщательнее проверяет саму себя и поставляется с лучшим на сегодня набором калиброванных защитных механизмов. При этом стоит она столько же и работает так же быстро, как предыдущая Grok 4.6: $2 за миллион входных токенов и $6 за миллион выходных. Разбираем, что изменилось под капотом, как модель выступила в бенчмарках и где её уже можно попробовать.
Новая база и более длинный RL
Grok 4.7 построена на новой, более крупной базовой модели, чем Grok 4.6. Поверх неё прошёл более длинный этап reinforcement learning на более трудной смеси задач — со смещением веса в сторону проблем, решение которых занимает многие часы. По словам разработчиков, это дало два ключевых навыка: модель стала лучше проверять собственную работу и увереннее обращаться с длинным контекстом.
Оба навыка напрямую относятся к агентским сценариям: чем длиннее сессия и чем больше шагов делает модель, тем дороже обходится каждая ошибка, которую она не заметила сама.
Нативная поддержка harness агента Grok Bot
Второе заметное изменение — Grok 4.7 изначально обучалась понимать harness агента Grok Bot, а не адаптироваться к нему постфактум. SpaceXAI отмечает, что за счёт этого модель сильнее в разговорных задачах и общей интеллектуальной работе: она создавалась не только как «кодер», но и как универсальный исполнитель в агентской среде.
Бенчмарки: код, терминал, электротехника, право
SpaceXAI оценивает модель на тестах, моделирующих длительную агентскую работу, а не короткие вопросы с одним ответом. Ключевые цифры в сравнении с Grok 4.6, GPT-5.6 Sol и Fable 5.1:
| Бенчмарк | Grok 4.7 (xHigh) | Grok 4.6 (High) | GPT-5.6 Sol | Fable 5.1 |
|---|---|---|---|---|
| CursorBench 4.0 — разработка ПО | 46.3% | 40.4% | 41.7% | 51.8% |
| DeepSWE v1.1 — разработка ПО | 71.0%* | 65.2% | 72.7% | 70.0% |
| EEBench — электротехника | 64.0% | 53.0% | 39.4% | 56.4% |
| AA Briefcase v1.1 — многочасовая офисная работа | 1657 | 1546 | 1487 | 1678 |
| Terminal-Bench 4.0 — многочасовая работа в терминале | 38.0% | 20.3% | 37.3% | 57.9% |
| Harvey Legal Agent Benchmark — юридическая работа | 19.6% | 15.8% | 2.5% | 6.7% |
| HealthBench Professional — клинические рассуждения | 56.7% | 48.5% | 60.5% | 62.1% |
* результат в режиме high effort
Цены участников сравнения: Grok 4.7 xHigh и Grok 4.6 High — $2 за миллион входных и $6 за миллион выходных токенов; GPT-5.6 Sol — $4 и $20; Fable 5.1 — $10 и $50. То есть по выходным токенам Grok 4.7 вдвое дешевле GPT-5.6 Sol и впятеро дешевле Fable 5.1.
Что примечательно в результатах:
- Самый большой отрыв от предшественницы — на Terminal-Bench 4.0: 38.0% против 20.3% у Grok 4.6, почти двукратный рост на многочасовой работе в терминале.
- На EEBench, бенчмарке по электротехнике, Grok 4.7 набирает 64.0% — лучший результат среди всей четвёрки.
- На DeepSWE v1.1 модель показывает 71.0% в режиме high effort — на уровне Fable 5.1 (70.0%) и вплотную к GPT-5.6 Sol (72.7%).
- На юридическом Harvey Legal Agent Benchmark — 19.6%, далеко впереди остальных, хотя абсолютные значения у всех участников невысоки.
- На AA Briefcase v1.1 Grok 4.7 набирает 1657 баллов — между Fable 5.1 (1678) и остальными участниками.
Фронтир по цене за задачу
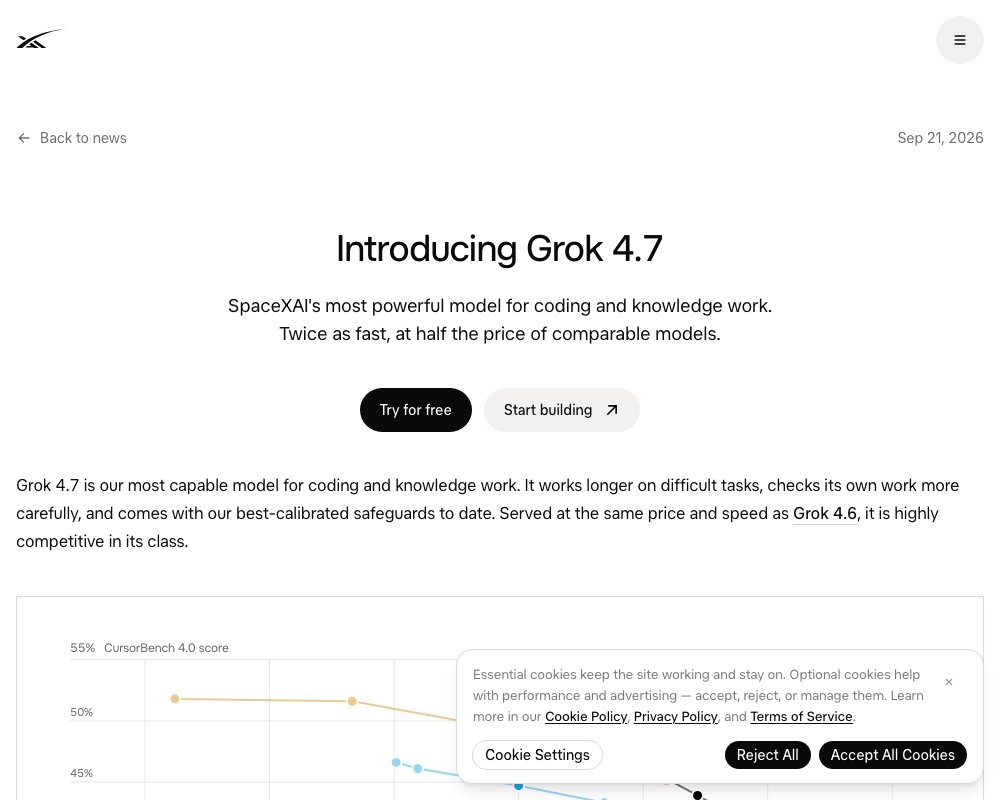
«Сырой» балл на CursorBench 4.0 — тесте, который нагружает модель длинными кодинг-задачами, — у Grok 4.7 ниже, чем у Fable 5.1: 46.3% против 51.8%. Но SpaceXAI делает акцент на другом: на графике соотношения балла и средней стоимости одной задачи (диапазон от $0 до $18) Grok 4.7 оказывается на фронтире вместе с Fable 5.1, Opus 5, GPT-5.6 Sol и Sonnet 5 — выше по баллу и дешевле за задачу, чем большинство конкурентов в своей ценовой категории.
Для агентских кодинг-сценариев, где счёт задач идёт на сотни и тысячи, именно цена за задачу, а не пик качества, определяет итоговый счёт — и на этой оси новая модель позиционируется особенно агрессивно.
Профессиональная работа и рейтинг GDPval
Grok 4.7 заметно прибавила в создании документов и презентаций. В GDPval и AA Briefcase модели дают задачи, которые выполняют реальные профессионалы: юристы, медсёстры, финансовые аналитики. На обоих тестах Grok 4.7 улучшает результаты Grok 4.6 и выступает на уровне других фронтирных моделей.
В рейтинге GDPval по Elo Grok 4.7 в режиме xhigh получает 1695 баллов: позади Fable 5.1 в максимальном режиме (1735), но впереди Grok 4.6 (1605) и GPT-6 Astra (1542). На HealthBench Professional — тесте клинических рассуждений — результат скромнее: 56.7% против 62.1% у Fable 5.1.
Безопасность: новый стек защит
Grok 4.7 построена с полностью новым стеком защитных механизмов. По заявлениям SpaceXAI, это самая сильная модель компании по отказам от опасных запросов и устойчивости к джейлбрейкам.
В dual-use доменах — кибербезопасности и работе с биологией — модель лидирует одновременно по полезности для легитимных задач и по безопасным отказам на опасных: на бенчмарке биобезопасности LatchBio она набирает 62.4%.
В кибербезопасности баланс смещён в сторону низкого числа ложных блокировок. На HackerBench v0.3 — бенчмарке рискованных и вредоносных кибер-задач — Grok 4.7 показывает лучший результат по безопасности: пропускает лишь 3.3% рискованных dual-use промптов и при этом редко блокирует легитимную работу специалистов по безопасности.
Параллельно SpaceXAI начала давать избранным кибер-партнёрам доступ по приглашению к возможностям red team модели — для исследований в области защиты.
Цены и доступность
Grok 4.7 доступна с сегодняшнего дня в Cursor и Grok Build, а также через Grok API, сторонние кодинг-харнессы, роутеры моделей и облачные платформы.
Тарификация стартует с $2 за миллион входных токенов и $6 за миллион выходных. Есть и быстрая вариация: вдвое выше скорость генерации при вдвое большей цене.
$ curl -fsSL https://x.ai/cli/install.sh | bashДокументация — на https://docs.x.ai, ключи API создаются в консоли https://console.x.ai.
Итог
Grok 4.7 — это ставка на качество-в-пересчёте-на-цену: уровень фронтира по большинству агентских бенчмарков, цена предыдущего поколения SpaceXAI и лучшая в линейке калибровка безопасности. Так как цена и скорость совпадают с Grok 4.6, переход для существующих пользователей выглядит малозатратным, а главный вопрос — удастся ли удержать заявленную надёжность на многочасовых задачах — проверяется только в реальных проектах.
Источник: https://x.ai/news/grok-4-7