Горячий prefix-кэш vLLM между ходами агента: с 55% до 95% попаданий
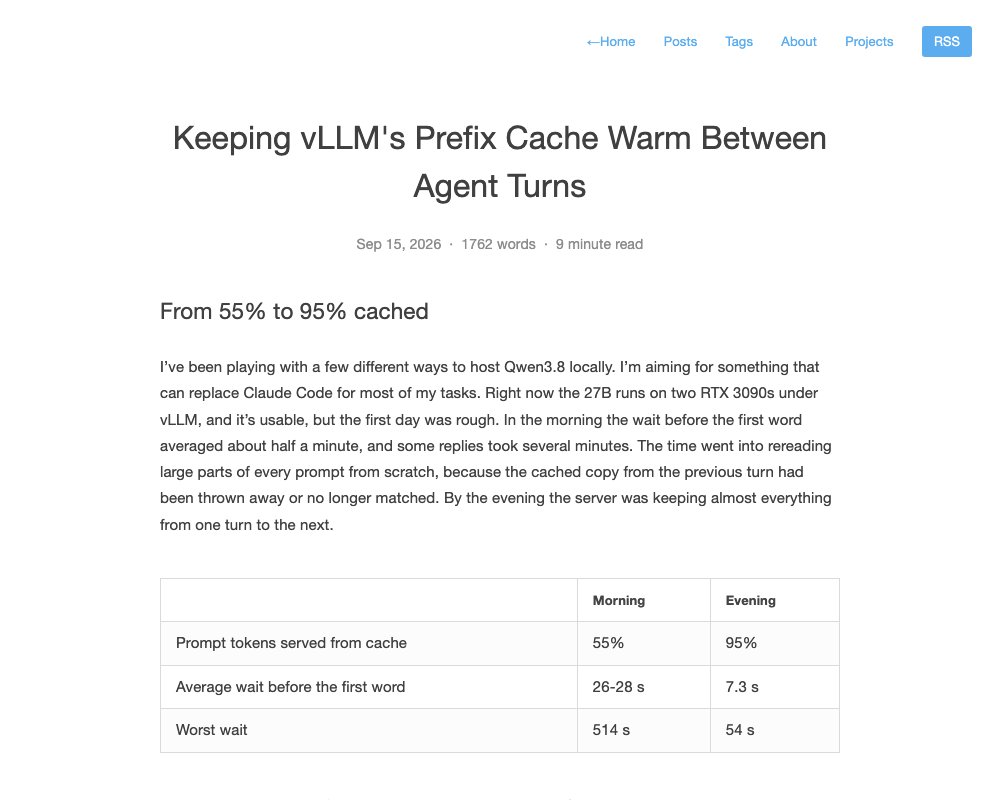
Автор месяц хостил Qwen3.8-27B локально на двух RTX 3090 под vLLM, пытаясь собрать замену Claude Code для повседневных задач. Первое утро было тяжёлым: в среднем полминуты до первого слова ответа, отдельные ответы — по несколько минут. К вечеру того же дня сервер отдавал почти всё из кэша, среднее ожидание упало до 7,3 секунды, а худшее — с 514 до 54 секунд.
| Метрика | Утро | Вечер |
|---|---|---|
| Prompt-токены из кэша | 55% | 95% |
| Среднее ожидание первого слова | 26–28 с | 7,3 с |
| Худшее ожидание | 514 с | 54 с |
Кодинг-агент resend'ит всю переписку каждый ход. Чтение идёт на 700–900 токенов в секунду на запрос, поэтому 120 000 токенов с нуля — это около 150 секунд ожидания. Если же сервер сохранил KV-кэш прошлого хода, ему остаётся прочитать пару тысяч новых токенов, и старт занимает 3 секунды.
Стек и настройки
Связка: oh-my-pi как агент, Bifrost как LLM-шлюз с агрегацией MCP-серверов, vLLM 0.28.0 с W4A16 AutoRound-квантом на двух карточках:
--tensor-parallel-size 2 --max-model-len 262144 --max-num-seqs 16
--max-num-batched-tokens 8192 --long-prefill-token-threshold 2048
--kv-transfer-config '{"kv_connector":"OffloadingConnector", ...}'
По пути автор также перешёл с реплики на каждой карте на tensor parallelism, ограничил thinking 6 000 токенами, поменял batch-бюджет и включил speculative decoding и CPU offload.
Что сервер хранит и где
GPU prefix-кэш хранит результаты чтения токенов, индексируя их по хэшу каждого блока вместе со всеми предыдущими. Lookup идёт с начала промпта и останавливается на первом несовпавшем блоке. Кэш матчит префикс, а не диффит промпты: изменение на токене 12 000 из 120 000 выбрасывает 108 000 токенов готовой работы.
CPU-тир копирует вытесненные из видеопамяти блоки в host RAM (48 GiB в /dev/shm) и возвращает их по требованию. Пока работали две реплики, контексты вытеснялись постоянно, но restore через PCIe возвращал контекст на 42 000 токенов за полсекунды против 24 секунд холодного чтения. После объединения карт restore-ов стало около двух в час. Всё, что не попало ни в один тир, читается заново.
vLLM также документирует filesystem-тир и peer-to-peer коннектор — автор рассматривал их для шаринга KV между репликами, но объединение карт сняло саму потребность. К тому же filesystem-тир ничего не вытесняет.
Как измерять
Смотреть нужно prompt_tokens_cached_total / prompt_tokens_total — долю prompt-токенов, которые серверу не пришлось читать. Счётчик GPU-попаданий сам по себе выглядел здоровым в то самое утро, когда доля была 55%.
Что меняет гибридная модель
Qwen3.8-27B — гибрид: большинство слоёв используют вариант linear attention с небольшим фиксированным состоянием вместо растущего с промптом KV-кэша. vLLM может возобновить такие слои только из сохранённой копии состояния, а сохраняет её лишь там, где prefill-шаг заканчивается на границе 2048 токенов. На этой модели кэш работает блоками по 2048 токенов вместо обычных 16.
Блок в 2048 токенов меняет и планировщик: запрос с меньшим остатком batch-бюджета в шаге не получает ничего, и очередь за ним не рассматривается. С --max-num-batched-tokens 4096 длинные запросы простаивали в очереди за одним prefill. Значение 8192 с --long-prefill-token-threshold 2048 помещает в шаг три-четыре чанка prefill вместо одного; больший бюджет вызывал ступоры декодинга на 13–19 секунд за шаг.
Те же сохранённые состояния — причина, почему CPU-тир перестал помогать: vLLM держит лишь несколько состояний на разговор (в основном то, где кончился последний запрос). Следующий ход стартует ровно оттуда, и его обслуживает GPU-кэш; restore из RAM помогает редко, потому что сохранённого состояния на границе восстановленных блоков обычно уже нет. За час агентного трафика на объединённой конфигурации: скопировано в RAM ~40 GB в ~700 копиях, восстановлено ~250 MB в 2 restore-ах, из ~800 000 запрошенных токенов отдано из кэша 12 000 (1,5%). Цена — ~9 секунд копирования и 48 GiB RAM. Автор оставляет тиры включённым, потому что стоит он дёшево, но на этой модели много сделать не может.
Что ломает префикс
Шафлящиеся ключи в схемах инструментов
Периодически ход приходил с 2–25% кэша и 90–180 секундами чтения — на простаивающем движке с почти пустым KV-пулом, при промпте на 94–96% идентичном предыдущему. Реплей пар ходов из захвата трафика против простаивающего сервера воспроизвёл промахи — значит, дело не в eviction. Токенизация и дифф показали: промпты совпадали ровно 12 622 токена, затем расходились внутри определений инструментов. Четыре MCP-инструмента приходили с ключами parameter-схемы в другом порядке — на 8% пар последовательных ходов. После сортировки схемы были идентичны.
Источник — шлюз: mcp-go декодирует список инструментов в Go map без порядка ключей, а Bifrost выводит её обратно через range, который Go намеренно рандомизирует. Bifrost обновляет список инструментов каждые 10 минут, поэтому порядок менялся с интервалами, кратными 10 минутам. Поскольку Qwen-шаблон рендерит определения инструментов в начале system-хода, один шафл инвалидовал всё после себя.
Оба фикса отправлены и влиты: bifrost#7170 сортирует ключи при конверсии, mcp-go#984 сохраняет порядок ключей при декодировании. Временный обходной путь — правка chat-шаблона:
tool.function.parameters | tojson(sort_keys=True)Всё остальное подняло кэш с 55% до 78%; эта правка шаблона сама по себе — до 95%, а среднее ожидание — с 21 до 7,3 секунды. Хостед-API матчат байт-идентичный префикс, включающий блок инструментов, так что тот же баг шлюза стоил бы скидки за кэшированное чтение и там.
Живой статус-текст в начале промпта
oh-my-pi перечисляет состояния сабагентов (running, idle, parked) примерно на 29 000 символов в system-промпте — каждое изменение состояния инвалидовало промпт главного агента от этой точки. После 24-минутного запуска сабагента главный агент вернулся к промпту на 150 000 токенов с 14% кэша. Блок захардкожен в шаблоне промпта, фикс — апстриму.
Компакция
Когда разговор становится слишком длинным, агент заменяет старую историю сводкой. Сводка меняет промпт, значит ход после компакции читает всё заново. Единственный рычаг — частота: сообщить агенту реальное окно контекста и поднять порог.
Per-agent текст перед общим
Промпт каждого сабагента содержит собственный id и список пиров примерно на двух третях system-промпта, поэтому сиблинги делят лишь первые 60–70% префикса. Главный агент и сабагенты перечисляют инструменты в разном порядке и расходятся. Если бы общие части (определения инструментов и базовые инструкции) шли первыми, а per-agent — последними, все агенты делили бы одинаковые первые ~15 000 токенов.
Что не ломает
Дописывание результатов инструментов — основная часть агентного трафика — расширяет префикс и оставляет всё до него кэшированным.
Бенчмаркуйте с тем кэшем, с которым будете жить
Speculative decoding утром выглядел плохо: запись ускорялась вдвое (63 против 27 токенов в секунду), но медленное чтение заставляло перекрывающиеся запросы стоять в очереди, и медианное ожидание росло с 29 до 121 секунды. При 95% кэша читать почти нечего — и режим стал лучшим: 24–32 токена в секунду на запрос против ~22 при более коротком ожидании.
Чеклист
- Измеряйте долю prompt-токенов из кэша, а не количество cache-попаданий.
- Когда ход медленный, токенизируйте его и предыдущий и найдите первый различающийся токен.
- Прежде чем винить eviction, воспроизведите промах на простаивающем сервере.
- Сериализуйте всё, что попадает в промпт, одинаково каждый раз. Сортируйте JSON-ключи.
- Располагайте меняющиеся части промпта в конце: инструменты и фиксированные инструкции — вначале, затем история, затем per-agent и живой текст.
- Компактуйте так редко, как позволяет агент.
- Указывайте cache hit rate рядом с любым бенчмарк-числом.