XERJ — локальная поисковая система и MCP-сервер для AI-агентов
📂 Исходный код на GitHubЛокальная поисковая система и MCP-сервер для AI-агентов: один бинарник на Rust индексирует код, документы, логи, JSONL/CSV и PDF (BM25, векторный и гибридный поиск, AST-индексация через tree-sitter, долговременная память агента) за Elasticsearch-совместимым API. Работает с Claude Code, Cursor и любым MCP-клиентом.
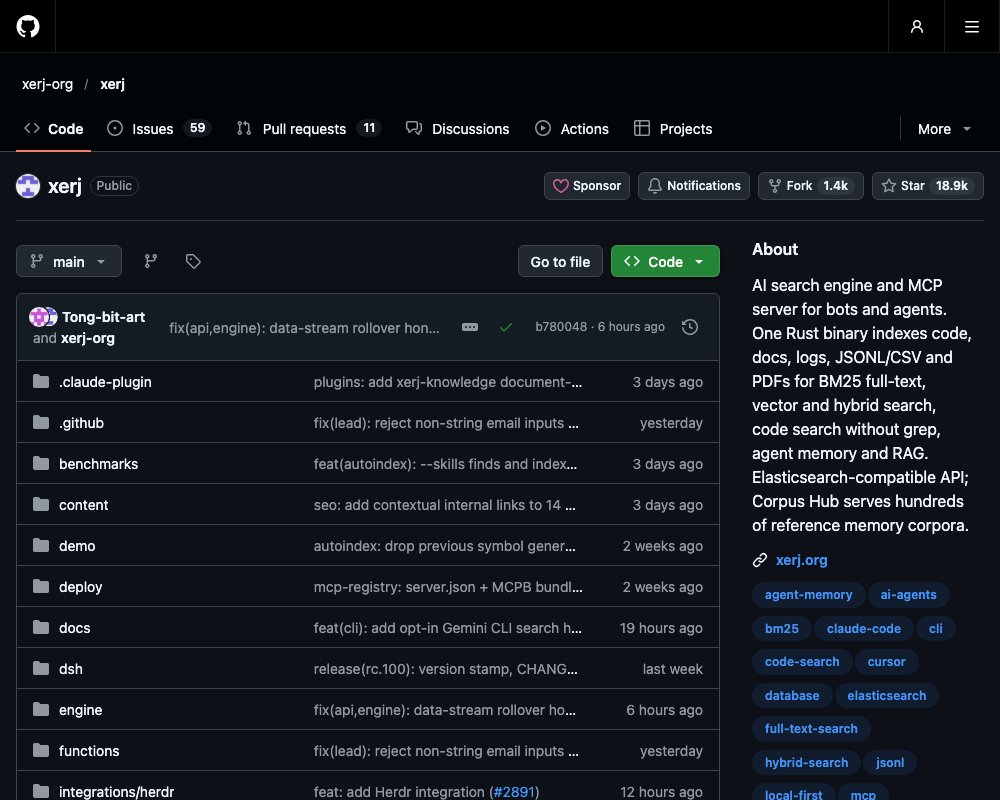
XERJ — поисковая система для AI-агентов, которая целиком живёт на вашей машине. Это один статический бинарник на Rust: он индексирует код, документацию, спецификации, логи, JSONL/CSV и PDF, а агент запрашивает у него точные фрагменты с указанием file:line вместо того, чтобы читать файлы по одному и сжигать контекстное окно. Наружу смотрит Elasticsearch-совместимый API, поэтому подходят готовые клиенты, дашборды и инструменты. Есть полнотекстовый поиск на BM25, векторный и гибридный поиск, поиск по коду и долговременная память агента. Подключается к Claude Code, Cursor и любому другому MCP-клиенту. Лицензия — Apache 2.0, проект собрал 18,9 тысячи звёзд на GitHub.
Зачем это нужно
Агент, который работает «по памяти», зацикливается на любом API, который модель не выучила наизусть. Агент, который работает через grep, получает строку-совпадение, а чтобы понять её смысл, всё равно открывает файл целиком. В измерениях авторов проекта PHP-ядро WordPress — это около 5,2 миллиона токенов, то есть 26 полных контекстных окон: прочитать такое агент просто не может. Запрос к индексу стоит килобайты: в одном кейсе агент проверял безопасность 1492 PHP-файлов примерно за 26 тысяч токенов — это полпроцента дерева.
Референс-кодинг: главный сценарий с измеренным эффектом
Основной сценарий называется референс-кодинг (reference coding). Агент клонирует open-source-проекты, ближайшие к вашей задаче, индексирует их и перед написанием своего кода подсматривает, как ту же задачу уже решили другие. В контролируемом исследовании на коде, который модель точно не помнила (8 задач, 4 языка, 16 прогонов на каждую конфигурацию, реальные счётчики токенов claude -p), получилось так:
| Конфигурация | Выходные токены | Стоимость | Решено |
|---|---|---|---|
| Только память модели | 260 916 | $11,18 | 11/16 |
| Агент на grep | 26 477 | $3,27 | 16/16 |
| XERJ | 9 982 | $1,58 | 16/16 |
Это в 2,7 раза меньше выходных токенов, чем у агента на grep, и в 26 раз меньше, чем при работе по памяти, — при одинаковом проценте решённых задач. В реальной разработке пользователи в отчётах называют примерно пятикратную экономию. Честная граница применимости: выигрыш зависит от того, помнит ли модель код. На приватном, внутреннем, нишевом или вышедшем после даты обучения коде XERJ выигрывает, а на популярных публичных библиотеках, которые модель уже знает, нейтрален или даже вреден.
Индексация любой папки одной командой
Команда xerj autoindex <folder> превращает любую папку в набор типизированных поисковых индексов. Схему писать не нужно, конвейер настраивать не нужно: инструмент сам определяет тип каждого файла и создаёт по индексу на каждый найденный набор данных. Исходный код разбирается через tree-sitter, поэтому в индекс попадают символы и номера строк, а не плоский текст.
Поддерживаются форматы CSV, JSON, JSONL, XML, YAML, SQLite, PDF, DOCX, PowerPoint, Excel, EPUB, Jupyter-ноутбуки, man-страницы, HTML, почта (.eml и mbox, включая экспорт Google Takeout) и распространённые форматы логов. Unity-проекты обрабатываются отдельно: текстовые сцены, префабы и ассеты превращаются в записи по одному GameObject или Component, а .meta-файлы — в таблицу соответствия GUID и пути. Реиндексация инкрементальна: файл, не изменившийся с прошлой индексации, пропускается, поэтому повторный запуск после правки нескольких файлов работает только с изменениями.
Поиск через Elasticsearch API
API совместим с Elasticsearch: работают _cat, _search, bulk, агрегации, kNN, scroll, reindex. Набор тестов на соответствие API прогоняется на каждом коммите и сейчас проходит 1444 случая из 1454. В бенчмарках против Elasticsearch 8.13.4 последний прогон дал 55 побед, 26 ничьих и 4 поражения: пропускная способность записи выше в 1,72 раза, размер на диске меньше в 1,61 раза. Все четыре поражения — это p99 чтения под высокой записью, и этот разрыв документирован, а не спрятан.
Векторный и гибридный поиск используют тот же синтаксис knn и semantic, что и Elasticsearch. По желанию результаты можно переупорядочить внешним сервисом Jev (выключено по умолчанию, отправляет текст результатов на сторонний сервер), либо решить ту же задачу локально через POST /_decide — по размеченным примерам, ничего не покидает машину.
MCP-сервер и подключение агентов
Тот же самый бинарник — это ещё и MCP-сервер. Команда xerj mcp поднимает stdio-сервер, который проксирует запросы к узлу из переменной XERJ_URL (по умолчанию http://localhost:9200):
{
  "mcpServers": {
    "xerj": {
      "command": "/home/you/.local/bin/xerj",
      "args": ["mcp"],
      "env": { "XERJ_URL": "http://localhost:9200" }
    }
  }
}
В документации перечислены конфигурации для 26 клиентов: OpenCode, Claude Code, Cursor, Codex, Gemini CLI, Cline, Roo Code, Continue, Zed, JetBrains AI Assistant, Goose, Warp и другие. Пять интеграций проверены вручную, включая OpenCode, Claude Code, Cline и Kimi CLI. Через MCP доступно 23 инструмента: xerj_search, xerj_semantic_search, xerj_vector_search, xerj_hybrid_search, xerj_memory_store и xerj_memory_recall, xerj_def для поиска определений, xerj_code_search для референс-кодинга, инструменты графовой «второй памяти» и другие.
Память агента
Эндпоинт /_memory/{namespace} хранит то, чему агент научился в ходе работы, и на следующей сессии возвращает записи по смыслу, а не по точному совпадению. Поверх этого есть слой связей («второй мозг»): граф над проиндексированными документами с проверкой каждой связи на доказательства.
Установка и модель безопасности
curl -fsSL https://xerj.org/get | sh
xerj --insecure --data-dir ~/xerj-data &
xerj autoindex ~/my-project
xerj search "how do we rotate the WAL segment"
xerj gain
Есть установщики для Windows PowerShell и Nix. Готовые сборки — Linux, macOS, Windows на x86-64 и arm64, без JVM и без зависимостей. Флаг --insecure — это граница доверия, а не формальность: он отключает TLS и авторизацию по API-ключу, поэтому годится только для одного пользователя на dev-машине. Свежий узел слушает только 127.0.0.1, а на других интерфейсах в открытом виде просто не стартует. Полная модель безопасности описана в docs/SECURITY_MODEL.md.
Модель сообщества
Бинарник бесплатный, а взамен проект просит одно: короткий отчёт о том, как всё прошло — один коммит или PR с файлом под user-feedback/16-agent-field-reports/. Отчёты принимаются и от людей, и от агентов, негативный вердикт считается нормальным отчётом, а такие PR освобождены от подписи CLA. Рецепты под каждый сценарий собраны в документации, агенту для самостоятельной настройки достаточно скормить llms.txt.
Подробности исследования референс-кодинга и его ограничения — в кейс-стади на сайте проекта, примеры экономии токенов из полевых отчётов — здесь.
Источник: https://github.com/xerj-org/xerj