

Hippo — биологически вдохновлённая память для AI-агентов
📂 Исходный код на GitHubHippo — локальный слой памяти для AI-агентов, построенный по мотивам гиппокампа. Он хранит память в SQLite, добавляет затухание, усиление при retrieval, outcome feedback, консолидацию и provenance, поддерживает импорт из разных инструментов и предоставляет CLI и MCP-сервер.
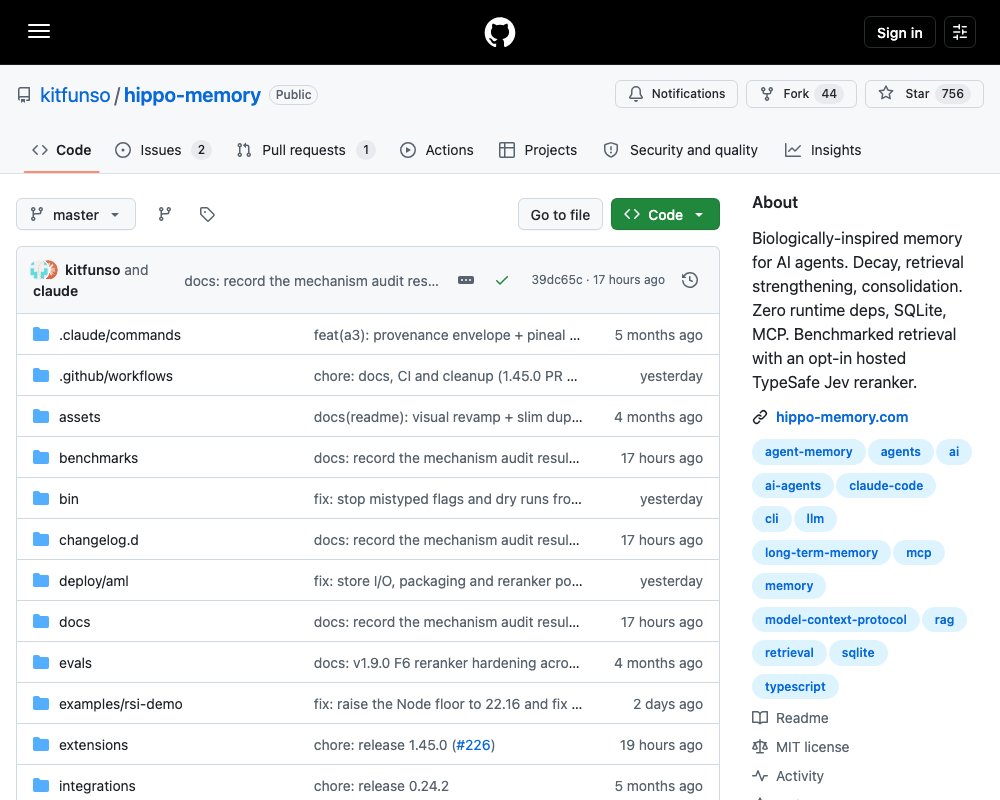
Hippo — это не кодинг-агент и не коллекция Agent Skills, а отдельный слой памяти для агентов. Он решает проблему, которая хорошо знакома разработчикам: агент может каждый раз заново находить один и тот же deploy bug, потому что инструмент хранит факты, но не знает, какие из них по-прежнему актуальны. Вместо бесконечного накопления записей Hippo моделирует жизненный цикл памяти: слабые воспоминания затухают, повторное использование укрепляет их, а важные ошибки сохраняются дольше обычных наблюдений.
Проект работает поверх SQLite, не требует runtime dependencies и поддерживает Node.js 22.16+. В базовой конфигурации не нужны embeddings или внешние API: при желании embeddings можно добавить отдельно через локальный Transformers.js либо opt-in API embedder. Подробности экспериментов и результатов авторы собрали в каталоге evals.
Как устроена память
Hippo разделяет память на три уровня:
- Buffer — краткосрочный рабочий буфер для новой информации сессии.
- Episodic store — записи с временными метками, тегами и историей использования. Они по умолчанию затухают, но retrieval усиливает их.
- Semantic store — более стабильные паттерны, собранные из повторяющихся эпизодов.
Хранилище находится в .hippo/hippo.db. Markdown-файлы и index.json выступают зеркалами данных, но с версии 1.46.0 индекс обновляется не после каждой записи, а только при явном export. Для обычного чтения README рекомендует использовать CLI, MCP-сервер или HTTP API.
У каждой записи есть half-life и provenance. По умолчанию срок жизни составляет семь дней, но это не жёсткий срок удаления: hippo sleep выполняет decay, merge и prune. Каждый recall увеличивает half-life на два дня и пересчитывает силу записи. Ошибку можно сохранить с флагом --error: такие воспоминания получают удвоенный half-life, поэтому production incident не исчезает так же быстро, как случайная заметка.
Команда hippo sleep объединяет не менее трёх связанных episodic records в одну semantic memory. После этого исходные записи постепенно затухают, а выявленный паттерн сохраняется. Это не просто очистка базы: консолидация превращает повторяющийся опыт в более компактное знание.
Не только долговременная память
В Hippo есть несколько уровней continuity для работы над длинными задачами:
- Active snapshot хранит текущую задачу, краткое резюме, следующий шаг и связанные артефакты.
hippo context --autoсначала добавляет snapshot, а затем долговременные записи. - Session events сохраняют короткий след событий текущей сессии и связывают его со snapshot. Последний след дублируется в
.hippo/buffer/recent-session.md. - Handoff описывает завершённую часть работы и точку продолжения.
hippo session resumeснова добавляет последний handoff в контекст. - Working memory — ограниченный scratchpad для текущего состояния. В одном scope хранится максимум 20 записей; при переполнении вытесняется запись с наименьшей важностью.
Такой набор полезен, когда агент переключается между инструментами или продолжает задачу после compaction. Переход с Claude Code на Cursor, Codex или OpenCode не требует переносить память вручную: все они могут использовать один и тот же store проекта.
Recall, который можно объяснить
Основной сценарий работы состоит из нескольких команд:
hippo remember "FRED cache silently dropped the tips_10y series" --tag error
hippo recall "data pipeline issues" --budget 2000
hippo recall ранжирует результаты по релевантности, силе и свежести, а --budget ограничивает объём результата. Команда --why показывает, почему запись попала в выборку: например, совпадения BM25 и cosine score. Для программного использования доступен JSON-вывод.
У памяти есть уровни уверенности: verified, observed, inferred и stale. Они позволяют агенту понимать, где документация подтверждает факт, где он видел поведение, где сделал предположение, а где запись устарела. По умолчанию контекст оформляется как наблюдение, а не как безусловная инструкция. Режимы suggest и assert меняют формулировку на более директивную.
Отдельный цикл hippo outcome --good или hippo outcome --bad сообщает, помогли ли извлечённые записи. Положительный feedback увеличивает reward factor и замедляет decay, отрицательный — ускоряет. Конфликтующие утверждения не скрываются автоматически: hippo sleep обновляет список конфликтов, а hippo conflicts и hippo resolve позволяют их проверить и разрешить.
Импорт и автоматическое обучение
Hippo не привязывает память к одному harness. Импортировать можно экспорт памяти ChatGPT, CLAUDE.md, Cursor rules, обычный Markdown или произвольный текстовый файл. Для импорта поддерживаются --dry-run, --global и --tag; дубликаты обнаруживаются автоматически.
Отдельный hippo capture извлекает из разговора решения, правила, ошибки и предпочтения без LLM. Сырой текст можно передать через stdin или указать файл. Для записи изменений из Git есть hippo learn --git: команда просматривает commit history, выделяет уроки из fix, revert и bug commits, удаляет дубликаты и сохраняет новые записи. Есть и hippo watch, который запускает другую команду и автоматически запоминает ошибки.
Для архитектурных решений доступен hippo decide. Такие записи получают 90-дневный half-life и confidence verified. Если решение меняется, новую запись можно связать с предыдущей через --supersedes, а старую пометить как устаревшую.
Подключение к агентам
Быстрый старт для одного проекта:
npm install -g hippo-memory
hippo init
Для всех git-репозиториев в домашней директории используется hippo init --scan ~. Команда создаёт .hippo/ в найденных проектах, извлекает уроки из последних 30 дней истории и регистрирует workspace. Автоматическая интеграция работает с Claude Code, Codex, Cursor, OpenClaw, OpenCode, Pi и другими CLI-агентами; при необходимости hooks и расписание можно отключить флагами --no-hooks и --no-schedule.
Для MCP-клиента запускается stdio-сервер:
hippo mcpПосле подключения доступны инструменты hippo_recall, hippo_remember, hippo_outcome, hippo_context, hippo_status, hippo_learn и hippo_wm_push. Поэтому Hippo можно использовать не только как проектный слой памяти, но и как единый backend для нескольких агентных интерфейсов.
У OpenClaw есть отдельный plugin, а сценарий установки описан в интеграционной документации. Для OpenCode и других harness добавляются hooks, которые загружают контекст в начале сессии, сохраняют ошибки и отмечают успешное завершение задачи.
Что показывают бенчмарки
README приводит несколько измерений, но важно учитывать их контекст. В текущем описании проекта приведены результаты LongMemEval на split _s: 98.0% R@5 с опциональным локальным MiniLM embedder и 99.8% с платным Voyage. На более старом pooled oracle-split для Hippo v0.28 указано 73.8% R@5 при hybrid BM25 + cosine. Эти числа относятся к разным протоколам, поэтому их нельзя напрямую сравнивать.
Для retrieval без embeddings авторы также указывают 74.0% R@5 на LongMemEval в версии BM25-only. В отдельном staged Slack-корпусе Hippo выигрывает transcript replay в 10 из 10 incident scenarios. При этом README прямо помечает magnitude sequential learning benchmark как retracted: механизм goal stack по-прежнему доступен, но прежняя величина эффекта не воспроизводится.
Отдельно описан opt-in reranker Jev: он улучшает ранжирование на приватном наборе из 300 запросов, но не показал лучший answer rate на трёх graded tests. Это полезный пример того, почто для memory-систем важно разделять качество retrieval, качество ответа и стоимость контекста.
Итог
Hippo интересен как инфраструктурный слой для AI-кодинга: локальное SQLite-хранилище, переносимость между агентами, provenance, decay, consolidation, MCP и hooks для автоматического поведения. Это не универсальная замена RAG и не самостоятельный coding agent. Его сильная сторона — жизненный цикл памяти: сохранять не всё, а то, что продолжает быть полезным, и забывать устаревшее, не теряя пользовательский контроль над данными. Для этого разработчики ведут отдельный журнал релизов и публикуют протоколы evals вместе с неудачными экспериментами.
Источник: https://github.com/kitfunso/hippo-memory