

AI Second Brain — самообслуживаемая база знаний для Claude Code и Obsidian
📂 Исходный код на GitHubПолное руководство по созданию самообслуживаемой базы знаний: стартовый Obsidian vault, 18 Claude Code skills, команды, субагенты и скрипты для организации материалов и связей между ними.
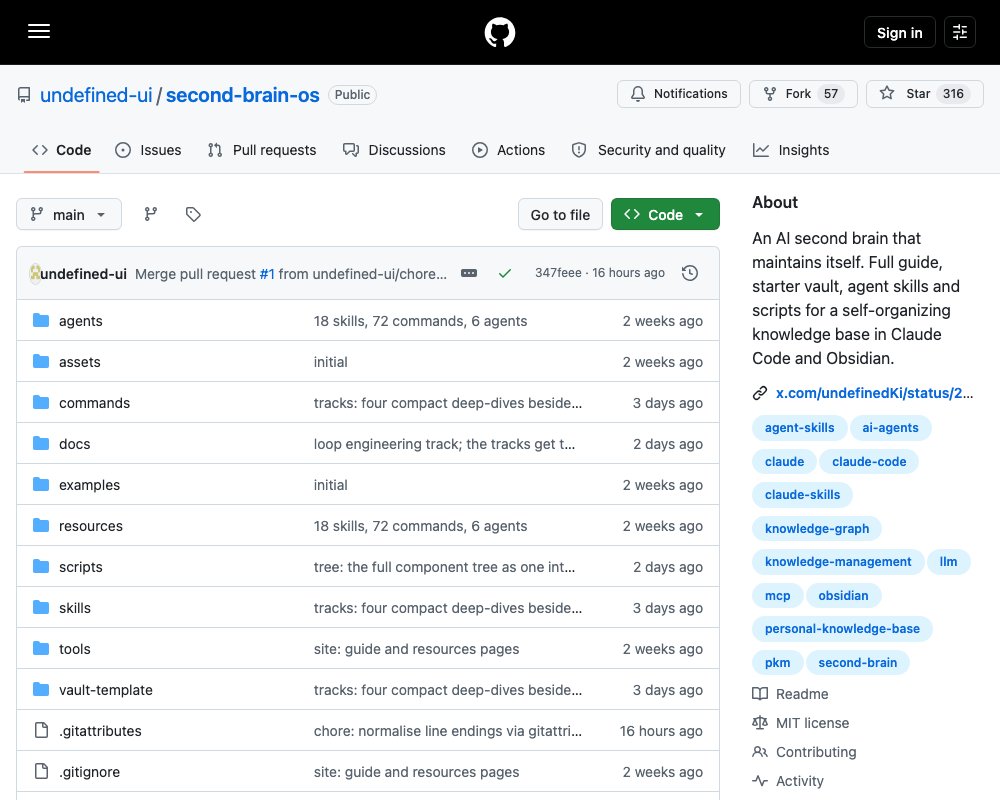
AI Second Brain — это набор инструкций, skills и готовых шаблонов для базы знаний, которую AI-агент создаёт и поддерживает сам. Пользователь сохраняет статьи, расшифровки, PDF и экспорт чатов в raw, а агент превращает их в связанные wiki-страницы. Всё хранится в обычных Markdown-файлах, которыми владеет пользователь; Obsidian нужен для просмотра графа, но не является обязательным серверным компонентом.
Какую проблему решает
Закладки, скриншоты, read-later-списки и заметки накапливаются, но не складываются в связанную систему. Материал нужно вручную разложить по папкам, придумать названия и связать с уже сохранёнными идеями. Как только рутина становится скучной, база знаний перестаёт использоваться.
AI Second Brain передаёт эту работу агенту. Пользователь приносит исходные данные, а агент извлекает идеи, создаёт страницы, добавляет wikilinks, обновляет существующие заметки и проверяет результат. Так база должна становиться не только больше, но и полезнее по мере накопления материала.
Как устроена система
Рабочий поток разделён на три части:
вы                    raw/                 agent                 wiki/
┌───────┐          ┌──────────────┐      ┌────────────┐      ┌──────────────┐
│ clip  │  ──────> │ articles     │ ───> │  ingest    │ ───> │ sources/     │
│ save  │          │ transcripts  │      │  extract   │      │ concepts/    │
│ dump  │          │ pdfs         │      │  link      │      │ entities/    │
└───────┘          │ chat exports │      │  lint      │      │ synthesis/   │
                    └──────────────┘      └────────────┘      └──────────────┘
                                                │
                                                └─ можно задать любой вопрос
raw/ — архив исходных материалов, который не нужно перечитывать вручную. wiki/ — результат работы агента: страницы об источниках, концепциях, сущностях и синтезе. Одна идея описывается на отдельной странице, а новые источники обновляют уже существующие материалы вместо того, чтобы складывать рядом ещё одну копию.
Рядом находится слой проектов. Для каждого проекта создаётся отдельная папка со своим CLAUDE.md и конвейером Inputs / Process / Outputs / Feedback. Вики хранит знания, проекты — то, что пользователь делает сейчас, и эти два слоя постоянно обмениваются контекстом. Подробнее об этом разделении — в описании двух слоёв.
Что находится в репозитории
Репозиторий называется full version, потому что в нём собраны не только примеры заметок, но и полный набор материалов для практики:
| Каталог | Содержимое |
|---|---|
docs/ |
Руководство из десяти разделов и 77 страниц: от идеи до troubleshooting |
docs/track-*/ |
Пять компактных треков по knowledge graphs, Jev, harnesses, loops и evals |
vault-template/ |
Стартовый vault со структурой wiki, project pipeline, CLAUDE.md и шаблонами страниц |
skills/ |
18 agent skills — по одному для основных рабочих процессов |
commands/ |
72 slash-команды как scoped entry points в skills |
agents/ |
Шесть субагентов, четыре из которых по замыслу read-only |
scripts/ |
Python без внешних зависимостей для проверки ссылок, статистики и экспорта графа |
resources/ |
Инструменты, репозитории, статьи и материалы для чтения |
examples/ |
Примеры реальных vault и результатов агента |
Сами skills описаны в каталоге skills. Это не один узкий сценарий, а набор рабочих процессов: импорт backfill и чатов, ingest, query, review, lint, graph, project, publish, privacy, transcript и другие. В репозитории особенно выделены second-brain-ingest и second-brain-query: первый связывает новый материал с существующими страницами, второй помогает искать ответы по всему vault.
Быстрый старт
Репозиторий содержит готовый сценарий на один вечер. Для macOS и Linux он выглядит так:
git clone https://github.com/undefined-ui/second-brain-os.git
cp -r second-brain-os/vault-template ~/brain

mkdir -p ~/brain/.claude
cp -r second-brain-os/skills   ~/brain/.claude/skills
cp -r second-brain-os/commands ~/brain/.claude/commands
cp -r second-brain-os/agents   ~/brain/.claude/agents
cp -r second-brain-os/scripts  ~/brain/scripts

rm ~/brain/.claude/*/README.md ~/brain/scripts/README.md

cd ~/brain && claude
Копия scripts/ нужна, чтобы команды /metrics, /health и /graph-export могли запускать scripts/vault_stats.py и другие скрипты из самого vault. В Windows инструкции используют python вместо python3: имя python3 обычно указывает на Microsoft Store stub и ничего не выполняет.
После копирования нужно пройти девять шагов:
- Установить Obsidian и открыть папку
~/brainкак vault. - Настроить Claude Code в терминале или во вкладке Code десктопного приложения.
- При желании подключить vault по MCP, чтобы агент мог обращаться к нему из любого места.
- Не писать
CLAUDE.mdвручную, а пройти интервью, которое сформирует инструкции для агента. - Настроить два слоя: wiki для знаний и projects для текущей работы.
- Ограничить один проект по scope, когда нужно довести его до результата.
- Установить Web Clipper, сохранять статьи в
raw/и запускать/ingest. - Подключить live data: календарь, почту и чаты.
- Запланировать обслуживание, чтобы база периодически проверялась и обновлялась.
Полная версия этих шагов находится в документе по настройке. Планирование регулярной проверки описано в документе о scheduled maintenance.
Ключевые правила
В проекте закреплены три решения, которые отличают работающую базу от обычной папки с заметками.
Ничего не попадает в базу без связей. Не связанная страница быстро теряется среди остальных. Поэтому добавление материала считается завершённым только после того, как агент связал его с уже существующими концепциями и сущностями.
Противоречия сохраняются, а не перезаписываются. Если новый источник не согласуется с существующей позицией, сохраняются обе версии с датами и ссылками на источники. История изменения убеждений — самостоятельная ценность базы.
Vector database не нужна сразу. Личный корпус обычно небольшой и уже структурированный, поэтому страницы и связи могут отвечать на вопросы без дополнительной инфраструктуры. В проекте отдельно обсуждается порог, после которого RAG начинает приносить пользу.
Связанные проекты
В подборке репозитория отдельно перечислены инструменты для графа, памяти и agent skills:
- GraphRAG — подход к retrieval по всему корпусу вместо отдельных chunks.
- HippoRAG — graph retrieval с personalized PageRank для многошаговых вопросов.
- mem0 — agent memory.
- graphiti — temporal knowledge graphs.
- cognee — граф и vector memory.
- anthropics/skills — формат skills, на который ссылается проект.
- obra/superpowers и VoltAgent/awesome-agent-skills — примеры наборов agent skills.
Эти ссылки в исходном руководстве даны как сопутствующие технологии и альтернативные реализации, а не как обязательные компоненты Second Brain.
Переносимость и границы применения
Формат состоит из Markdown-файлов, wikilinks и SKILL.md, поэтому база не привязана к одному редактору или сервису. Claude Code — основной сценарий, но файлы может читать любой агент. Если убрать все перечисленные инструменты, сам vault и его содержимое останутся доступными.
Подход рассчитан на исследователей, инженеров, авторов, студентов и других людей, которые много читают, смотрят и сохраняют, но не хотят вручную поддерживать заметки. Это не корпоративная wiki, не замена Notion и не система для пустого vault, в который никто ничего не добавляет.
Репозиторий распространяется по лицензии MIT и содержит полную веб-версию руководства. Его заявленный минимум — Obsidian и агент; отдельный MCP, платные сервисы и SaaS для хранения базы не нужны.