

deja-vu — общая память для кодинг-агентов, собранная из их же истории сессий
📂 Исходный код на GitHubПамять для кодинг-агентов на основе уже сохранённой истории сессий: один бинарник на Go, локальный инвертированный индекс, MCP-сервер с одним инструментом и хуки на 42 агента. Без LLM и внешнего сервера, 97.2% R@5 на LongMemEval-S, 17.6 с на индексацию 19,195 сессий. MIT.
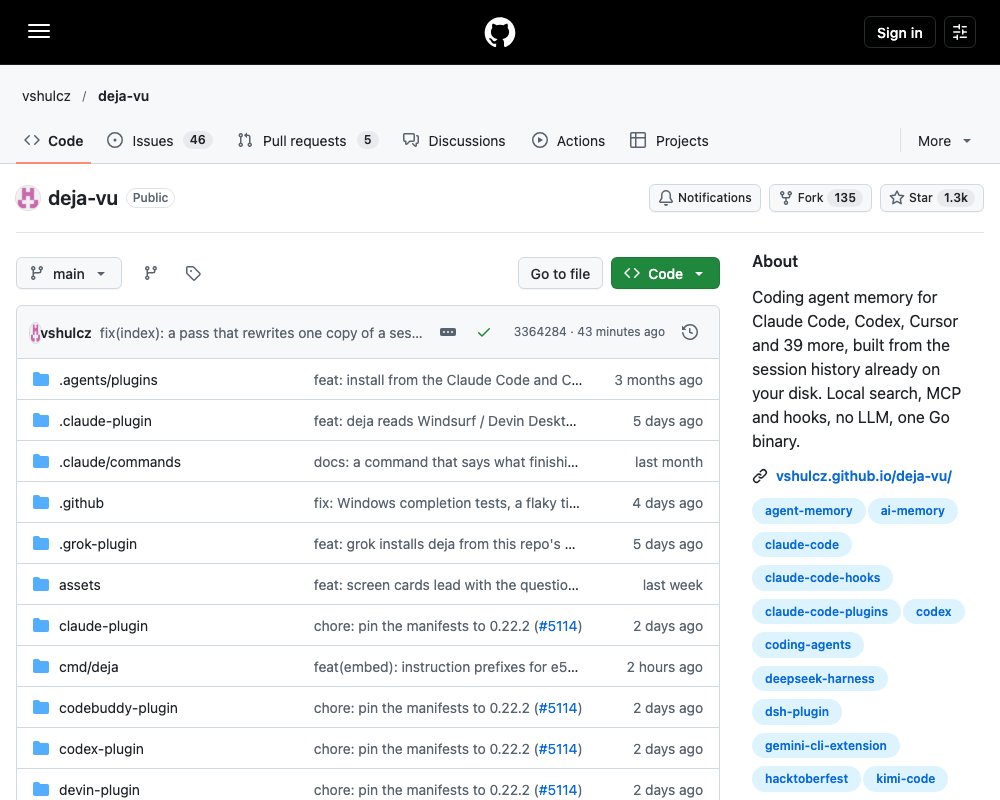
Кодинг-агенты помнят только то, что было в текущей сессии. Что вы чинили месяц назад, какое решение приняли по архитектуре, какая команда уже падала с такой ошибкой, — агент узнаёт заново, и вы объясняете то же самое второй раз. deja-vu решает эту проблему за счёт того, что уже лежит на диске: Claude Code, Codex, Cursor и ещё 39 агентов сами сохраняют каждую свою сессию в файлы. deja-vu индексирует эти файлы и отдаёт нужный кусок тому агенту, который работает прямо сейчас.
Это один бинарник на Go: без LLM, без внешнего сервера, без отдельного шага «собрать память». Поиск идёт локально, к агентам подключается MCP-сервер и хуки. Лицензия MIT, больше 1250 звёзд на GitHub, документация лежит на vshulcz.github.io/deja-vu.
Установка
На macOS и Linux всё делается двумя командами:
curl -fsSL https://raw.githubusercontent.com/vshulcz/deja-vu/main/install.sh | sh
deja install --auto
Скрипт кладёт бинарник в ~/.local/bin. Вторая команда подключает MCP-инструмент recall к найденным агентам, включает отдачу памяти на старте сессии там, где агент это умеет, и сразу строит первый индекс, чтобы следующая сессия ничего не ждала.
Другие пути: brew install deja-vu, go install github.com/vshulcz/deja-vu/cmd/deja@latest или npx @vshulcz/deja-vu "запрос", чтобы попробовать вообще ничего не ставя. На Windows установочный скрипт не сработает — это shell-скрипт, — там помогут scoop install deja-vu или winget install vshulcz.deja-vu.
Сам по себе бинарник — уже полноценная установка для поиска: индексация, поиск, show, ctx, blame, --json и вычистка секретов не требуют ничего больше. deja install подключает MCP к агентам, и это полезно, но необязательно.
Поиск по всей истории
deja без аргументов в терминале открывает полноэкранный поиск по истории всех агентов. Сначала в списке — сессии, стоящие за вашими незакоммиченными изменениями, потом недавние в этом проекте, а список сужается по мере ввода.
- Стрелки выбирают сессию,
Enterоткрывает её на совпадении,nиNперелистывают совпадения,escвозвращает назад. Внутри сессии/ищет слово, а]и[прыгают между вашими вопросами. - Строка поиска понимает фильтры: агент с двоеточием (
codex:),today,yesterday,week,monthиin:<проект>. rвозобновляет сессию в том агенте, который её записал.oпродолжает её в любом другом агенте, и тот начинает с того, что сессия спрашивала, решила и оставила открытым.tabпереключает между текущим проектом, всеми проектами и удалёнными сессиями — теми, что их агент стёр, а deja-vu ещё держит;Rвозвращает такую на место.Dудаляет сессию и у агента, и у deja-vu, после подтверждения.?показывает все клавиши,^k— остальное,qвыходит.
С переменной DEJA_TUI=0 вместо экрана печатается текстовая сводка, она же deja brief. Обычный запрос с аргументом печатает результат и выходит:
$ deja "jwt refresh token"
[claude] api        · Jul 8 · 8f31c0a9 — 2 matches
  login started failing after refresh token rotation; jwt kid mismatch in tests
  fixed by reloading jwks cache after rotateKey and adding a clock-skew test
[codex]  web        · Jul 1 · b77d91e2 — 1 match
  refresh token cookie needed SameSite=Lax in local callback flow
Помимо поиска есть команды, отвечающие на вопросы про прошлую работу: deja wip — чем занималась последняя сессия в этом каталоге; deja blame <путь>[:строка] — какие сессии обсуждали файл и что решили; deja files <тема> — какие файлы работа по теме действительно затронула; deja how <инструмент> — как эту вещь на самом деле запускают на этой машине, с настоящими аргументами; deja fix <ошибка> — что запускали после той же ошибки, когда она больше не возвращалась; deja friction — ошибки, попавшие в три и больше разных сессий.
Одна память на всех агентов
Все 42 агента читают один и тот же индекс. Решение, найденное в Codex, возвращается в Claude Code, Cursor или OpenCode — без отдельной настройки на стороне каждого.
MCP-сервер отдаёт один инструмент deja с параметром mode: recall, context, blame, fix, how, orient, remember, handoff. Один инструмент вместо семи — это про стоимость: подключённый MCP-сервер отправляет описания своих инструментов с каждым запросом, и за них платят каждый ход независимо от того, вызвал агент что-нибудь или нет. Здесь это 477 токенов против 8 283 у самого крупного из семи измеренных серверов.
Хуки добавляют память в момент, когда она нужнее всего. Перед правкой файла или запуском команды хук PreToolUse называет прежние решения по этому файлу. После падения команды хук PostToolUse показывает, что запускали после той же ошибки на этой машине — ровно ту пару, про которую агент сам не спросит.
Что попадает в индекс
Не только слова разговора. Индексируются файлы, которые ход открывал, команды с их кодом возврата и точный фрагмент кода, который заменила правка. Именно это обычно и теряется в любой сводке.
Под капотом — локальный инвертированный индекс в ~/.cache/deja: разбор JSONL- и SQLite-хранилищ, вычистка учётных данных, запись records.bin со словарными корзинами и состояние каждого файла в manifest.gob, благодаря чему повторный запуск забирает только изменившееся. Индекс инкрементальный: когда файл сессии дописан, перечитывается только он.
Замеры
| Метрика | deja-vu | С чем сравнивают |
|---|---|---|
| Полнота на LongMemEval-S (R@5) | 97.2% | MemPalace 96.6%, agentmemory 95.2% |
| Токены на уже решённой задаче | 53 558 | 126 222 без всякой памяти; вдвое меньше, чем у agentmemory |
| Индексация 19 195 сессий | 17.6 с | 72 с у следующего из семи инструментов |
Другие цифры с той же страницы: 88.1% hit@1 на очищенном наборе LongMemEval-S из 470 вопросов и 87.4% на всех 500; 70.5% hit@1 на LoCoMo.
Скорость поиска на реальном хранилище — 2 419 сессий, 179 тысяч сообщений, 1.9 ГБ записей:
| Замер | Результат |
|---|---|
| Запрос внутри процесса | медиана 0.7–0.8 мс, около 15 мс на стогах LongMemEval-S |
deja <запрос> целиком |
медиана около 0.2 с: старт процесса, проверка свежести, ранжирование, вывод |
| Размер индекса | 200 МБ, около 10% корпуса |
Отдельно сравнивался контекстный эксперимент — deja-recall против полной истории, наивного grep и холодного старта:
| Подход | Медиана токенов | Медиана покрытия |
|---|---|---|
| deja-recall | 1 096 | 1.00 |
| full-history | 80 547 | 1.00 |
| naive-grep | 273 238 | 1.00 |
| cold | 0 | 0.00 |
То же покрытие фактов, что и у grep по сырым логам, примерно при 250-кратном меньшем числе токенов — и ничего не подставляется в цепочки, где подходящей истории нет. Автор отдельно предупреждает: прежде чем верить любым таким цифрам, стоит разобраться, как в них определено «релевантно», включая его собственные.
Все стенды для оценки поиска лежат в самом репозитории и прогоняются на публичных датасетах за минуты: deja bench recall, deja bench context, deja bench block, deja bench prompt, deja bench ingest, deja bench read.
Сжатие контекста
Сжатие контекста — это когда окно контекста агента заполняется, и программа заменяет всю переписку короткой сводкой, а оригинальные ходы пропадают. Замеры на 43 реальных сжатиях: сводка сохранила 77% решений и 0.2% команд, которые вы запускали. Остальное отдаёт deja-vu.
Механика простая. С включённым auto-recall хук hook-precompact читает текущую сессию в момент, когда агент сжимает её сам, и вытаскивает оттуда задачу, выводы агента, зафиксированные команды проверки и то, что осталось недоделанным. Следующий хук — на старте сессии, на запросе пользователя или перед вызовом инструмента — отдаёт этот пакет один раз, не больше 4 КБ, и отдельно пишет, менялся ли репозиторий с момента снятия. Никаких команд-чекпоинтов и никаких вызовов модели для этого не нужно. Подробности — в docs/compaction.md.
Приватность
Индексация и поиск идут локально. Сеть нужна только для deja update, deja sync ssh, проверки версии внутри deja doctor и deja embed — последний обращается к эндпоинту, то есть к адресу сервиса, который вы сами задали, и после того, как построен семантический индекс эмбеддингов, отправляет туда запрос. Проверку версии отключают через DEJA_OFFLINE=1 или DEJA_NO_UPDATE_NOTICE=1.
Учётные данные вычищаются прямо при индексации: ключи облаков и провайдеров, токены, JWT, блоки приватных ключей PEM, пароли в URL и в тексте. Каждое значение заменяется на [redacted:<kind>], а текст вокруг него остаётся доступным для поиска. Важная оговорка автора: совпадение по шаблону — это не детектор секретов, форма, которой нет в правилах, может пройти как есть.
deja forget убирает сессии и не даёт им подняться обратно при перестроении индекса. Файл ~/.config/deja/exclude пропускает проекты по одной строке. Перенос между машинами — deja sync ssh laptop: данные только дописываются, облако посередине не нужно.
Чем отличается от платформ памяти
| deja-vu | Платформы памяти (Mem0, Letta, memU) | Поиск по сессиям (cass) | |
|---|---|---|---|
| Знает работу, которая была до установки | да | нет | да |
| Нужен шаг сбора | нет, запись и есть память | агент или ваш код пишет факты | нет |
| Нужен ключ к LLM или эмбеддингам | нет | да | по желанию |
| Отдаёт контекст, когда его не спрашивали | на старте сессии и перед запуском инструмента | нет | нет |
Ограничения
- Windows: сборки есть и тесты там гоняются в CI, но проверенный боевой путь — macOS и Linux.
- Семантический поиск по эмбеддингам — по желанию: указываете
DEJA_EMBED_URLна локальный Ollama, LM Studio или любой OpenAI-совместимый эндпоинт, и вопрос другими словами тоже попадает. Без доступного рантайма лексический поиск и MCP работают как обычно. - TRAE IDE: база сессий зашифрована, deja-vu её не читает — только подключает MCP-сервер и скилл.
- Секреты, которые уже лежат в файлах самого агента, остаются там.
deja secretsназывает сессии, где они есть, не печатая значения, а--scrubпереписывает те, до которых достаёт.
Документация и исходники
- Документация: https://vshulcz.github.io/deja-vu/
- Замеры и сравнение лоб в лоб: https://vshulcz.github.io/deja-vu/guide/benchmarks.html и https://vshulcz.github.io/deja-vu/guide/day-zero.html
- Сравнение с пятнадцатью аналогами: https://vshulcz.github.io/deja-vu/guide/compare.html
- Как встроить в свой инструмент: https://github.com/vshulcz/deja-vu/blob/main/docs/INTEGRATING.md
- Модель безопасности: https://github.com/vshulcz/deja-vu/blob/main/docs/SECURITY-MODEL.md
- Устройство индекса: https://github.com/vshulcz/deja-vu/blob/main/docs/ARCHITECTURE.md
- Лицензия MIT: https://github.com/vshulcz/deja-vu/blob/main/LICENSE
- Репозиторий: https://github.com/vshulcz/deja-vu
Источник: https://github.com/vshulcz/deja-vu