

Superlite — автономная сборка по спецификации для Claude Code
📂 Исходный код на GitHubПлагин для Claude Code: автономная сборка по спецификации. План, параллельные агенты, маршрутизация задач между Sonnet и Haiku, финальное ревью на Opus. Поддерживает Codex, Cursor, Gemini CLI, OpenCode и другие инструменты. Лицензия MIT.
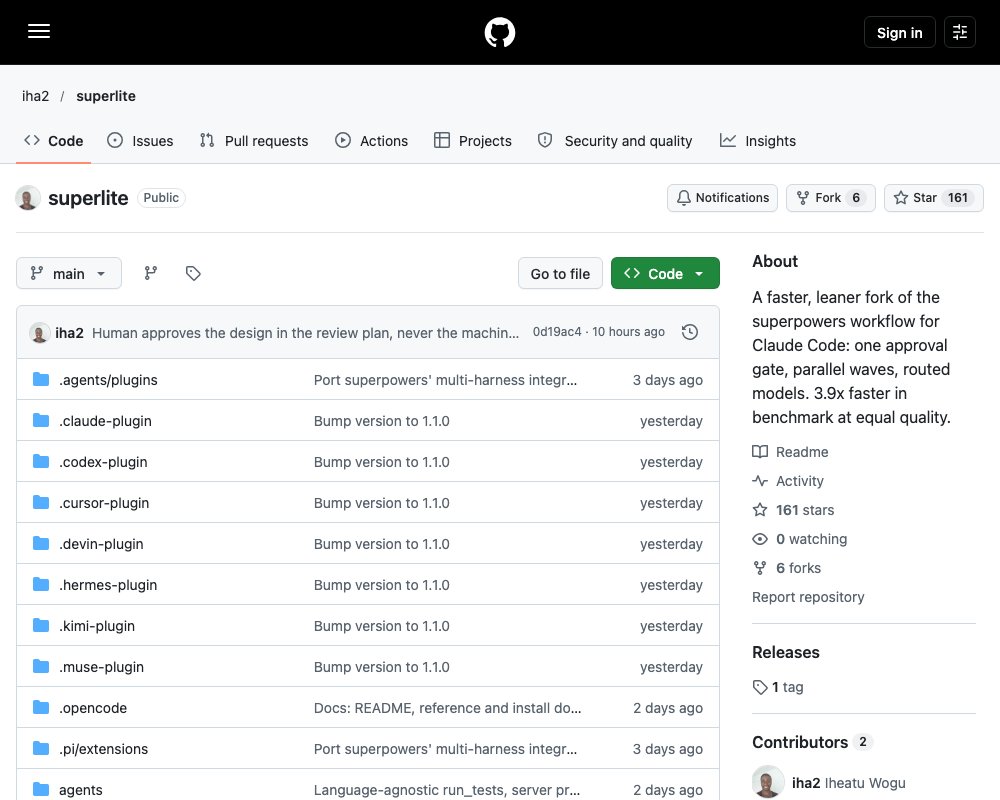
Superlite — плагин для Claude Code, который берёт спецификацию и возвращает готовый проверенный код. Это форк superpowers, перестроенный под другую задачу: не вести человека за каждый шаг, а отдать ему результат.
Логика простая. superpowers держит человека рядом с каждым решением — это удобно, когда вы ведёте разработку сами. superlite планирует сам, делит работу на независимые задачи, отдаёт каждую задачу самому дешёвому агенту, который способен её выполнить, проверяет стыки между задачами и смотрит результат ещё раз. Вы пишете спецификацию и уходите.
Что внутри
Форк взял у superpowers саму планировку: набор навыков, хук в начале сессии, структуру плагина. Остальное переписано под скорость и автономность.
- Навыки живут в каталоге skills/:
brainstorming,writing-plans,subagent-driven-development,test-driven-development,systematic-debugging,verification-before-completion,finishing-a-development-branchи стартовыйusing-superlite. - Агенты описаны в каталоге agents/. Их пять ролей: исполнитель, исполнитель для механических задач, ревьюер пакета, финальный ревьюер и три исправителя разной сложности.
- Инструменты — это обычные скрипты на Python, а не агенты. Они живут в
skills/subagent-driven-development/scripts/. Список команд есть в docs/tools.md.
Координатор (Opus, средние усилия) не пишет код проекта и не запускает тесты напрямую. Он строит граф задач и раздаёт работу.
Как проходит запуск
Ваш запрос → план → параллельная сборка → ревью и исправления → готово- Брейншторм. Один пакет вопросов, а не допрос по одному. Ответы превращаются в спецификацию.
- План.
writing-plansсобирает граф задач: у каждой задачи есть зависимости, размер, оценка контекста и тип работы. - Проверка плана. План проходит линт: задачи получают размерные группы и закреплённые интерфейсы. Пока план не прошёл проверку, работа не начинается.
- Волна 0. Сначала собирается каркас и заглушки — быстрый агент на Haiku делает это по брифу, который скрипты пишут из плана.
- Параллельная сборка. Устойчивые задачи уходят агентам по размеру и сложности. Потребители собираются против заглушек и примеров контрактов, поэтому параллельные ветки не мешают друг другу.
- Тесты и стыки. Тесты идут в фоне, результат пишется в
.superlite/test-summary.json. Отдельно проверяются швы между пакетами. - Ревью. Ревьюер пакета смотрит свою часть и правит свои замечания сам. Финальный ревьюер на Opus читает сводку и возвращает список находок с указанием, кто должен их чинить.
- Исправления. Исправления разбирают агенты по уровню. Haiku не исправляет никогда: у него нет права принимать решения.
Подробный разбор шагов — в docs/how-a-run-works.md.
Кто оркестрирует
Это главная развилка в superlite, и её выбирают один раз на сессию.
| Режим | Как выглядит |
|---|---|
| Человек | Вы получаете план на обычном языке, примерно две страницы, с диаграммами, оценкой времени и стоимости. Ничего не собирается, пока вы не ответите «да». После утверждения координатор переписывает план в формате для агентов и запускает работу. |
| ИИ | Всё происходит без вас: план, проверка, раздача задач и решения по спорным местам. Вопросов не задаёт, решения записывает как постановления. |
Обе модели доступны как команды: /superlite:start спрашивает режим и оркестратора, а /superlite:mvp, /superlite:feature и /superlite:debug сразу ведут в нужный сценарий. Это просто ярлыки — можно описать задачу обычными словами.
Маршрутизация задач по моделям
Слабые модели недорогие, но ошибаются на сложном. Superlite разводит их по разным ролям.
| Роль | Модель | Что делает |
|---|---|---|
| Исполнитель | Sonnet, средние усилия | Берёт одну задачу и остаётся свободной для повторного использования |
| Исполнитель механических задач | Haiku, высокие усилия | Делает полностью описанную мелочь ровно как написано и останавливается, вместо того чтобы догадываться |
| Ревьюер пакета | Sonnet | Смотрит задачу или пакет и правит свои замечания, добавляя тесты |
| Финальный ревьюер | Opus, высокие усилия | Один проход, только находки, ничего не правит |
| Исправители | Sonnet и Opus | Три уровня: причина известна, причина известна но правка задевает несколько модулей, причина неизвестна |
Правило распределения живёт в routing.json и проверяется скриптом: Haiku берёт только механические задачи вне критического пути. Отдельно считается бюджет: при 70 % потолка скрипт предупреждает, при перерасходе останавливает необязательные задачи.
Размер задачи считается заранее
У каждой задачи в плане есть строка с оценкой контекста. Она считается по числу строк, которые задача пишет и читает, плюс фиксированный префикс исполнителя примерно в 18 тысяч токенов. Задачи с прогнозом выше 80 тысяч токенов делятся, слишком мелкие объединяются с соседней, и ни одна задача не планируется дольше примерно трёх минут. План целиком держится в пределах 15 тысяч символов, потому что он же служит общей затравкой для агентов.
Коэффициенты подобраны на одном проекте, так что это ориентир, а не закон.
Есть ещё переключатель detail, который задаёт, насколько подробно расписывать задачу: contracts (файлы, сигнатуры и точные значения тестов), tests (код тестов целиком, реализация на усмотрение исполнителя — значение по умолчанию) и full (код реализации тоже, для трудных алгоритмов).
Правила держит код, а не текст
Инструкции в промптах со временем разъезжаются. Superlite потому и держит жёсткие рамки в хуках и скриптах. Полный список — в docs/gates.md, здесь главное:
- Координатор не может править код проекта. Любое изменение проходит через агента-исполнителя или через исправителя нужного уровня.
- Никаких
pkillиtaskkill: убивать можно только процессы, которые запустил сам забег. - Сырой запуск тестов переписывается в фоновый
sl run_tests, поэтому тесты никогда не блокируют координатора. - План без успешной проверки не запускает работу.
- Агент не может порождать других агентов: у субагентов заданы явные списки инструментов.
- Каждый забег измеряется: расход токенов, деньги и время пишутся автоматически и подпитывают прогнозы следующего забега.
Установка
Нужны Claude Code, git, Python 3.10 или новее и bash (в Windows — Git Bash). Сам проект, который вы будете собирать, может быть на любом языке.
Для Claude Code:
/plugin marketplace add iha2/superlite
/plugin install superlite@superlite-dev
Или загрузить локальную копию на одну сессию: claude --plugin-dir <path-to-superlite>.
Для OpenCode:
Fetch and follow instructions from https://raw.githubusercontent.com/iha2/superlite/refs/heads/main/.opencode/INSTALL.mdОстальные инструменты ставятся отдельно: Codex (codex plugin marketplace add iha2/superlite), Cursor (/add-plugin superlite), Gemini CLI (gemini extensions install https://github.com/iha2/superlite), Copilot CLI, Qwen Code, Kimi Code, Pi, Devin, Factory Droid, Antigravity, Grok Build CLI и Muse. Подробности по каждому — в docs/.
Проверка установки простая: откройте новую сессию и попросите сделать список задач на React. Рабочая установка сначала запустит brainstorming и только потом начнёт писать код.
Цифры
Замеры сделаны на одной машине: два плагина собирают один и тот же проект без участия человека, а скрытый набор тестов оценивает результат.
| Что измеряли | superpowers | superlite |
|---|---|---|
| Время до готовой сборки | 33,6 мин | 16,1 мин |
| Насколько быстрее | — | на 52 % против обычного режима, на 31 % против режима с оркестратором |
| Разброс времени, 3 прогона | 26,4 мин | 9,1 мин |
| Агентов одновременно | 3–4 | до 18 |
| Скрытые тесты | 177 / 177 | 177 / 177 |
Ранний замер на проекте из 9 модулей дал 34,4 мин против 8,8 мин, а стоимость по API — 8,15 $ против 3,28 $.
Оговорка из самого проекта: цифры для superpowers и разброс времени взяты из более ранних прогонов на той же машине, так что это ориентир, а не статистическое доказательство. Superlite может стоить дороже и хуже проходит дополнительные проверки устойчивости: 4 из 7 против примерно 5,7 из 7. Подробный отчёт с оговорками — в docs/benchmark-report.md, сам стенд — в каталоге bench/.
Что стоит знать
- Включайте вместе с superpowers нельзя. У них общие имена навыков и оба подмешивают свой контекст в сессию — они конфликтуют. На сессию выбирается что-то одно.
- Пуш без вас не случится. Финальный шаг — проверка и предложение: сделать коммит в ветку, открыть запрос на слияние или остановиться.
- Прогресс видно в файлах. В
.superlite/лежатprogress.mdс постановлениями и журналом,test-summary.jsonс последним прогоном тестов,metrics.jsonlсо временем и расходом по каждому агенту. История забегов пишется в~/.superlite/history.jsonl. - Отладка идёт по шагам. Навык
systematic-debuggingсначала ищет причину, а уже потом чинит; если два круга правок не помогли, дело переходит к более сильному агенту. - Лицензия MIT.
Источник: https://github.com/iha2/superlite