

local-enough — сколько стоит локальный запуск LLM и когда он окупается
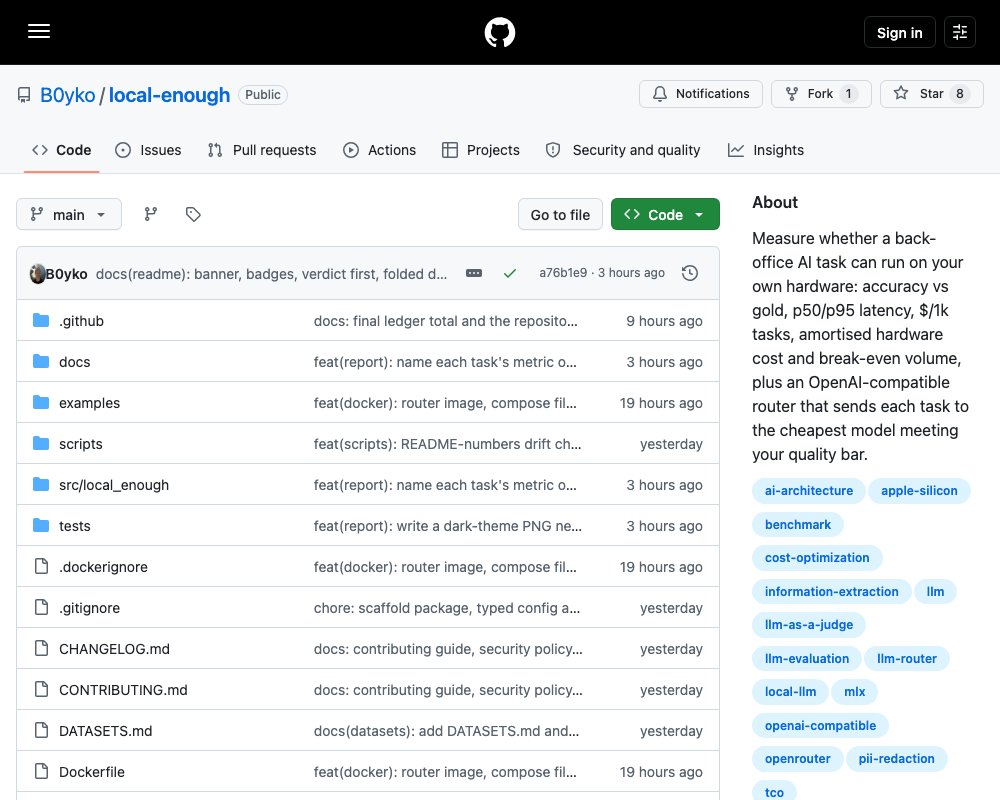
📂 Исходный код на GitHubИзмерительный инструмент на Python: гоняет локальные и облачные модели на ваших задачах, считает точность, задержку и цену, а затем раздаёт запросы самой дешёвой подходящей модели через OpenAI-совместимый сервер.
Есть класс задач, которые не относятся к написанию кода: вытащить поля из входящего письма в CRM, разложить обращение клиента по типам, замазать персональные данные в логе, пересказать встречу, сопоставить записи двух поставщиков. Такие задачи крутятся в фоне, их бывает много, и считают их обычно на чужом API и за чужие деньги.
Проект local-enough отвечает на вопрос про такие задачи буквально: выдержит ли задача локальный запуск на вашем железе и сколько это будет стоить. Не «какая модель лучше вообще», а конкретно — на одной задаче, с цифрами.
Автор — Андрей Бойко, лицензия Apache-2.0, язык Python, нужно 3.12 и uv. Проект молодой: 8 звёзд на GitHub.
Что внутри
Инструмент состоит из пяти шагов, и каждый можно запустить отдельно.
- Bench — прогон. Каждая модель получает один и тот же запрос и один и тот же простой разбор ответа. Обвязка кодовыми блоками и служебными тегами отбрасывается, дальше берётся первый подходящий JSON. Температура 0, у каждой задачи свой предел длины ответа. Ответ, который не распарсился, считается неверным и попадает в счётчик
invalid_output_rate— повторных попыток починить нет. Облачные вызовы идут с ограниченной параллельностью и максимум тремя повторами при 429, 5xx и таймаутах. Локальные MLX-модели CLI запускает и останавливает сам. Каждый платный вызов проходит через один учёт расходов: перед отправкой резервируется верхняя граница суммы, и запрос, который пробьёт потолок бюджета, не уходит. - Measure — замеры. Проход A даёт качество и задержку на одну задачу (локальные модели идут по одному запросу). Проход B измеряет пропускную способность при четырёх параллельных запросах. Проход C — это двадцать минут непрерывной работы, из неё берут коэффициент замедления. Пиковую память меряют через
footprint, потребление — по данным о батарее там, где такая телеметрия есть. Фоновый замер помечает окна, где на машине шла посторонняя работа. - Cost — деньги. Стоимость одной локальной задачи складывается из железа, раскинутого на месячный объём задач, и электричества: отдельно на холостом ходу, отдельно при работе. Дальше считаются точка окупаемости и предельная производительность машины. Формула разобрана в описании модели стоимости и в ADR 4.
- Judge — оценка текста. Сводки проверяет языковая модель-судья. По её вердикту о каждом факте в коде считается простой итог: прошло или нет. Судью предварительно калибруют на сводках с метками, полученными при сборке, и поправляют её долю прохождения на смещение (метод Рогана — Гладена).
- Route — маршрутизация. Планировщик по каждой задаче оставляет только тех кандидатов, кто прошёл планку качества на калибровочной выборке, сортирует их по цене и собирает цепочку запасных моделей. Маршрутизатор применяет тот самый проверенный запрос, прогоняет детерминированные проверки и уходит на более дорогую модель, если проверки не прошли. Логика описана в ADR 1.
Опорный прогон
В репозитории лежит готовый прогон, из которого собираются все таблицы README. Его можно повторить офлайн, без ключей и без денег.
| Параметр | Значение |
|---|---|
| Железо | Mac Studio 2025, Apple M4 Max, 16 ядер CPU, 40 ядер GPU, 128 ГБ |
| Цена железа | $4 099 (розничная цена на старте продаж) |
| Локальные модели | Qwen2.5-1.5B-Instruct-4bit (0,88 ГБ), Qwen3-4B-Instruct-2507-4bit (2,28 ГБ) |
| Облачные модели | четыре модели на OpenRouter: x-ai/grok-4.7, openai/gpt-5.4-nano, deepseek/deepseek-v3.2, qwen/qwen3-235b-a22b-2507 |
| Простые варианты без LLM | TF-IDF, регулярные выражения, rapidfuzz |
| Потрачено на API | $5,77 из потолка в $14,50 |
| Дата прогона | 28 сентября 2026 |
Под долгой нагрузкой модель почти не замедлялась: 0,981 для модели на 1,5B и 1,023 для 4B (в расчёт берётся 1,0). Потребление взято из опубликованных цифр Apple: 6 Вт в простое и 139 Вт сверх этого. Это верхняя оценка — настольный Mac не отдаёт телеметрию батареи. При таких объёмах доля электричества в локальной стоимости всё равно невелика.
Задачи в прогоне: определение намерения, сопоставление записей поставщиков, извлечение полей из письма, замазывание персональных данных, пересказ встречи. Первую задачу взяли из BANKING77 (лицензия CC-BY-4.0), остальные четыре собрали из рукописных шаблонов без участия LLM, поэтому правильные ответы известны точно. Описание выборок, их размеры и контрольные суммы лежат в DATASETS.md.
В замере есть два важных правила: маршрутизация и все вердикты считаются на калибровочной выборке, а показанные числа — на тестовой, которую модель не видела. Модели на OpenRouter выбраны не случайно: почему именно эти четыре, написано в ADR 7.
Вердикт по задачам
Локальный вариант признаётся, только если он проходит планку качества и месячный объём задачи не ниже точки окупаемости. Отдельный случай — «локально, но ниже планки»: он возникает, когда задача помечена как data_must_stay_local, а локальной модели, которая берёт планку, нет.
| задача | вердикт | почему |
|---|---|---|
| Определение намерения | локально | вариант на TF-IDF, вообще без LLM, набирает 88,0 % при примерно нулевой цене. Платить за железо не нужно, а ни одна облачная модель планку в 82,7 % на калибровке не берёт |
| Сопоставление записей | облако | локально выходит дешевле только выше 4 995 204 задач в месяц, при 7 500 задачах это не так |
| Извлечение полей | облако | локальные модели не дотягивают до планки 94,4 %, разрыв 1,8 % |
| Замазывание персональных данных | локально, но ниже планки | задача помечена как «данные не должны уходить наружу», лучший локальный результат 92,0 % против 95,0 % |
| Пересказ встречи | облако | локальные модели сильно ниже планки 68,9 %, разрыв 31,1 % |
Простой вариант без LLM, победивший на первой задаче, — самая интересная находка прогона. Перед тем как платить за API, стоит проверить, не решается ли задача TF-IDF или регулярными выражениями.
Маршрутизатор
Команда local-enough route поднимает OpenAI-совместимый сервер на 127.0.0.1:8000. На него можно переключить любой клиент, который принимает адрес API в формате OpenAI.
POST /v1/chat/completions |
в поле model указывается local-enough/<задача>, сырой вход уходит сообщением пользователя, маршрутизатор сам подставляет проверенный запрос и возвращает разобранный ответ |
GET /v1/models, /healthz, /stats |
псевдонимы задач, проверка живости, счётчики, задержки и расходы |
| Заголовки ответа | x-local-enough-model, x-local-enough-escalated, x-local-enough-gate |
Задачи с пометкой data_must_stay_local до облака не доходят. Если локальная цепочка кончилась, сервер отдаёт 503 с кодом local_only_unavailable, а если подходящей локальной модели выше планки нет — 503 с кодом local_only_below_bar (если не выставлен allow_below_bar_local: true). Аутентификации нет, об этом честно написано в SECURITY.md; тела запросов и ответов не логируются.
На смешанной нагрузке маршрутизатор с проверками стоит $0,706 на тысячу задач против $3,051, если весь трафик идёт на самую дорогую модель, — экономия 76,9 %. Локально обрабатывается 30,0 % задач, на более дорогую модель уходит 3,7 %. Накладные расходы самого маршрутизатора — 6 мс в медиане, ответ приходит за 1 430 мс. Живая проверка на 100 запросах совпала с офлайн-симуляцией в 99,0 % случаев.
Быстрый старт
Первые два шага не требуют ни ключей, ни денег — из готового прогона собираются отчёт и таблица маршрутизации:
local-enough report --run reference --out report/   # report/index.html, report.md, ADR-local-vs-cloud.md
local-enough route --simulate --run reference
Живой прогон с одним ключом OpenRouter (дешевле пяти центов) — одна дешёвая облачная модель плюс три простых варианта на десяти примерах:
local-enough init my-eval && cd my-eval
export OPENROUTER_API_KEY=...
local-enough bench --tasks all --models quickstart.yaml --split calib --limit 10
local-enough report
Локальная модель на Apple Silicon, без ключей (нужен local-enough models pull, дальше — bench и route):
local-enough models pull --models local.yaml
local-enough bench --tasks all --models local.yaml --split calib --limit 10 --run runs/local
local-enough route --run runs/local --models local.yaml
Чтобы точно повторить опорный прогон, нужно клонировать репозиторий и выполнить uv sync --locked: запуск через uvx --from git+... игнорирует файл блокировки, а в нём зафиксированы версии mlx и mlx-lm, на которых снимались цифры. На Linux mlx-lm не ставится, остаются только облачные и OpenAI-совместимые адреса. Подробности запуска в Docker, включая случаи, когда флаг на хосте открывает сервер модели в локальную сеть, — в docs/docker.md.
Своя задача
Инструмент не заперт на пяти встроенных задачах. Описываете свою в task.yaml, кладёте рядом calib.jsonl и test.jsonl — и bench, report, route работают как раньше. Формат полей по типам задач и сам task.yaml разобраны в docs/add-your-task.md. Готовый пример — маленький выдуманный классификатор обращений в поддержку, он лежит в examples/custom-task.
Все поля конфигурации описаны в docs/configuration.md: в config.yaml живут модели, кандидаты на роль судьи, бюджет и входные данные по стоимости железа, в route.yaml — планки качества, потолки задержки, список data_must_stay_local, смесь нагрузки и месячный объём. Ключи берутся только из переменных окружения: OPENROUTER_API_KEY, LOCAL_ENOUGH_BUDGET_USD, LOCAL_ENOUGH_HOME.
Честные ограничения
- Четыре выборки из пяти собраны из шаблонов, они ровнее настоящей почты, поэтому на живых данных цифры будут ниже. Именно ради этого и сделана возможность принести свою задачу.
- Железо измерено одно: Mac Studio M4 Max. Любое другое можно только внести во входные данные стоимости, измерить его инструмент не умеет.
- Только английский язык. Цены в прогоре актуальны на дату среза.
- Доверительные интервалы широкие: от 80 до 308 примеров на задачу.
- Судью калибровали на сводках с метками из сборки, а не на человеческих.
data_must_stay_local— это ограничение маршрутизации, а не заявление о соответствии GDPR.- Маршрутизатор умеет только те запросы, которые сам же и проверял, и не поддерживает потоковую выдачу.
С чем сравнивают
Общие шлюзы вроде маршрутизации LiteLLM или provider routing в OpenRouter выбирают провайдера по доступности, задержке или цене, но не по измеренному качеству на вашей задаче. Обучаемые маршрутизаторы (RouteLLM, Not Diamond, Martian) полагаются на данные, которые вы не контролируете или отправляете наружу, и ни один из них не считает стоимость железа, который у вас уже есть. Локальные бенчмарки скорости (llama-bench, mlx_lm.benchmark) показывают пропускную способность и память, но не отвечают на вопрос, справится ли модель с вашей задачей и вернёт ли разбираемый ответ. Общие таблицы рейтингов говорят про способности вообще, а не про ваш формат ответа и цену в месяц.
Итог
Проект честно отвечает на неудобный вопрос и не пытается продать локальный запуск любой ценой. Из пяти задач локально имеет смысл только одна — и та благодаря варианту вообще без LLM. Для остальных окупаемость уезжает за миллионы задач в месяц, а часть задач упирается в запрет уходить наружу и остаётся без ответа. Такой результат полезнее красивого графика: он сразу показывает, где локальный запуск бессмыслен.
Документация по проекту лежит в репозитории, лицензия — Apache-2.0.
Источник: https://github.com/B0yko/local-enough