

colibrì: локальный inference для frontier MoE-моделей на чистом C
📂 Исходный код на GitHubЧистый C inference-движок без зависимостей для локального запуска девяти MoE-семейств: experts стримятся с диска, а VRAM, RAM и storage образуют единую иерархию.
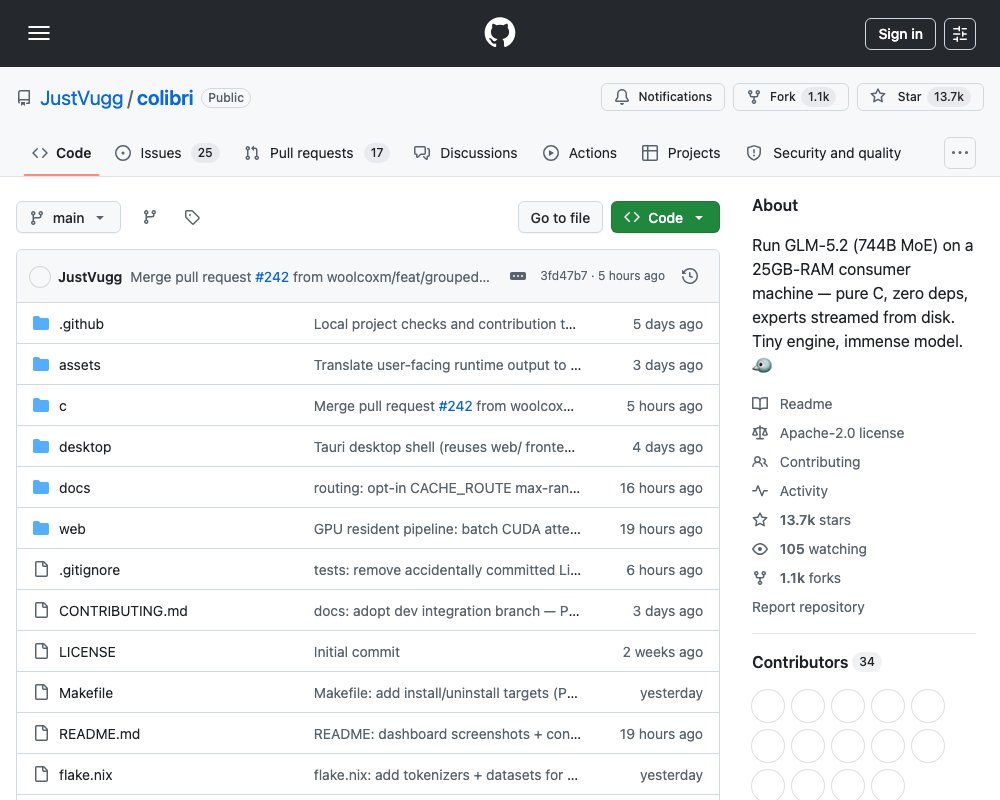
colibrì — это inference-движок на чистом C, который запускает крупные MoE-модели на потребительском и неоднородном железе. Он не требует, чтобы модель целиком помещалась в VRAM или RAM: storage, RAM и VRAM образуют единую иерархию размещения, а маршрутизируемые эксперты стримятся с диска по мере необходимости.
Движок работает без BLAS, Python в runtime и GPU как обязательного требования. При этом один и тот же front end — coli chat, coli serve и coli web — запускает девять семейств моделей: GLM-5.2/5.3, GLM-5.3-Flash, Inkling, Kimi K3, DeepSeek V4 Flash, DeepSeek V4.1 Flash, Qwen3.8-Flash-Next, Qwen3.6 и OLMoE. Для каждой архитектуры в проекте есть свой C-файл, а общие механизмы вынесены в небольшие заголовки.
Как устроено размещение
MoE-модель не активирует все параметры на каждом токене. В описании GLM-5.2 из README: из 744B параметров на токен приходится около 40B, а меняется около 11 ГБ routed-параметров. Поэтому основная стратегия colibrì — не загружать всю модель в быструю память, а размещать её по слоям.
- Dense-часть — attention, shared experts и embeddings, около 17B параметров — остаётся resident в RAM в int4 и занимает примерно 9.9 ГБ.
- 19 456 routed experts хранятся на диске, занимая около 370 ГБ в int4-контейнере, и читаются по требованию.
- Per-layer LRU, learned pinned hot-store и опциональный VRAM-уровень решают, какие эксперты стоит держать ближе к вычислениям.
- Router-lookahead заранее загружает следующий слой, пока текущий ещё считается; по измерениям README маршрутизация следующего слоя предсказуема на 71.6%.
Движок рассматривает размещение не как отдельную оптимизацию, а как часть inference pipeline. Недостаток быстрой памяти может снизить скорость, но не должен молча менять precision модели или semantics маршрутизации.
Ключевые техники
Иерархия памяти. CPU, CUDA, Metal, NUMA memory и разные уровни expert residency работают в одном runtime. GPU не является обязательным: он ускоряет доступные конфигурации, но не определяет базовую возможность запуска.
JIT для весов. Движок измеряет routing heat, закрепляет часто используемые эксперты и делает prefetch на один слой вперёд. Это аналог JIT-компиляции, только для весов: горячие участки модели перемещаются в RAM или VRAM по реальной статистике маршрутизации.
I/O как часть движка. Эксперты одного batch объединяются, чтения перекрываются с вычислениями, а O_DIRECT и распределение нагрузки между двумя SSD проверяются как отдельные политики. Для второго диска предусмотрен mirror: стартап проверяет совпадение файлов и заголовков safetensors, неполный mirror допустим, ошибки чтения переключают запрос на основной диск.
Сжатое состояние. MLA attention хранит 576 float на токен вместо 32 768 — состояние в 57 раз меньше. Оно сохраняется в .coli_kv, поэтому разговор может продолжиться после перезапуска без повторного prefill. Forward pass проверяется против transformers oracle, а DSA sparse attention реализован с проверкой полного выбора ключей.
Спекулятивное декодирование. Для GLM-5.2 native MTP head создаёт черновые токены, которые основная модель проверяет одним батчем. В README указано 2.2–2.8 токена на forward, когда такой метод окупается. MTP head должен быть int8: int4-вариант теряет acceptance. Grammar-forced drafts добавляют предсказуемые токены для constrained JSON output. Если speculation не ускоряет конкретную workload, её можно отключить.
Локальный кластер
Модель можно разделить между несколькими Mac. Coordinator оставляет локальными генерацию токенов, routing и KV state, а disk-backed workers выполняют routed FFN на других машинах. Слой отправляется worker как один постоянный TCP-запрос с batch-union, поэтому токен не требует отдельного round trip для каждого эксперта.
Режим cluster необязателен: без настроенных workers обычный single-machine путь остаётся неизменным. Плотное разбиение слоёв и browser/WebGPU workers обозначены в проекте как отдельные направления развития.
Производительность
Скорость сильно зависит от диска, bandwidth, cache hit rate и residency. README приводит следующие контрольные точки для int4-контейнера GLM-5.2:
| Конфигурация | Decode |
|---|---|
| 6× RTX 5090, full residency | 5.8–6.8 tok/s, TTFT около 13 с |
| CPU-only desktop с 128 ГБ RAM | около 1.8 tok/s на прогретом кэше |
| Laptop-class RTX 5070 Ti | 1.07 tok/s через GPU-resident pipeline |
| Dev box с 25 ГБ RAM | 0.05–0.1 tok/s на холодном старте |
Это не универсальные гарантии, а измерения на конкретных конфигурациях. Проект отдельно подчёркивает, что correctness и quality нужно измерять вместе с throughput, latency, memory и cost. На странице бенчмарков собраны дополнительные измерения, а протокол бенчмаркинга задаёт минимальный отчёт для воспроизводимого сравнения.
Brio, API и web-интерфейс
coli serve предоставляет OpenAI-совместимый HTTP API, а coli web поднимает API и dashboard в одном процессе. В версии 1.12.0 интерфейс redesigned как workspace с chat, Brio mode, Brain page и Profiling в светлой и тёмной темах. Brain показывает измеренный atlas routed experts GLM-5.2: в README указано 13 260 охарактеризованных экспертов в десяти областях. Позиция отражает routing affinity, а не learned embedding.
Brio mode решает задачи выбора, а не генерации текста. Клиент передаёт документ, вопрос и разрешённые варианты, а модель возвращает вероятность каждого варианта и entropy. completion_tokens равен нулю, ответ не может выйти за заданный список, а обычный chat не меняется. На Qwen3.6 проект сообщает ускорение в 2.4 раза для schema из четырёх полей и в 5.7 раза для четырёх вопросов об одном документе. Подробности запросов и ограничений находятся в документации Brio.
Как начать
Нужны две вещи: небольшой бинарник движка и модель. Для GLM-5.2 рекомендован group-scaled gs64 int4-контейнер с int8 MTP head размером около 372 ГБ. GLM-5.3 использует отдельный контейнер размером около 419 ГБ и не содержит MTP head. Для остальных семейств README приводит отдельные требования к диску, RAM и GPU; ни одна из перечисленных моделей не требует GPU для базового запуска.
Можно скачать готовый release для Linux, macOS или Windows и запустить:
python3 coli infoСборка из исходников требует gcc или clang с OpenMP:
git clone https://github.com/JustVugg/colibri
cd colibri/c
./setup.sh
Основные команды одинаковы для всех поддерживаемых моделей:
COLI_MODEL=/nvme/glm52_i4 ./coli chat
COLI_MODEL=/nvme/glm52_i4 ./coli plan
COLI_MODEL=/nvme/glm52_i4 ./coli doctor
COLI_MODEL=/nvme/glm52_i4 ./coli doctor --deep
COLI_MODEL=/nvme/glm52_i4 ./coli tune
./coli serve --model /nvme/glm52_i4
./coli web --model /nvme/glm52_i4
plan показывает предполагаемое размещение в VRAM, RAM и на диске, doctor проверяет готовность, а tune измеряет и сохраняет безопасный профиль для конкретной машины. Полный Quick Start guide описывает платформенные нюансы.
Исследовательский подход
colibrì развивается как открытая исследовательская платформа для inference-систем. Эксперименты охватывают форматы моделей, сжатие, размещение, scheduling, storage I/O, CPU/GPU kernels, KV state и routing-aware speculation. Приоритет имеют не отдельные microbenchmark-и, а воспроизводимые end-to-end измерения на реальных машинах.
Для участия проект предлагает CONTRIBUTING.md, протокол измерений и issue с железом, commit, моделью, командой, prompt, состоянием кэша, throughput, TTFT, expert hit rate, объёмом прочитанных байтов и проверкой качества. Лицензия проекта — Apache 2.0; лицензия весов GLM-5.2 указана отдельно в репозитории.
Источник: https://github.com/JustVugg/colibri