

Firewall LLM: локальный шлюз безопасности для LLM-трафика
📂 Исходный код на GitHubOpen-core шлюз безопасности для LLM-трафика с OpenAI-совместимым API, маршрутизацией по политикам, учётом токенов, DLP, детекцией prompt injection, локальным ML, аудитом и наблюдаемостью.
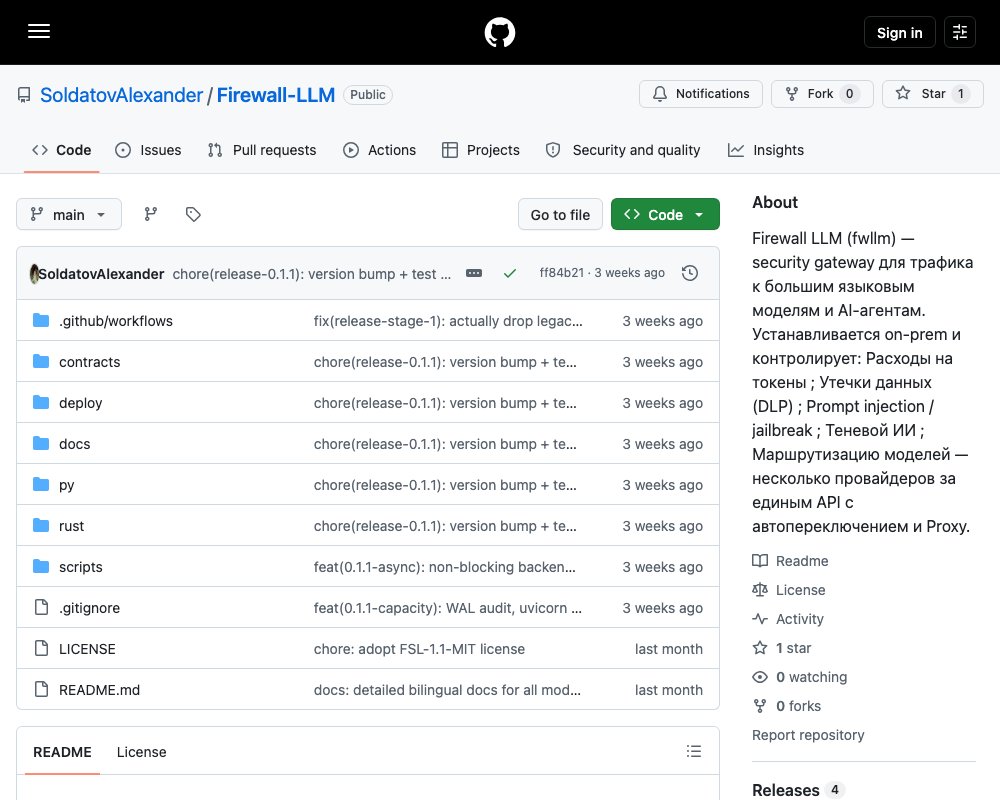
Подключать каждому приложению отдельный LLM-провайдер удобно на этапе прототипа, но в корпоративном контуре быстро появляются десятки неконтролируемых интеграций. У каждой команды свой ключ, лимиты, набор моделей и правила работы с данными. Firewall LLM предлагает поставить перед ними единый локальный шлюз: приложения общаются с ним через один OpenAI-совместимый API, а он маршрутизирует запросы, считает токены, проверяет содержимое и выбирает подходящего провайдера.
Что решает Firewall LLM
Проект позиционируется как open-core security gateway между приложениями и LLM-провайдерами. Главная идея — не менять приложения при добавлении новой модели, а менять конфигурацию шлюза. Через один endpoint можно работать с OpenRouter, OpenAI, Ollama и другими провайдерами, не погружая каждое приложение в различия их API.
Основные задачи проекта:
- единый OpenAI-совместимый API и потоковая передача ответов через SSE;
- подменяемые адаптеры для разных LLM-провайдеров;
- маршрутизация запросов по политикам, лимитам токенов и моделям;
- автоматическое переключение на другой провайдер после атаки или по политике маршрутизации;
- обнаружение prompt injection по сигнатурам и локальной ML-модели;
- маскирование чувствительных данных перед отправкой за периметр;
- учёт запросов и квот, аудит и экспорт метрик;
- полностью локальное развёртывание без передачи телеметрии наружу.
Единый контракт вместо интеграций с каждым провайдером
Основная точка входа — POST /v1/chat/completions. Это позволяет менять backend, не переписывая клиентский код приложения. Шлюз принимает привычный OpenAI-совместимый запрос, а адаптер отправляет его выбранному провайдеру. Поддерживается потоковый режим SSE.
В репозитории есть адаптеры для OpenRouter, OpenAI и Ollama. Отдельный вариант Tunnel работает через агент на wss://:8443 и нужен для контролируемого сетевого egress. Таким образом, проект объединяет две разные задачи: приведение API разных провайдеров к общему интерфейсу и управление тем, как приложение выходит в сеть.
Маршрутизация и контроль расходов
Router и Policy Engine принимают решение о маршруте до обращения к внешнему сервису. В политиках можно задавать token budgets, соответствие моделей и автоматический failover при атаке. Это полезно, когда один провайдер недоступен, исчерпал лимит или когда конкретный запрос нельзя отправлять в выбранную модель.
Metering считает токены и запросы. Для квот используется Redis с режимом fail-open: если квота недоступна, шлюз не должен останавливать весь LLM-трафик. Такой выбор сохраняет доступность, но требует отдельно наблюдать за состоянием Redis и не позволяет считать metering абсолютно обязательным барьером безопасности.
Защита от prompt injection
Inspector анализирует входящие сообщения до отправки модели. Детектор использует два подхода: сигнатурные правила и локальную ML-модель в формате ONNX. Результат имеет уровень серьёзности, поэтому политика может реагировать не только блокировкой, но и маршрутизацией атакованного запроса на другого провайдера.
Локальная модель важна для on-prem-сценария: проверка не требует отправки пользовательский текст ещё одному внешнему сервису. При этом сигнатурный слой и ML дополняют друг друга, а проект позволяет политике реагировать на severity атаки, а не только на бинарный факт совпадения.
DLP перед выходом за периметр
Для маскирования чувствительных данных используется LightAnon, модель ru_152. Она обрабатывает данные локально и заменяет чувствительные фрагменты перед отправкой запроса провайдеру. Маскирование обратимо, что важно, если бизнес-логика должна восстановить исходное значение после возврата ответа.
Здесь стоит разделять две задачи: Firewall LLM предотвращает передачу распознанных чувствительных данных и защищает LLM-трафик, но README не обещает универсальную классификацию любой информации. Набор того, что считается чувствительным, и допустимые действия с запросом задаются конфигурацией и политиками проекта.
Egress-контуры
README описывает три варианта исходящего подключения:
| Режим | Назначение |
|---|---|
direct |
Прямое подключение к выбранному LLM-провайдеру |
single_proxy |
Выход через один прокси; режим обозначен как open |
pools и tunnel |
Пулы прокси и туннель; доступность отнесена к enterprise-части |
Такое разделение позволяет выбрать минимальный контур для локальной разработки и более строгую сетевую изоляцию для организации. Прямой вызов, один прокси, пул и агент в туннеле — не взаимозаменяемые детали, а разные уровни контроля сетевого egress.
Архитектура
Clients -> Unified API -> Gateway
                         |-> Router + Policy Engine
                         |-> Inspector: injection + DLP
                         |-> Metering + Audit + Metrics
                         `-> Egress: OpenRouter, Ollama, or Tunnel
Проект развивается одновременно на Python и Rust, но сохраняет общий контракт. Python-реализация подходит для разработки и запуска через Uvicorn, Rust-вариант позиционируется как production-реализация на axum. Для обоих вариантов описан единый пользовательский сценарий через fwllm.yaml.
Быстрый запуск Python-версии
Для локального запуска требуется Python 3.11 или новее:
git clone https://github.com/SoldatovAlexander/Firewall-LLM.git
cd Firewall-LLM/py/fwllm
python3 -m venv .venv
source .venv/bin/activate
pip install -e '.[dev]'
cp config.example.yaml fwllm.yaml
cp .env.example .env
FWLLM_CONFIG=./fwllm.yaml uvicorn fwllm.main:app --host 0.0.0.0 --port 8080
Перед запросом нужно задать OPENROUTER_API_KEY и FWLLM_CLIENT_TOKENS в .env. Проверка единого API выглядит так:
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Authorization: Bearer <key>" \
  -H "Content-Type: application/json" \
  -d '{"model":"gpt-4o","messages":[{"role":"user","content":"Hello!"}]}'
Rust-вариант запускается из соседнего каталога:
cd rust
FWLLM_CONFIG=../py/fwllm/fwllm.yaml cargo run -p fwllm-gateway
Для полного стека репозиторий предоставляет Docker Compose-конфигурацию. После копирования примеров окружения команда docker compose up -d --build поднимает gateway, Rust-сервис, ingress и Grafana. В стандартной конфигурации README указывает порты 8080, 8081 и 8443.
Проверки и наблюдаемость
Для Python-части предусмотрены pytest, ruff и mypy; для Rust — cargo test --workspace и cargo clippy -- -D warnings. Это позволяет проверять обе реализации в рамках общего контракта.
Gateway предоставляет endpoint Prometheus /metrics, а поставка включает дашборд Grafana. Наблюдаемость дополняется SQLite-аудитом с удалением PII из записей. Вместе metering, audit и метрики показывают не только сколько токенов расходуется, но и через какие политики проходят запросы.
Документация и контракты
В репозитории есть русская и английская документация по модулям:
- русская документация;
- английская документация;
- OpenAPI-контракт;
- схема политик;
- пример конфигурации Python-части.
Open core и enterprise
В открытую часть входят gateway, маршрутизация, квоты, аудит, прямой egress и single_proxy, сигнатурная детекция атак, LightAnon DLP и метрики. Enterprise-часть добавляет несколько пулов прокси, ML-модели и пакеты обновлений, UI, интеграцию с SIEM, RBAC, SSO и высокую доступность.
Основное ядро распространяется по FSL-1.1-MIT: оно бесплатно, но прямой конкурент в категории LLM security gateway исключён из бесплатной лицензии. По условиям проекта лицензия автоматически становится MIT через два года.