

PSSA — языковая модель без трансформера, написанная на Rust
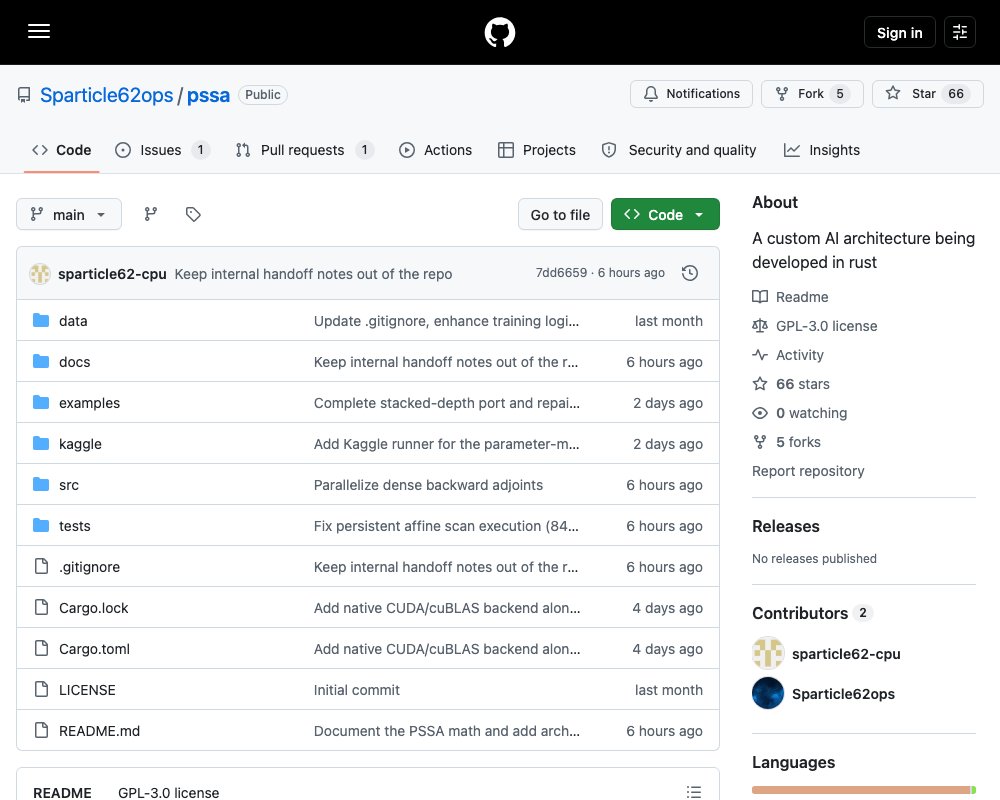
📂 Исходный код на GitHubСобственная архитектура языковой модели, которую пишут на Rust с нуля, без PyTorch и TensorFlow. Рекуррентный слой состояния, банк памяти на 512 слотов, пластичные веса и CLI для обучения, генерации и оценки.
PSSA — это исследовательский прототип языковой модели, написанный на Rust с нуля. В проекте нет ни PyTorch, ни TensorFlow, ни любого другого фреймворка для машинного обучения: линейная алгебра написана вручную.
Модель не использует трансформер. Вместо того чтобы каждый раз перечитывать весь контекст, она несёт одно состояние фиксированного размера, ищет нужное в банке памяти и переписывает часть своих весов прямо во время работы.
Проект интересен не готовой моделью, а идеей. Авторы показывают, что рекуррентный слой состояния с пластичными весами можно реализовать и проверить целиком, без фреймворков. Они сравнили PSSA с трансформером на одинаковом числе параметров и получили меньшую потерю при обучении, а генерацию — в 12 раз быстрее на одном и том же процессоре.
Сразу о масштабе: это прототип на 1,5 млн параметров. Он не конкурирует с моделями, о которых вы слышали. Качество текста у него пока низкое, и авторы сами это пишут. Ниже — что именно реализовано и что показали замеры.
Что лежит в репозитории
| Параметр | Значение |
|---|---|
| Репозиторий | Sparticle62ops/pssa |
| Описание проекта | A custom AI architecture being developed in rust |
| Язык | Rust, edition 2024 |
| Лицензия | GPL-3.0, файл LICENSE |
| Имя пакета и бинарника | oxide_ai_pssa, версия 0.4.0 |
| Размер модели | 1,5 млн параметров |
| Прямые зависимости | ureq, tokenizers, wgpu, rayon, serde_json |
| CUDA-бэкенд | cudarc, включается отдельно |
В списке зависимостей нет ни одного ML-фреймворка. Это видно и в Cargo.toml: там только загрузка данных, токенизация, WebGPU и многопоточность.
Почему выбран Rust
Авторы пишут, что выбрали язык не ради скорости и не потому, что он делает архитектуру лучше. Rust понадобился из-за трёх практических причин:
- веса нужно обновлять на каждом токене;
- банк памяти пишется прямо во время прохода вперёд;
- нужна скалярная эталонная реализация, с которой сравниваются градиенты всех пакетных ядер.
Внутри фреймворка автоматического дифференцирования всё это приходилось бы постоянно обходить. Поэтому линейная алгебра написана напрямую. По словам авторов, претензия проекта — сама архитектура, а язык — деталь реализации. Порт на Python они приветствуют.
Чем PSSA отличается от трансформера
Трансформер оценивает каждую пару токенов в контексте. Из-за этого цена одного шага растёт как квадрат длины последовательности, а весь контекст перечитывается на каждом шаге.
PSSA несёт по последовательности одно состояние фиксированного размера за один проход слева направо. Нужное она ищет в банке памяти, а не перечитывает контекст заново. Поэтому цена растёт линейно с длиной.
Схема слоя в сравнении с блоком трансформера лежит в репозитории: architecture.png.
Как устроен один слой
Каждый токен проходит через один слой PSSA. В него входят четыре части: рекуррентный переход состояния, ограниченное чтение из банка памяти, обучаемый затвор и слой MLP с функцией активации SiLU.
Переход состояния
Из самого токена считываются три проекции. Именно это делает переход избирательным, а не фиксированным:
delta = softplus(W_delta x)      per-channel step size,  delta in R^d_m
B     = W_B x                    input map,              B in R^d_s
C     = W_C x                    output map,             C in R^d_s
Переход диагональный: своя скорость на каждую пару «канал, состояние». Знак отрицательный по построению, поэтому переход не может разойтись:
A = -softplus(A_raw) A in R^(d_m x d_s)Эта непрерывная система дискретизируется с шагом delta, и получается обновление на один токен:
Abar_ij = exp(delta_i * A_ij)
Bbar_ij = delta_i * B_j

h_ij <- Abar_ij * h_ij + Bbar_ij * x_i
y_i   = sum_j C_j * h_ij
Состояние h переносится и между токенами, и через границы кусков при обучении.
Матрица A_raw инициализируется так, что 16 скоростей каждого канала расставлены по логарифмической шкале времён tau от 1,5 до 200 токенов. Это сделано в духе инициализации HiPPO. В итоге один канал сразу держит и последние два токена, и последние две сотни. Обучение двигает эти горизонты, а не ищет их с нуля.
Чтение из памяти
Вот эта часть — собственная разработка PSSA. Запрос строится одновременно из текущего токена и текущего состояния. Значит, поиск зависит от того, докуда дошёл переход, а не только от токена под рукой:
q  = W_qx x + W_qh y
qh = proj(q)                     diffeomorphic map into the Poincare ball, |qh| < 1
Чтение ограничено четырьмя слотами. Вес считается через softmax по гиперболическому расстоянию при температуре tau_mem:
w = softmax(-d_H(qh, k_s) / tau_mem)   over the 4 nearest slots
m = sum_k w_k * v_k
Гиперболическое расстояние растёт у границы шара. Поэтому слоты с общим контекстом и слоты с одним конкретным эпизодом остаются различимыми, даже не расширяя само чтение. Четыре слота — это фиксированная цена на токен, сколько бы банк ни содержал.
Затвор, адаптер и MLP
Прочитанное не попадает в поток безусловно. Обучаемый затвор по каналам решает, сколько оттуда пропустить. Рядом стоит низкоранговый адаптер с SiLU, который несёт точечные обновления:
g     = sigmoid(W_gate x)
z     = s * y + g (elementwise) W_proj m + adapter(x)
u     = W_2 silu(W_1 z)
z_out = z + u
Запись в память
Записи — причина, по которой архитектура названа пластичной. Новый слот добавляется, когда приходящее состояние новое по сравнению с тем, что банк уже держит. У каждого слота есть счётчик восстановления, который ограничивает, как часто его можно перезаписать. А быстрые пластичные правки возвращаются в базовую матрицу перехода через замкнутую форму гребневой регрессии, а не остаются навсегда во внешнем хранилище:
A_base <- A_base + (H^T H + lambda I)^-1 H^T dHСчётчик восстановления не даёт потоку противоречивых обновлений стереть слот, который уже устоялся под действием повторяющихся данных. А консолидация не даёт банку памяти быть единственным местом, где хранится дальняя структура.
Что здесь нового, а что нет
Сам переход — стандартная техника из семейства избирающих SSM. Авторы прямо пишут, что новизны в нём не заявляют: это тот же класс, что у S4 и Mamba, просто выписанный сначала в скалярном виде, чтобы backward pass можно было проверить по членам.
Заявлены три вещи: ограниченное гиперболическое чтение, завязанное на состояние перехода; правила новизны и счётчика восстановления при записи; и шаг консолидации гребневой регрессией из быстрых весов в матрицу перехода.
Всё это проверяется против скалярного эталонного пути. На каждом коммите пакетные и параллельные реализации сравниваются с эталоном, и сейчас максимальная ошибка градиента около 3e-8:
cargo run --release --example twin_checkРазмеры по умолчанию
| Параметр | Значение |
|---|---|
Ширина состояния d_m |
256 |
Состояний на канал d_s |
16 |
| Ранг адаптера | 16 |
| Слотов в банке памяти | 512 |
| Ширина ключа памяти | 32 |
| Размер словаря | 2048 |
Что показало сравнение
Две модели, один корпус, один токенизатор, одно расписание оптимизатора, одно зерно, одинаковое число параметров. Одна — PSSA, вторая — обычный трансформер. Обе обучались на очищенном WikiText-103.
Цепочка обучения состояла из 64 отрезков по 200 000 токенов, каждый отрезок продолжал предыдущий, а состояние оптимизатора не сбрасывалось. Итоговая потеря на обучении — 3,98 у PSSA против 4,43 у трансформера. Разрыв 0,45 нат, перплексия 53,7 против 83,7. Трансформер потратил весь свой бюджет в 12,7 млн токенов, чтобы достичь потери, которую PSSA прошёл примерно на 2 млн токенов.
Потери на каждом отрезке
| Отрезок | Просмотрено токенов | PSSA | Трансформер |
|---|---|---|---|
| ck01 | 200 000 | 5.733 | 6.461 |
| ck05 | 1 000 000 | 4.617 | 5.467 |
| ck10 | 2 000 000 | 4.447 | 5.082 |
| ck15 | 3 000 000 | 4.292 | 4.858 |
| ck20 | 4 000 000 | 4.185 | 4.704 |
| ck25 | 5 000 000 | 4.221 | 4.704 |
| ck30 | 6 000 000 | 4.070 | 4.561 |
| ck35 | 7 000 000 | 4.039 | 4.523 |
| ck37 | 7 400 000 | 3.960 | 4.465 |
| ck44 | 8 800 000 | 4.004 | 4.480 |
| ck48 | 9 600 000 | 3.937 | 4.415 |
| ck52 | 10 400 000 | 3.846 | 4.344 |
| ck56 | 11 200 000 | 3.887 | 4.375 |
| ck60 | 12 000 000 | 3.972 | 4.418 |
| ck64 | 12 800 000 | 3.982 | 4.428 |
Кривые ни разу не пересекаются и ни разу не сходятся. В самом README есть небольшое расхождение: в тексте бюджет назван 12,7 млн токенов, а в последней строке таблицы стоит 12 800 000.
Проверка на невидимом тексте
Потеря на обучении говорит только о том, что модель подошла к тому потоку, который ей скормили. Поэтому обе модели дополнительно оценили на куске из 198 939 токенов, взятого из части корпуса, которую ни один из прогонов не видел.
| Метрика на невидимом куске | PSSA | Трансформер |
|---|---|---|
| Кросс-энтропия | 3.997 | 4.429 |
| Перплексия | 54.4 | 83.8 |
| Точность предсказания следующего токена | 24.1% | 18.0% |
Разрыв на невидимом тексте — 0,43 нат. Он почти равен разрыву на обучении. Авторы делают из этого вывод, что PSSA не просто лучше запоминает, а лучше обобщает.
Скорость генерации
200 токенов на одном и том же процессоре, один промпт, один и тот же сэмплер:
| 200 токенов | PSSA | Трансформер |
|---|---|---|
| Время | 226 мс | 2 735 мс |
| Относительно | в 12 раз быстрее | базовая линия |
Причина понятна из устройства модели. Рекуррентная модель несёт состояние фиксированного размера, поэтому цена каждого нового токена не растёт с длиной предыдущего текста. Трансформер перечитывает весь контекст на каждом шаге.
Скорость обучения
Здесь авторы отдельно предупреждают, что цифры не сравнимы. PSSA обучался на GPU T4 в Kaggle примерно со скоростью 900 токенов в секунду, а базовая модель работала только на CPU, потому что у команды train-transformer нет GPU-пути, и держала 212 токенов в секунду. Эти числа ничего не говорят об архитектуре.
Чтобы получить честное сравнение, обе модели обучили на одной и той же машине без GPU: контейнер с 2 vCPU, один и тот же кусок корпуса, одно зерно, одинаковое число обновлений. PSSA держала 1 716 токенов в секунду, базовая модель — 415. Это 4,1 раза на совпадающем железе и одинаковой работе.
Как запустить
git clone https://github.com/Sparticle62ops/pssa.git
cd pssa
cargo build --release
./target/release/oxide_ai_pssa
Без аргументов программа показывает домашний экран со списком всех команд, а также найденными в рабочей папке чекпоинтами и корпусами.
Основные команды CLI
Общий вид: oxide_ai_pssa <COMMAND> [OPTIONS]
| Команда | Назначение |
|---|---|
train [source] |
Обучить чекпоинт на текстовом корпусе и записать файл .pssa |
generate <prompt> |
Продолжить промпт обученной моделью |
chat [source] или repl [source] |
Интерактивный цикл запросов к чекпоинту |
evaluate [source] |
Кросс-энтропия, перплексия и точность в виде JSON |
status |
Чекпоинты и корпуса в рабочей папке |
download <repo> |
Скачать датасет с Hugging Face в локальный файл |
clean-wikitext INPUT -o OUTPUT |
Очистить сырой WikiText в новый UTF-8 корпус |
benchmark |
Сквозная проверка на встроенном корпусе |
gpu-probe |
Проверить, доступно ли вычисление через WebGPU |
help |
Показать справку по командам и опциям |
Набор опций большой: размеры слоя и памяти, длина куска, скорость обучения, число шагов прогрева, зерно, семейство токенизатора, размер словаря, пропуск и ограничение по токенам, продолжение с чекпоинта. Полный список есть в README.
Обучение на длинном корпусе
Опции --skip-tokens, --max-tokens и --resume позволяют разбить длинный корпус на цепочку коротких прогонов. Каждый отрезок обучает своё окно и передаёт состояние оптимизатора следующему:
cargo run --release -- train data/downloaded.txt -e 1 \
  --skip-tokens 0      --max-tokens 200000 -o chain/ck01.pssa
cargo run --release -- train data/downloaded.txt -e 1 \
  --skip-tokens 200000 --max-tokens 200000 --resume chain/ck01.pssa -o chain/ck02.pssa
Скрипты kaggle_continue.sh и kaggle_transformer_baseline.sh делают это от начала до конца для двух цепочек: PSSA и подобранного по параметрам базового трансформера.
Что умеет подготовка данных
DatasetManager принимает один источник или список через запятую: встроенный эталонный корпус, локальный файл, каталог, HTTP(S)-ссылку или репозиторий на Hugging Face в виде hf:owner/dataset. Ответы со структурой сводятся к общим полям вроде text, content, article, story, instruction, output, sentence и summary. Ответ без подходящего текстового поля отклоняется.
Токенизатор работает на уровне байтов. Он сохраняет регистр UTF-8, пробелы, знаки препинания и переводы строк. Резервный алфавит покрывает все 256 байт, поэтому корректный UTF-8 никогда не превращается в <unk>. Прежний вариант с разбиением на слова по нижнему регистру доступен только с флагом --tokenizer word.
Команда clean-wikitext чистит сырой корпус до обучения: склеивает служебные вставки @-@, @.@ и @,@ с соседним текстом, убирает строки заголовков, удаляет <unk>, чистит пробелы вокруг знаков препинания и оставляет не больше одной пустой строки подряд. Очистка включается явно и не меняет существующие загрузчики. Важное предостережение авторов: нельзя переводить уже идущую цепочку продолжений на очищенный корпус, потому что очистка меняет идентификаторы токенов и смысл смещений в --skip-tokens.
Как устроен код
| Путь | За что отвечает |
|---|---|
src/main.rs |
Точка входа бинарника, передаёт аргументы в CLI |
src/cli.rs |
Разбор аргументов, домашний экран, обучение, чат, генерация, оценка, статус, загрузка, бенчмарк |
src/ui.rs |
Вывод в терминал: логотип, панели, индикаторы, полосы прогресса |
src/dataset.rs |
Токенизация, словарь, встроенные корпуса, локальная и сетевая загрузка, потоковая очистка WikiText |
src/pssa.rs |
Слой PSSA, проход вперёд, пластичное обучение, консолидация, сериализация .pssa |
src/checkpoint.rs |
Версии формата чекпоинта, данные для продолжения, проверка импорта и экспорта |
src/inference.rs |
Авторегрессивный сэмплинг и ограничения генерации |
src/backend.rs |
Диспетчеризация матричных умножений, эталонные ядра CPU, проверка WebGPU |
src/memory.rs |
Банк памяти фиксированной ёмкости, поиск и обновление |
src/adapter.rs |
Низкоранговые проекции адаптера и их обновления |
src/defense.rs |
Примитивы счётчика восстановления для защиты от лишней перезаписи |
src/linalg.rs |
Векторы, матрицы, математика и детерминированный генератор случайных чисел |
src/diagnostics.rs |
Форматирование баннера CLI |
Формат чекпоинта — V7: он хранит полные данные для продолжения обучения плюс встроенный JSON токенизатора с префиксом длины. Чекпоинт V7 с BPE самодостаточен и восстанавливает свой точный словарь. Команды generate и chat отклоняют --data для таких чекпоинтов, потому что переобучение токенизатора на внешних данных не проверяет происхождение словаря.
Чего в проекте пока нет
Список ограничений авторы ведут открыто, и он стоит прочитать до любых выводов.
- Это прототип, ориентированный на CPU, с рукописной линейной алгеброй. Команда
gpu-probeпроверяет WebGPU-устройство и одно матричное умножение против эталона, но сам слой при обучении и генерации считается на CPU. - Разбор аргументов в CLI намеренно минимальный: нет поддержки кавычек в стиле командной строки и почти нет проверок, кроме разбора чисел.
- Отсутствующий или нечитаемый датасет в нескольких местах молча подменяется встроенным научным корпусом.
- Форму модели нельзя менять внутри цепочки продолжений: латентная ширина, состояние, ключ, память и словарь должны совпадать с чекпоинтом.
- Размер модели и словаря токенизатора должны быть совместимы. Предупреждение о несовпадении размеров ничего не чинит.
- Загруженный контент может быть большим и содержать JSON, некорректный текст или данные, непригодные для обучения.
- Команда температуры внутри REPL принимает значение, но не меняет текущую конфигурацию.
- Бенчмарк печатает контрольные отметки и не измеряет перплексию, достоверность, задержку или безопасность.
- Сериализованные файлы
.pssa— внутренний формат проекта без инструментов миграции версий. - Два эксперимента ещё не измерены: сохраняются ли ранее выученные навыки после смены корпуса и меняется ли потеря, если убрать банк памяти.
Отдельно авторы оговаривают, что совпадение расписания оптимизатора работает только в одну сторону. Ни одна из моделей не получала настройку, которой не получала другая. Но расписание, подходящее PSSA, не обязано быть лучшим для трансформера, поэтому часть разрыва может объясняться недообученной базой. Сейчас идёт перебор скорости обучения для каждой модели по одной и той же сетке, и результаты обещают опубликовать, каким бы ни был исход.
Чем можно помочь
Проект открыт для issues и pull request. Больше всего рук нужно трём вещам: производительности ядер, современной рекуррентной базовой модели для сравнения и оценкам, которые выходят за пределю потери на следующий токен. Любую ветку стоит проверять командой cargo test --release до открытия pull request.
Лицензия
GPL-3.0. Текст лицензии лежит в файле LICENSE.
Источник: https://github.com/Sparticle62ops/pssa