

Chroma: открытая база данных для поиска по embeddings
📂 Исходный код на GitHubOpen-source векторная база данных Chroma: хранилище embeddings с векторным, гибридным и полнотекстовым поиском для RAG и AI-агентов.
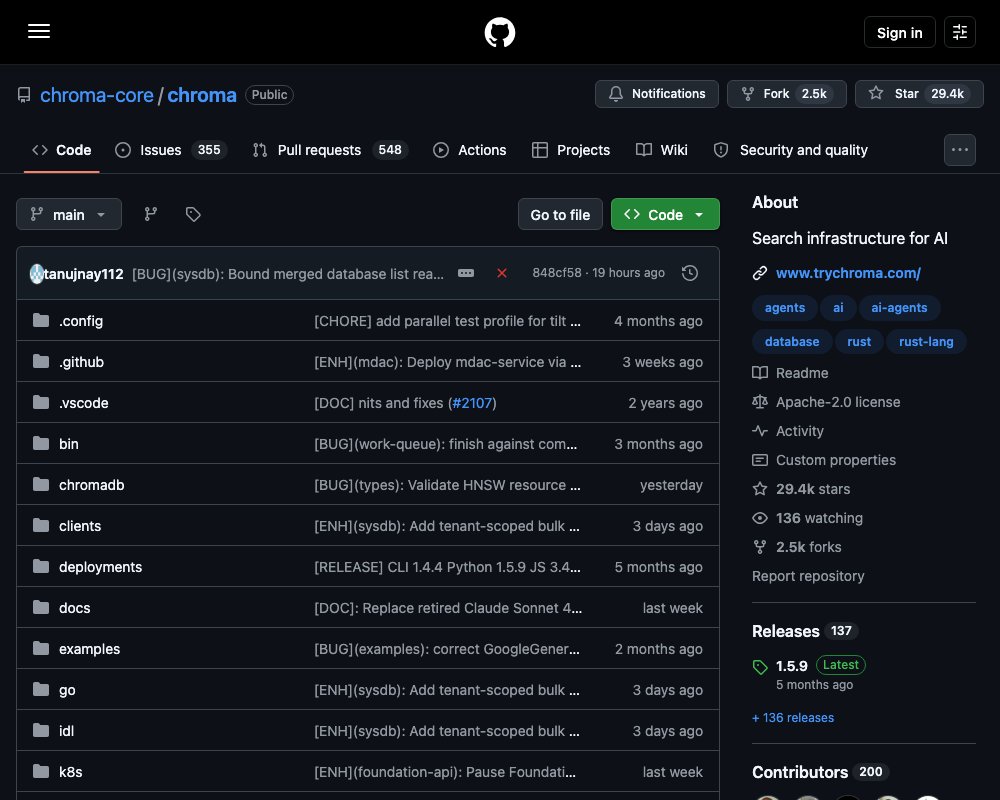
Chroma — это open-source база данных, созданная специально для AI-приложений. Проект называет себя «поисковой инфраструктурой для AI»: вы складываете в неё документы вместе с метаданными, а дальше ищете по векторному сходству, по ключевым словам или по регулярным выражениям. Ядро написано на Rust, клиенты есть для Python и JavaScript, лицензия — Apache 2.0. На GitHub у проекта около 29 тысяч звёзд и 2,5 тысячи форков.
Зачем нужна векторная база данных
LLM отвечает на основе того, что модель видела при обучении. Если вы хотите, чтобы она работала с вашими документами, базой знаний или кодовой базой, эти данные нужно где-то хранить и уметь быстро находить в них релевантное. Так возникает задача Retrieval-Augmented Generation (RAG): перед ответом модель получает фрагменты текста, найденные по смыслу.
Поиск по смыслу устроен так. Текст превращают в embeddings — числовые векторы большой размерности. Похожие по смыслу фрагменты дают близкие векторы. База данных хранит эти векторы и умеет находить ближайшие к вектору запроса. Именно это и делает Chroma.
Тот же механизм нужен и AI-агентам. Агент, который ищет по документации, помнит прошлые сессии или ищет по кодовой базе, постоянно выполняет поиск по векторам. Без специализированного хранилища построить такой агент сложно.
Минималистичный API
Главная идея Chroma — простота. Ядро API состоит всего из четырёх функций. Вот полный пример на Python:
import chromadb
# setup Chroma in-memory, for easy prototyping. Can add persistence easily!
client = chromadb.Client()

# Create collection. get_collection, get_or_create_collection, delete_collection also available!
collection = client.create_collection("all-my-documents")

# Add docs to the collection. Can also update and delete. Row-based API coming soon!
collection.add(
    documents=["This is document1", "This is document2"], # we handle tokenization, embedding, and indexing automatically. You can skip that and add your own embeddings as well
    metadatas=[{"source": "notion"}, {"source": "google-docs"}], # filter on these!
    ids=["doc1", "doc2"], # unique for each doc
)

# Query/search 2 most similar results. You can also .get by id
results = collection.query(
    query_texts=["This is a query document"],
    n_results=2,
    # where={S10: S11}, # optional filter
    # where_document={S12:S13}  # optional filter
)
Обратите внимание на вызов add. Вы передаёте обычный текст — Chroma сама токенизирует его, посчитает embeddings и построит индекс. Свои векторы тоже можно передать, если вы работаете с конкретной моделью. Клиент ставится одной командой: pip install chromadb для Python или npm install chromadb для JavaScript.
Что умеет Chroma
Возможности проекта покрывают весь цикл поиска для AI-приложений:
| Возможность | Что даёт |
|---|---|
| Хранение документов | Документы и метаданные лежат в одной коллекции |
| Embeddings | Подходит любая модель: OpenAI, Cohere, Hugging Face, sentence-transformers |
| Векторный поиск | Dense, sparse и hybrid-режимы, можно комбинировать стратегии |
| Полнотекстовый поиск | Поиск по ключевым словам и regex без embeddings |
| Фильтрация по метаданным | Условия на метаданные применяются в момент запроса |
| Мультимодальность | Индексация и поиск по изображениям, аудио и тексту |
Несколько пунктов стоит разобрать подробнее.
Гибридный поиск. Dense-поиск ищет по векторам и находит смысловое сходство. Sparse-поиск работает по точным совпадениям слов. Иногда нужен и тот и другой: смысловая близость ловит перефразировки, а точное совпадение — редкие термины, имена и идентификаторы. Chroma поддерживает оба режима и их комбинацию.
Полнотекстовый и regex-поиск. Не каждый запрос требует embeddings. Найти документы по конкретному слову или шаблону можно напрямую, без векторизации. Это ускоряет простые запросы и упрощает отладку.
Фильтрация по метаданным. Каждому документу при добавлении можно назначить метаданные: источник, дату, раздел, автора. В момент запроса вы накладываете условия на эти поля и сужаете выборку до нужной части коллекции.
Мультимодальность. Кроме текста Chroma индексирует изображения и аудио. Это позволяет искать, например, по скриншотам или записям, а не только по документам.
Режимы работы
Chroma запускается по-разному в зависимости от задачи.
В памяти. Режим по умолчанию из примера выше. Ничего не сохраняется на диск, зато идеально для прототипов и тестов.
С сохранением на диск. Тот же код, но с указанием пути к каталогу. Данные сохраняются при перезапуске процесса.
Клиент-сервер. Chroma поднимается как отдельный сервис командой chroma run --path /chroma_db_path. Приложение обращается к нему по сети. Этот режим нужен, когда базой пользуются несколько клиентов или когда её нельзя держать внутри процесса приложения. Для развёртывания в репозитории есть Docker-файлы и конфигурации для Kubernetes.
Chroma Cloud. Облачная версия от разработчиков. Она даёт serverless-хранилище с векторным, гибридным и полнотекстовым поиском без собственной инфраструктуры. Для пробы дают 5 долларов кредитов, а база создаётся меньше чем за минуту.
Chroma и AI-агенты
Для читателей этого сайта важнее всего другое: Chroma хорошо ложится на задачи AI-агентов.
В документации есть готовые примеры проектов. Один из них — agentic search: агент итеративно ищет по базе, оценивает результаты и уточняет запросы, пока не соберёт ответ на сложный вопрос. Второй — code search: индексация кодовой базы с учётом абстрактного синтаксического дерева, чтобы coding-агент находил нужные функции и классы, а не просто совпадения строк.
Показательно и то, что сам репозиторий Chroma содержит файлы AGENTS.md и CLAUDE.md — инструкции для AI-агентов, помогающих разрабатывать проект. Команда использует ассистентов в собственном рабочем процессе и делится конфигурацией открыто.
На практике Chroma чаще всего применяют в связках вида «документы или код → embeddings → Chroma → релевантные фрагменты → LLM». Это универсальный строительный блок для чат-ботов по документации, ассистентов по кодовой базе и агентов с долговременной памятью.
Где это пригождается
Несколько типовых сценариев.
Чат-бот по документации. Разбиваете документы на фрагменты, кладёте в Chroma вместе с метаданными разделов. На вопрос пользователя ищете релевантные фрагменты и передаёте их модели. Фильтрация по метаданным помогает отвечать в рамках конкретного раздела или версии продукта.
Ассистент по кодовой базе. Индексируете файлы проекта с учётом синтаксиса, и агент находит нужные функции и классы по смыслу задачи, а не по точному совпадению имени.
Память агента. Важные факты и решения из диалогов сохраняются как записи в коллекции. В новой сессии агент находит их по смыслу текущей задачи и не начинает с нуля.
Поиск по мультимедийным данным. Скриншоты интерфейсов, аудиозаписи встреч, галереи изображений — всё это индексируется рядом с текстом и ищется единым механизмом.
Экосистема и лицензия
Проект активно развивается: за историю репозитория накопилось более 4600 коммитов. Новые версии Python- и JavaScript-пакетов выходят по понедельникам, хотфиксы — в любой день недели.
Полезные ссылки:
Лицензия Apache 2.0 разрешает свободное использование в коммерческих проектах. Проект открыт для контрибьюторов: в трекере есть issues с меткой good first issue, а roadmap опубликован в документации. Если вы хотите попробовать векторный поиск или добавить памяти своему агенту, Chroma — самый короткий путь от нуля до работающего прототипа.
Источник: https://github.com/chroma-core/chroma