VoiceStudio — открытая локальная альтернатива ElevenLabs: клонирование голоса, дубляж и расшифровка речи на 646 языках
📂 Исходный код на GitHubОткрытая полностью локальная альтернатива ElevenLabs: клонирование голоса, синтез речи, дубляж видео, диктовка, расшифровка аудио и создание аудиокниг на 646 языках. Работает на macOS, Windows, Linux, Docker, Android и iOS. Основной язык — Python, лицензия AGPL-3.0.
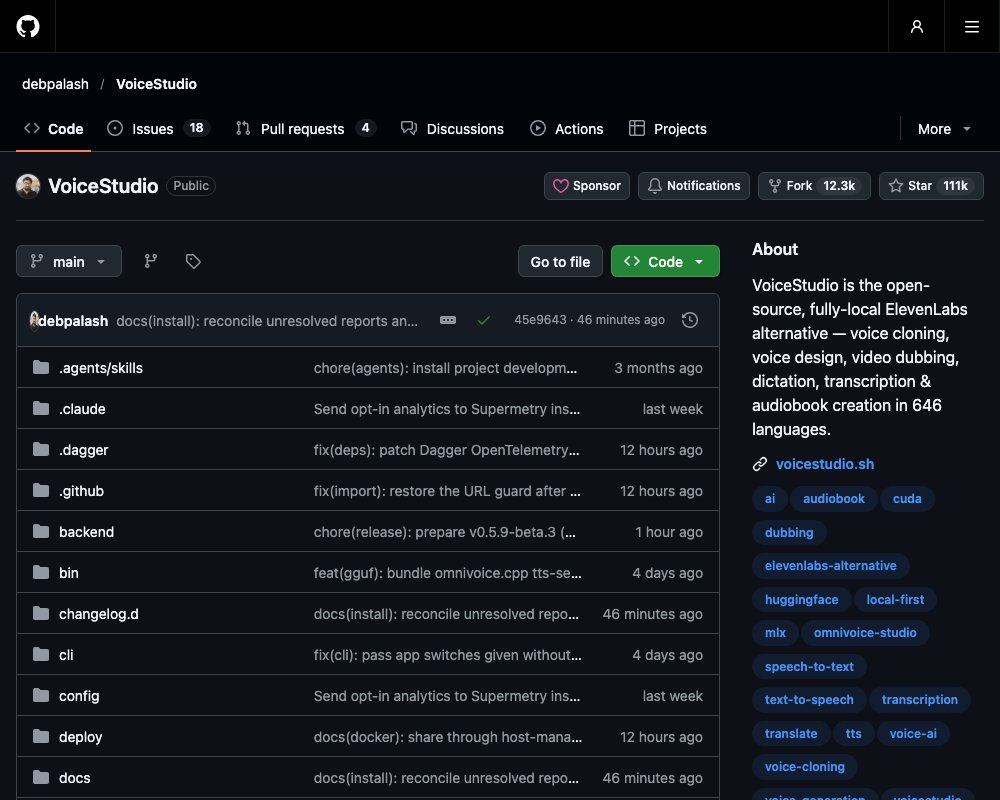
VoiceStudio — приложение с открытым кодом для работы с голосом. Оно клонирует голос по короткой чистой записи, синтезирует речь по тексту, дублирует видео на другие языки, расшифровывает аудио и озвучивает книги. Всё считается на вашем устройстве: на компьютере, сервере или телефоне. Облако и аккаунт не нужны. Проект заявляет поддержку 646 языков. Код распространяется под лицензией AGPL-3.0, у репозитория больше 110 тысяч звёзд на GitHub, основной язык — Python.
Сайт проекта: voicestudio.sh. Репозиторий: debpalash/VoiceStudio.
Что умеет
- Клонирование голоса. Вы даёте чистую запись голоса — приложение озвучивает любой текст этим голосом.
- Дизайн голоса. Новый голос можно не записывать, а описать словами: пол, возраст, тембр, стиль, акцент. Программа сгенерирует его с нуля.
- Дубляж видео. VoiceStudio переводит речевую дорожку и накладывает новую речь, подогнанную по таймингу к оригиналу. Для роликов, где говорят несколько человек, есть отдельный гайд по многоголосому дубляжу.
- Диктовка и расшифровка. Плавающий виджет диктовки вставляет надиктованный текст в любое приложение. Распознавание речи тоже локальное и работает без интернета.
- Озвучка и пакетные задачи. Длинные тексты, аудиокниги и очереди заданий.
- Разделение говорящих и изоляция вокала. Диаризация определяет, кто именно сказал каждую фразу. Изоляция вокала вытягивает голос из фонограммы.
Полный список функций и движков — в каталоге возможностей.
Движки и модели
По умолчанию используется движок OmniVoice от k2-fsa. Через встроенный Model Manager ставятся десятки других: CosyVoice 3, IndexTTS 2.5, KittenTTS, MLX-Audio, GPT-SoVITS, sherpa-onnx и другие. Для расшифровки речи на выбор WhisperX (по умолчанию), Faster-Whisper, Parakeet, Moonshine, FunASR и любые серверы с OpenAI-совместимым API.
Приложение спрашивает разрешение перед загрузкой каждой модели. Вы качаете только то, что реально нужно, и сразу видите лицензию каждой модели в Model Manager.
Без видеокарты тоже работает — просто медленнее. Поддерживаются NVIDIA CUDA, AMD ROCm (на Windows пока экспериментально), Vulkan для GGUF-движков и Metal на Apple Silicon. Замеры скорости на разном железе собраны в таблице производительности.
Локальный API
Для разработчика здесь самое интересное: VoiceStudio — не только приложение, но и локальный речевой сервис. Python-бэкенд держит модели загруженными и отдаёт HTTP API на порту 3900. Он же принимает потоковое аудио по WebSocket — можно подключить свой источник звука и получать текст в реальном времени. Схема возможностей отдаётся по адресу /.well-known/voicestudio-speech, поэтому API одинаково работает за Tailscale или обратным прокси. Для скриптов и хуков есть консольный мост без зависимостей:
python -m backend.speech_client transcribe recording.wavПодробности — в документации локального API.
MCP-сервер и скиллы для агентов
В приложение встроен MCP-сервер. Он монтируется на работающий бэкенд по адресу http://localhost:3900/mcp/, отдельно запускать ничего не нужно. Агенты вроде Claude Code или Cursor получают инструменты:
| Инструмент | Что делает |
|---|---|
generate_speech |
озвучивает текст голосом агента или выбранным профилем |
clone_voice |
создаёт новый профиль голоса из референсной записи |
design_voice |
создаёт голос из текстового описания |
transcribe |
расшифровывает аудио на 646 языках |
list_voices, check_health |
список голосов, статус бэкенда и активного GPU |
Авторы продумали экономию контекста. WAV-файл в base64 занимает много токенов, поэтому переменная OMNIVOICE_MCP_OUTPUT_MODE=files переключает выдачу на путь к готовому файлу на диске вместо байтов в диалоге. Путь ограничен переменной OMNIVOICE_MCP_BASE_PATH — это граница безопасности, за пределы которой агент читать и писать не может. Детали — в документации MCP.
Есть и готовые скиллы для агентов:
npx skills add debpalash/VoiceStudioСкилл voicestudio учит агента работе со звуком через приложение, voicestudio-maintainer — работе с самим репозиторием. Установка приложения тоже описана как задача для агента: вставляете промпт из инструкции, и Claude Code или Codex ставит VoiceStudio и проверяет, что всё работает.
Платформы и установка
| Платформа | Способ установки |
|---|---|
| macOS 13.3+ | Homebrew, DMG, скрипт-установщик; на Apple Silicon через Metal |
| Windows 10/11 x64 | PowerShell-установщик или EXE; CUDA, ROCm опционально, CPU |
| Linux x64 | AUR, Snap, DEB, AppImage, Nix; CUDA, Vulkan, CPU |
| Docker | образы GHCR и Docker Hub; CPU, CUDA, ROCm |
| Android 10+ | APK, F-Droid-репозиторий, Obtainium; офлайн после загрузки моделей |
| iOS/iPadOS 17+ | IPA с ручной подпиской |
Установка одной командой:
curl -fsSL https://voicestudio.sh/install | shДля macOS через Homebrew:
brew tap debpalash/tap
brew install --cask debpalash/tap/voicestudio
Готовые сборки — на странице релизов. Все инструкции по установке собраны в документации.
Pro и Cloud
Базовое приложение бесплатно и не требует аккаунта. Платные варианты необязательны:
- VoiceStudio Pro — для коммерческой работы с клиентами: коммерческая лицензия, один пользователь на трёх устройствах одновременно, отправка задач на другие свои GPU, ранний доступ к новым функциям.
- VoiceStudio Cloud — хостинговый API для речи и дубляжа, ещё в разработке; сейчас открыт ранний доступ.
При этом AGPL-3.0 разрешает коммерческое использование самого приложения на условиях лицензии. Pro нужен не всегда, а только если условия AGPL вам не подходят.
Ответственное использование
Клонировать можно только голос с разрешения его владельца — это прямо написано в дисклеймере проекта. Лицензия AGPL-3.0 покрывает само приложение, а веса моделей, голоса и результат генерации живут под своими лицензиями; Model Manager показывает их для каждой модели.
Источник: https://github.com/debpalash/VoiceStudio