

DeepInfer — высокопроизводительный движок инференса от DeepSeek
📂 Исходный код на GitHubОпенсорсный движок инференса от DeepSeek AI для моделей DeepSeek. Оптимизированные ядра, параллелизм по экспертам, спекулятивное декодирование, детерминированная выборка и структурированный вывод. Поддерживает NVIDIA SM100 и Huawei Ascend 950.
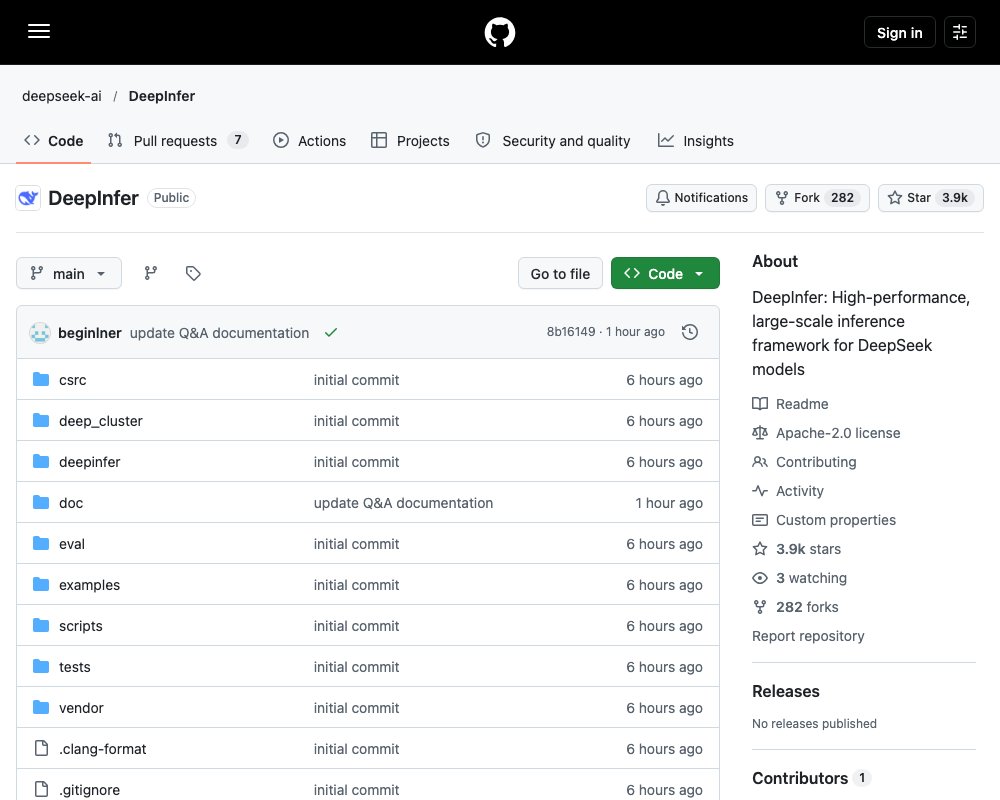
DeepInfer — движок инференса, на котором DeepSeek AI держит свои сервисы
DeepInfer — это движок инференса от компании DeepSeek AI. На нём работают её собственные продакшн-сервисы, а в октябре 2026 года проект выложили в открытый доступ. Это не набор разрозненных скриптов: в репозитории лежат оптимизированные ядра, планировщик, реализация параллелизма и готовые примеры для офлайн-инференса.
Сразу стоит обозначить главное ограничение. Этот релиз — офлайн-инференс, то есть обработка пачки запросов в один запуск. Постоянно работающего HTTP-сервера с балансировкой нагрузки в репозитории нет. Всё, что нужно для полноценного сервиса, авторы перечислили отдельным списком: система KV-кэша, разделение предзаполнения и генерации по разным узлам и балансировка между репликами.
Зато всё, что касается самого вычисления, сделано на уровне промышленного движка: свои ядра, свой планировщик, спекулятивное декодирование, детерминированная выборка токенов и структурированный вывод.
Поддерживаемые модели и железо
На момент публикации движок поддерживает одну модель — DeepSeek-V4.1-Flash. Веса лежат на Hugging Face под именем deepseek-ai/DeepSeek-V4.1-Flash-1017. При первом запуске они скачиваются в кэш Hugging Face, а переменная окружения DEEPINFER_HF_MODEL_DIR указывает на локальную копию, если сеть недоступна.
По оборудованию список тоже короткий, но покрывает две большие платформы:
| Платформа | Требования |
|---|---|
| NVIDIA | Видеокарты архитектуры SM100, CUDA 13 |
| Huawei Ascend | Ускорители Ascend 950, CANN 9.2 |
Общие требования: Linux, GCC новее 13.0 и Python 3.12. Это не «работает где угодно» — фреймворк заточен под большие ускорители и под крупные модели со смесью экспертов.
Оптимизированные ядра
Главный источник скорости — собственные реализации ядер, а не готовые библиотеки. В списке числятся FlashMLA, DeepGEMM, DeepEP, TileKernels, DeepSelect и собственные ядра на TileLang, которые лежат в каталоге deepinfer/model_executor/layers/tilelang_ops.
Часть ядер вынесена в отдельные репозитории, остальные лежат внутри DeepInfer. Вместе они покрывают самые дорогие операции: самовнимание, умножение матриц, маршрутизацию токенов по экспертам и обработку изображений для мультимодальной части.
Параллелизм
DeepInfer поддерживает несколько независимых способов разложить модель по устройствам:
- Параллелизм по данным для самовнимания — реплики обрабатывают разные запросы.
- Сбалансированный контекстный параллелизм — длинный контекст делится между ускорителями.
- Параллелизм по экспертам — эксперты смешанной модели (MoE) раскладываются по разным GPU.
- EPLB — механизм, который следит за тем, как распределяется нагрузка по экспертам, и перекладывает «горячие» эксперты на простаивающие ускорители.
Число лишних (резервных) экспертов задаётся переменной DEEPINFER_OVERRIDE_NUM_EXTRA_EXPERTS и по умолчанию равно 32. Это нижняя граница: движок округляет общее число экспертов вверх так, чтобы оно делилось на число ускорителей.
Спекулятивное декодирование: DSpark
Быстрый способ ускорить генерацию — сначала черновик, потом проверка. Модель сначала выдаёт несколько черновых токенов, затем основная модель проверяет их все за один проход. Если черновик угадан, выигрыш заметный.
DeepInfer реализует этот приём через механизм DSpark. Он работает в два этапа: движок готовит черновые токены, а затем оценивает уверенность в них и решает, какие запросы стоит проверять в первую очередь.
Включается это двумя переменными окружения:
| Переменная | Смысл |
|---|---|
DEEPINFER_ENABLE_MTP_VARLEN |
Включает сам механизм |
DEEPINFER_USE_NEXTN_DECODE |
Максимальная длина черновика, по умолчанию 5 |
Скользящее окно внимания и ограниченный повтор
Модели DeepSeek используют скользящее окно внимания (SWA): при обработке длинного промпта модель смотрит не на всю последовательность, а на последние несколько тысяч токенов. Проблема в том, что предзаполнение всё равно считает всю входную последовательность.
DeepInfer решает это переигровкой: движок пересчитывает только ограниченный суффикс промпта, а не весь. Настройки по умолчанию для модели V4.1:
export DEEPINFER_YOCO_PREFILL_TRUNCATION_MODE=compact
export DEEPINFER_YOCO_PREFILL_KEEP_TOKENS=140
Сохраняемый суффикс должен покрывать и окно SWA, и максимальную длину отката. Что это даёт на практике, можно проверить отдельно: в репозитории есть скрипт examples/yoco/yoco_equiv.py, который сравнивает два режима усечения — mask и compact — и убеждается, что они дают одинаковый результат.
Асинхронное планирование
Обычно планировщик работает на CPU и ждёт, пока ускорители закончат предыдущий шаг. DeepInfer перекрывает эти фазы: планирование следующего батча идёт параллельно с вычислением текущего. Функция называется zero-overhead scheduling — «планирование без накладных расходов» — и включена по умолчанию.
Отдельная деталь: в движке есть отложенное освобождение ресурсов. Объекты, которые выделил текущий шаг, освобождаются не сразу, а на следующем цикле — так, чтобы вычислительный код успел дочитать их до конца, а освобождение прошло уже параллельно с работой GPU.
Одинаковый результат при разном составе батча
Обычно результат генерации зависит от того, какие ещё запросы стояли в батче. Один и тот же промпт, отправленный в одиночку и в паре с другими запросами, может дать разные токены: из-за порядка вычислений меняются округления в численном коде.
DeepInfer умеет избавиться от этого. Переменная DEEPINFER_BATCH_INVARIANT=1 (только для NVIDIA) делает результат независимым от состава батча. Это полезно для тестов, где нужно сравнивать прогоны друг с другом.
Отдельно есть детерминированная выборка. Если задать DEEPINFER_BATCH_INVARIANT=1, отключить MTP через DEEPINFER_ENABLE_MTP_VARLEN=0 и передать в SamplingParams фиксированное значение seq_seed, одинаковые входные токены и одинаковые параметры выборки дадут идентичный вывод.
Структурированный вывод
Модель можно заставить выдавать результат строго по правилам. В SamplingParams есть поле so_args, куда передаются тип и правило:
schema_type: "regex"— ограничение регулярным выражением;schema_type: "json"— ограничение схемой JSON;schema_type: "ebnf"— ограничение грамматикой EBNF.
Под капотом стоит библиотека xgrammar: она строит маску допустимых токенов, и модель физически не может выдать токен, который нарушает правило. Пример с проверкой всех трёх режимов лежит в файле examples/_structured_output.py.
Сборка
Перед сборкой нужно создать и активировать пустое окружение Python 3.12. Дальше всё делает один скрипт:
export DEEPINFER_ACCELERATOR=nvidia
./build.sh
Для платформы Ascend вместо nvidia указывается ascend. Переменная DEEPINFER_ACCELERATOR должна оставаться экспортированной во время работы — по ней выбирается платформенная сборка расширения.
Скрипт build.sh ставит зависимости из requirements-nvidia.txt, собирает вендорные библиотеки и только потом сам DeepInfer. Для NVIDIA дополнительно патчится NCCL до версии 2.32.3.
Первый запуск
Офлайн-инференс запускается одним скриптом:
python examples/offline_inference.pyСкрипт examples/offline_inference.py принимает параметры --ep (число ускорителей под эксперты), --dp (параллелизм по данным) и --cp (контекстный параллелизм). Например, так выглядит запуск на восьми ускорителях:
python examples/offline_inference.py --ep 8
python examples/offline_inference.py --ep 2 --dp 8
python examples/offline_inference.py --ep 2 --cp 8
Все примеры описаны в examples/README.md.
Python API
Движок можно использовать и как библиотеку. Класс LLM прячет внутри себя движок, токенизатор и управление памятью, а наружу отдаёт метод generate:
from deepinfer.entrypoints.llm import LLM
from deepinfer.sampling_params import SamplingParams

llm = LLM(
    model="deepseek-ai/DeepSeek-V4.1-Flash-1017",
    expert_parallel_size=8,
    trust_remote_code=True,
    gpu_memory_utilization=0.85,
    max_model_len=32768,
)

params = SamplingParams(temperature=0.6, max_tokens=256)
outputs = llm.generate(
    prompts=["Объясни простыми словами, зачем нужен спекулятивный декодинг."],
    sampling_params=params,
)

text = llm.get_tokenizer().decode([token.token_id for token in outputs[0]])
print(text)
Параметры SamplingParams знакомы по API OpenAI: temperature, top_p, top_k, max_tokens, ignore_eos. Сверху добавлены seq_seed для воспроизводимости и so_args для структурированного вывода.
Бенчмарки производительности
Замеры проводились на ускорителях NVIDIA SM100: для этапа предзаполнения взяли 4 ускорителя, для генерации — 64. Оба замера умещались в пределы одного домена масштабирования.
Результаты лежат в репозитории в виде двух картинок с кривыми Парето: для предзаполнения это зависимость пропускной способности от задержки на некэшированном вводе, для генерации — зависимость пропускной способности от скорости для одного пользователя. Воспроизвести замеры можно скриптом examples/sweep/run_sweep.sh, а построить графики — через examples/sweep/plot_pareto.py.
Сам инструмент замеров — examples/benchmark.py. Он печатает три ключевые метрики: пропускную способность предзаполнения в токенах в секунду на один GPU, скорость генерации шагов в секунду и пропускную способность генерации с учётом полного приёма черновиков.
Проверка качества моделей
Отдельный каталог eval/README.md описывает офлайн-оценку на трёх наборах задач:
| Набор | Задач | Ответов на задачу | Метрика |
|---|---|---|---|
| AIME 2026 | 30 | 32 | Средняя точность по 32 ответам |
| HLE | 2500 | 1 | Точность по одному ответу |
| GPQA Diamond | 198 | 8 | Средняя точность по 8 ответам |
Генерация и подсчёт баллов разнесены по разным стадиям. Сначала движок пишет сырые ответы на диск, потом отдельный скрипт их оценивает. Благодаря этому пересчитать метрики можно, не запуская модель заново.
Чего в репозитории нет
Стоит честно перечислить, чего в репозитории нет:
- KV-кэш как отдельная система — её нужно взять со стороны или написать самому.
- Разделение предзаполнения и генерации по разным узлам (VE / Prefill / Decode). Авторы отмечают, что основная часть нужной логики движка уже реализована.
- Балансировка нагрузки между репликами с параллелизмом по данным — и для предзаполнения, и для генерации.
- Постоянно работающий HTTP-сервер для онлайн-обслуживания.
Проект и лицензия
DeepInfer написан преимущественно на Python с критическими частями на C++ и CUDA. Лицензия — Apache 2.0, текст лежит в файле LICENSE.
Проект вырос из vLLM — об этом сказано прямо в разделе благодарностей. Авторы признают влияние SGLang и TensorRT-LLM. Это важный контекст: многое в интерфейсе знакомо тем, кто уже работал с vLLM, но кодовая база заметно переписана — свой планировщик на C++, свои ядра, свой слой параллелизма.
На момент публикации у репозитория около 3.3 тысячи звёзд и 240 форков.
Итог
DeepInfer стоит рассматривать как специализированный инструмент, а не как универсальную замену vLLM. Он закрывает ровно одну задачу: быстро прогонять модели DeepSeek-V4.1-Flash на очень крупном железе, с упором на параллелизм по экспертам, спекулятивное декодирование и воспроизводимые результаты.
Если вам нужен офлайн-инференс на кластере из SM100 или Ascend 950 — это в точности его профиль. Если нужен лёгкий способ «просто запустить модель и поговорить с ней» — это не тот инструмент, и тут лучше посмотреть на vLLM.
Источник: https://github.com/deepseek-ai/DeepInfer