

Simple Jev
📂 Исходный код на GitHubTurn any open model into a classifier/jev endpoint
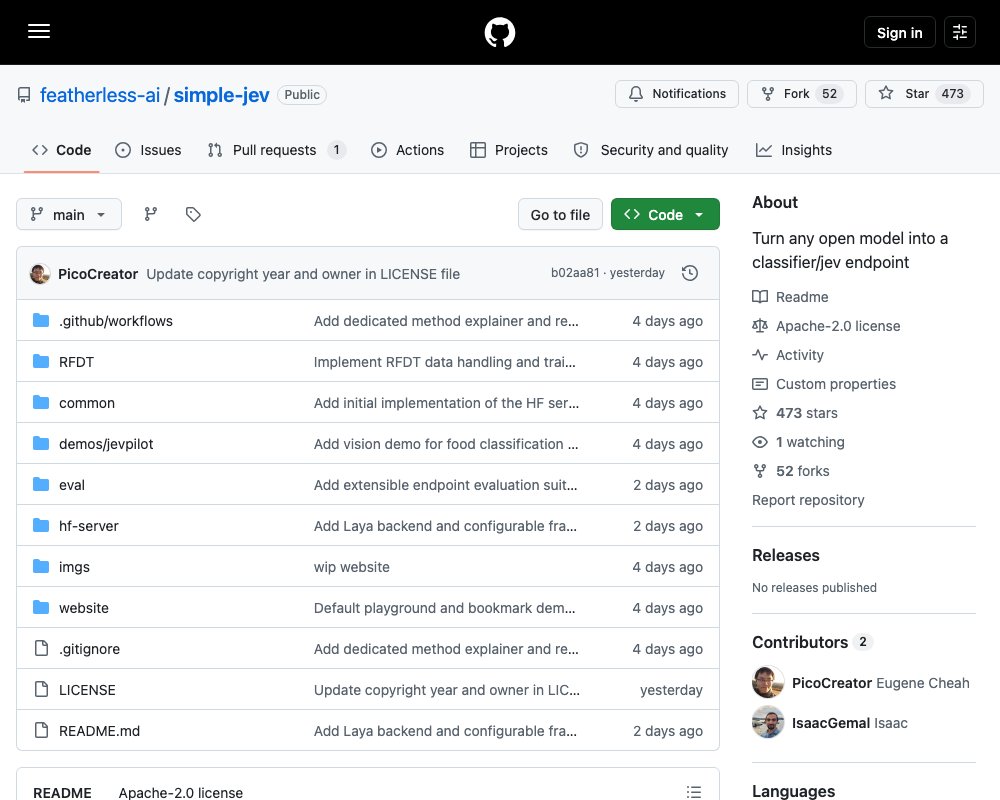
Simple Jev — проект от Featherless, который превращает любую совместимую open-модель с Hugging Face в classifier-эндпоинт без обучения отдельного classifier head. Вы отправляете общий контекст и набор вопросов, сервер читает next-token logits модели для каждого вопроса и сам собирает JSON-ответ с выборами, rubric-скорами или truth/support-суждениями. Модель ничего не генерирует построчно — ответ строится из скоров.
Демо, playground и документация доступны на simple-jev.featherless.ai. Текущая реализация работает локально на Hugging Face Transformers и PyTorch. Валидация запросов, версионированные prompt-инструкции и scoring ответов лежат в plain-Python каталоге common/, чтобы другие inference-реализации могли использовать те же правила.
Публичное демо API
Публичный demo API работает без логина, API key и аутентификации. Лимиты: контекст до 2k токенов, 2 запроса в секунду.
curl https://simple-jev-demo-api.featherless.ai/v1/modelsДемо уже отдаёт Gemma как featherless-ai/gemma-4-26B-A4B-classifier:
curl https://simple-jev-demo-api.featherless.ai/v1/classifier \
  -H 'Content-Type: application/json' \
  --data-binary @- <<'JSON'
{
  "model": "featherless-ai/gemma-4-26B-A4B-classifier",
  "state": "Mia owns a red bicycle.",
  "questions": {
    "color": {
      "type": "choice",
      "instructions": "What color is Mia's bicycle?",
      "criteria": {"red": null, "blue": null}
    }
  }
}
JSON
Для production-развёртывания выше лимиты дают платные тарифы Featherless.
Запуск HF-сервера
Нужен Python 3.12+ (команды ниже используют 3.13):
git clone https://github.com/featherless-ai/simple-jev.git
cd simple-jev
python3.13 -m venv .venv
source .venv/bin/activate

python -m pip install -e './hf-server'

python hf-server/hf_server.py \
  --model Qwen/Qwen3.5-0.8B \
  --device cpu --dtype float32 \
  --max-model-len 4096 \
  --max-batch-size 4 --max-batch-tokens 4096
Вариант с Gemma 4 MoE на NVIDIA GPU с BF16:
python hf-server/hf_server.py \
  --model google/gemma-4-26B-A4B-it \
  --device cuda --dtype bfloat16 \
  --max-model-len 8192 \
  --max-batch-size 4 --max-batch-tokens 8192
Есть и backend Laya для Typed Decisions с нативным encoder:
python -m pip install -e './hf-server[laya]'
USE_TF=0 python hf-server/hf_server.py \
  --backend laya \
  --model convaiinnovations/laya \
  --subfolder typed-decisions \
  --device cpu \
  --rope-factor 2 --max-model-len 2048
Первый запуск скачивает модель, если её нет в кеше. В --model можно передать и локальную директорию. Для CUDA/ROCm сначала установите соответствующий build PyTorch. GPU-пример с Gemma 4 26B-A4B Instruct — пример запуска, а не verified benchmark: память нужна под веса, KV cache и inference-буферы; sparse активация экспертов не означает, что в памяти только активные эксперты. --device auto позволяет Transformers распределить веса по доступным устройствам.
Сервер слушает http://127.0.0.1:8000. После загрузки модели:
curl http://127.0.0.1:8000/healthИнтерактивная документация API — на http://127.0.0.1:8000/docs. После установки команды simple-jev и python -m hf_server принимают те же аргументы, что и скрипт. Детали бэкенда Laya — в hf-server/README.md.
API
Отправляйте non-streaming POST /v1/classifier. Значение model должно точно совпадать с ID или путём, на котором запущен сервер. Ровно одно из двух полей:
state— строка, JSON-объект или JSON-массив с общим контекстом;messages— текстовая chat-история, рендерится через собственный chat template модели.
/v1/systemone — алиас /v1/classifier, реализация одна. Контракт для клиентов — API reference. Пример запроса с тремя типами вопросов:
curl http://127.0.0.1:8000/v1/classifier \
  -H 'Content-Type: application/json' \
  --data-binary @- <<'JSON'
{
  "model": "Qwen/Qwen3.5-0.8B",
  "state": "Mia owns a red bicycle. Her dog is named Max.",
  "questions": {
    "color": {
      "type": "choice",
      "instructions": "What color is Mia's bicycle?",
      "criteria": {"red": null, "blue": null}
    },
    "support": {
      "type": "score",
      "instructions": "How well does the context support that Mia owns a bicycle?",
      "criteria": ["Unsupported", "Partially supported", "Fully supported"]
    },
    "dog": {
      "type": "noul",
      "instructions": "Is Mia's dog named Max?"
    }
  }
}
JSON
ID вопросов становятся ключами в answers. Типы вопросов:
| Тип | Входные criteria | Результат |
|---|---|---|
choice |
Объект с 2–50 candidate ID и опциональными описаниями | Кандидат с наибольшей вероятностью, его confidence и распределение. |
score |
Массив из 2–50 rubric-уровней, от низшего к высшему | Нулевой индекс rubric, confidence, распределение и legend. Трёхуровневый rubric даёт значение от 0 до 2, включая дробные. |
noul |
Опциональные описания true и/или false |
Truth/support-суждение от 0.01 до 0.99 из распределения модели по девяти rating-токенам. |
Для chat-входа отправляйте messages вместо state — например, классификация обращения клиента с маршрутизацией в billing/technical и определением запроса на возврат. Неизвестные top-level поля запроса игнорируются (включая temperature, max_tokens, stream); неизвестные поля внутри questions и options отклоняются. Сэмплинга и стриминга нет. HF-сервер пока поддерживает только текст.
usage.input_tokens считает уникальные token-префиксы запроса, разделяя общий контекст между вопросами; usage.output_tokens всегда ноль — токены не генерируются. Для диагностики запускайте сервер с ENABLE_OPEN_JEV_ADVANCED_METRICS=1, а в запрос добавляйте "options": {"raw_logits": true}.
Зачем classifier и «System One»
Classifier отображает вход в заданный набор ответов: сообщение поддержки маршрутизируется в billing или technical, срочность оценивается по ordered rubric, запрос возврата — бинарное суждение. Результаты напрямую попадают в обычный application code.
TypeSafe называет «System One» модели для быстрых структурированных решений — по аналогии с быстрым интуитивным мышлением против медленного обдумывания (см. intro to System One and Jev). Simple Jev исследует такой интерфейс на существующих open-моделях, не воспроизводя архитектуру и обучение TypeSafe и не заявляя эквивалентных accuracy, calibration или скорости.
Как меняется использование модели:
- Общий prompt builder создаёт консистентные classifier-инструкции и по одной scoring-ветке на вопрос.
- HF-сервер рендерит инструкции и контекст в нативный chat-формат модели.
- Общий точный token-префикс вычисляется один раз, его KV cache переиспользуется для батчей question-суффиксов.
- Читаются next-token logits для допустимых answer-лейблов, общий scorer нормализует скоры и собирает JSON.
Так не нужно генерировать и парсить prose или JSON по токенам. Валидная структура ответа не гарантирует правильность решения — capability модели и формулировка вопроса тоже важны, качество ответов стоит оценивать отдельно.
Prefill-only scoring и общий префикс
Обычный text-generation состоит из prefill (обработка входа) и decode (генерация токенов). Prefill уже даёт logits следующего токена — Simple Jev использует их напрямую для скоринга заранее заданных лейблов, без авторегрессивного цикла.
Когда несколько вопросов относятся к одному контексту, большая часть промпта совпадает. После применения chat template и токенизации сервер находит точный общий token-префикс:
Shared instructions + context + shared question briefing
                           │
                     Prefill once
                     Save KV cache
                           │
         ┌─────────────────┼─────────────────┐
         ▼                 ▼                 ▼
  Color question    Support question    Dog question
         │                 │                 │
    Label logits      Label logits      Label logits
         └─────────────────┼─────────────────┘
                           ▼
                JSON built by the server
KV cache хранит attention-состояние общего префикса; каждый вопрос продолжает с копии кеша и своим суффиксом. Суффиксы батчируются, logits читаются по последнему реальному токену строки, выбранные лейбл-скоры уходят в общий scorer. Вопросы не используют ответы друг друга.
Пример: четыре промпта с общим префиксом в 1 000 токенов и суффиксом в 50:
| Способ | Обработано prompt-токенов, без padding |
|---|---|
| Каждый промпт отдельно | 4 × (1,000 + 50) = 4,200 |
| Переиспользование общего префикса | 1,000 + 4 × 50 = 1,200 |
Это иллюстрация экономии на повторной обработке входа, а не измеренное latency-соотношение: каждый суффикс всё равно attends к закешированному префиксу, у копирования кешей и padding есть свои накладные расходы. --max-batch-size ограничивает вопросы в батче суффиксов, --max-batch-tokens — число padded suffix-токенов. Кеш переиспользуется внутри одного запроса, запросы обрабатываются последовательно. Подробности — в HF execution guide.
Структура проекта
| Путь | Назначение |
|---|---|
common/ |
Plain-Python модули: ClassifierRequest, prompt planning, response scoring. |
common/PROMPT_STRUCTURE_V1.md |
Языконезависимая v1-спецификация: входы, prompt-строки, chat-роли, answer-лейблы, правила scoring. |
hf-server/hf_server.py |
Однофайловая Transformers-реализация: chat-рендеринг, загрузка модели, cached inference, HTTP API, CLI. |
hf-server/API_REFERENCE.md |
Контракт request/response, валидация, диагностика, конфигурация. |
RFDT/ |
Task-specific decision training: подготовка меток, distillation teacher-оценок, обучение на answer-token logits, экспорт student-модели. |
prepare_prompt(request, version="v1") возвращает cacheable system-prompt prefix, prefix instruction, suffix instruction и упорядоченные вопросы. Версия фиксирует конфигурацию prompt/scoring для консистентности между реализациями, включая другие языки; по умолчанию v1, HTTP API сейчас использует только её.
Тесты
python -m pip install -e './hf-server[test]'
python -m pytest -c hf-server/pyproject.toml common/tests hf-server/tests -q
Тесты покрывают валидацию запросов, построение prompt, response scoring, tensor/token маппинг, HTTP-поведение и cached-versus-full inference на крошечных локально инициализированных моделях. Скачивание pretrained-весов не требуется, accuracy они не измеряют.
Модели должны иметь поддерживаемую реализацию Transformers, рабочий chat template, совместимые cache-операции, а answer-лейблы — продлевать rendered prompt ровно на один различимый токен. Сервер проверяет токенизацию лейблов; совместимость со всеми open-моделями не гарантируется.
RFDT: Really Fancy Decision Training
RFDT позволяет дообучить меньшую модель под конкретный use case: предоставьте контекст или chat-историю, вопросы и ответы — или дайте более крупной teacher-модели проставить недостающие ответы.
RFDT обучается напрямую на допустимых answer-token logits по той же prompt-структуры, что и inference Simple Jev. Скрипты поддерживают подготовку dataset, teacher labeling, multi-GPU training, LoRA-адаптеры, evaluation и экспорт в HF-сервер — см. RFDT guide and examples. Скрипты RFDT доступны в репозитории уже сейчас; поддержка hosted fine-tuned моделей и fine-tuning на платформе Featherless заявлена как предстоящий rollout.