

llmtrim — локальное сжатие LLM-запросов и экономия токенов
📂 Исходный код на GitHubЛокальный прокси на Rust для сжатия запросов к LLM: обрабатывает промпты, историю, код, JSON и вывод инструментов, сохраняя качество ответов. Работает с Claude Code, Codex, Gemini CLI, Cursor и другими клиентами; также доступен как CLI, MCP-сервер и библиотека.
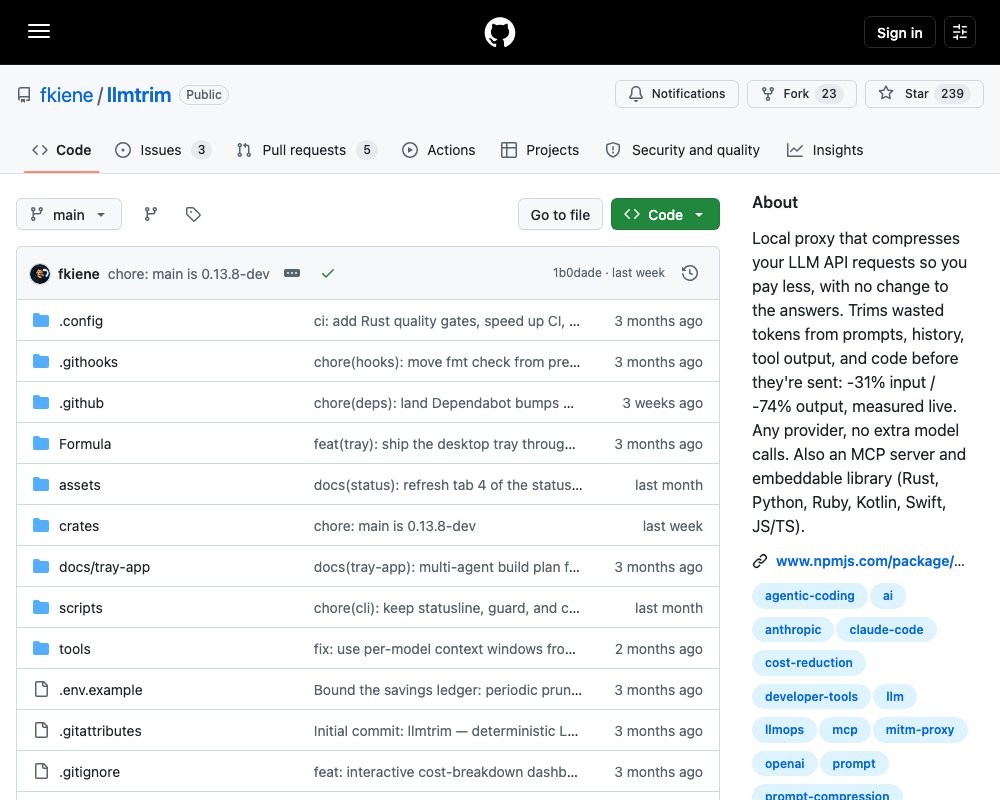
llmtrim — локальный прокси, который сжимает трафик между AI-кодинг-агентом и API LLM. Он уменьшает промпты, историю диалога, схемы инструментов, код и результаты команд до отправки провайдеру, сохраняя полезную информацию и качество ответа. Инструмент не вызывает дополнительную модель: обработка выполняется локально, типичное время обработки запроса — около 5 мс.
Как работает llmtrim
Без прокси агент отправляет провайдеру полный запрос:
agent -> full request -> LLM provider
agent <- full response <- LLM provider
llmtrim размещается между ними:
agent -> llmtrim -> smaller request -> LLM provider
agent <- llmtrim <- response         <- LLM provider
Прокси анализирует форму запроса и выбирает подходящие преобразования. Длинные логи сжимаются с сохранением ошибок, diff — с сохранением изменений, результаты grep — с сохранением совпадений, а большие массивы JSON могут быть преобразованы в компактное представление или частично сэмплированы.
Каждый этап повторно измеряется токенизатором конкретного провайдера. Если сжатие не уменьшает запрос или не проходит проверку качества, llmtrim откатывает его. Если провайдер отклоняет сжатое тело запроса, прокси отправляет исходный вариант. В худшем случае запрос проходит без экономии, но не становится дороже.
Быстрый старт
Основной способ установки — глобальный npm-пакет:
npm install -g @llmtrim/cli@latest && llmtrim setupПосле завершения откройте новый терминал и проверьте состояние:
llmtrim statusКоманда setup запускает локальный прокси, настраивает переменные HTTPS_PROXY и доверенный сертификат, а также регистрирует демон для запуска при входе в систему. Для Claude Code она дополнительно подключает команду /sub.
llmtrim также доступен через Homebrew, Cargo, Scoop и Docker:
brew install fkiene/tap/llmtrim
cargo binstall llmtrim
scoop install llmtrim
docker run -d -p 43117:43117 -v llmtrim-state:/data ghcr.io/fkiene/llmtrim
Подробности установки и запуска находятся в документации INSTALL.md.
Какие данные сжимаются
llmtrim объединяет десять обработчиков. Они включаются автоматически только тогда, когда форма запроса и проверка качества позволяют это сделать.
| Этап | Что он делает |
|---|---|
tool-output |
Сворачивает повторяющиеся строки и оставляет ошибки, изменения и совпадения в логах, diff и grep |
cache discipline |
Стабилизирует неизменяемую часть запроса, чтобы сохранить prompt cache |
lexical retrieval |
Выбирает релевантные части длинного контекста с помощью лексического поиска |
skeletonization |
Оставляет сигнатуры нерелевантных функций, сохраняя тела важных |
serialize + hygiene |
Минифицирует JSON, нормализует Unicode, преобразует массивы записей в TOON или CSV |
json sample |
Сокращает большие массивы, оставляя первые и последние элементы, выбросы и релевантную выборку |
dedup |
Удаляет повторяющиеся и почти повторяющиеся строки |
output control |
Добавляет инструкции для более краткого ответа и ограничивает лишние рассуждения |
tool layer |
Сокращает набор доступных инструментов и их описания |
multimodal |
Уменьшает изображения до максимального допустимого разрешения провайдера |
Ничего под маркером cache_control не переписывается. Для первого результата команды можно включить восстановление через llmtrim recall, но эта возможность выключена по умолчанию. Если вывод конкретной команды нужно передать без изменений, используйте LLMTRIM_TOOL_OUTPUT=passthrough или шаблон команды в toolout_passthrough. Строки, начинающиеся с LLMTRIM_KEEP:, сохраняются всегда.
Режимы сжатия
Пресет выбирается через LLMTRIM_PRESET или файл config.toml в $XDG_CONFIG_HOME/llmtrim/:
auto— режим по умолчанию, который анализирует тип запроса и выбирает обработчики;safe— только преобразования без потери информации;aggressive— максимальное сжатие с проверкой качества;agent— приоритет циклам с вызовом инструментов;code— сжатие кода, логов и diff;rag— извлечение релевантного контекста для длинных вопросов;cache— запросы с многократно используемым фиксированным префиксом;reasoning— задачи с математикой и пошаговыми рассуждениями;frugal— отдельный режим для измерения бережливости цикла агента.
Отдельные обработчики можно включать и отключать в конфигурации, но общий пресет имеет приоритет. Переменные окружения LLMTRIM_PRESET и LLMTRIM_CONFIG позволяют менять настройки без редактирования файла.
Работа с агентами и приложениями
Через HTTPS-прокси llmtrim работает с Claude Code, Codex CLI, Gemini CLI, Cursor, Cline, Roo, Kilo Code, OpenCode, Goose, Crush, Aider и другими инструментами, которые учитывают HTTPS_PROXY и переменные окружения с CA. Запросы к не-LLM хостам проходят без изменений.
Прокси не подходит GitHub Copilot из-за certificate pinning. Warp и Devin используют серверные вызовы провайдера, поэтому локальный прокси их не видит. Cursor Agent и Kiro работают через отдельные шлюзы, а не напрямую со стандартными провайдерами.
Если прокси не нужен, тот же движок можно вызвать как CLI:
echo '{"model":"gpt-4o","messages":[...]}' | llmtrim compress --provider openai > out.json
echo '{"model":"gpt-4o","messages":[...]}' | llmtrim send --provider openai
Есть библиотеки для Rust, Python, Ruby, Kotlin, Swift и JavaScript/TypeScript. В JavaScript используется WASM-пакет @llmtrim/js; в Python — пакет llmtrim.
MCP-сервер
llmtrim можно подключить как MCP-сервер к Claude Code или другому MCP-клиенту:
llmtrim mcp install
llmtrim mcp install --print
Конфигурация сервера:
{
  "mcpServers": {
    "llmtrim": {
      "command": "llmtrim",
      "args": ["mcp"]
    }
  }
}
Сервер предоставляет инструменты llmtrim_compress, llmtrim_compress_text и llmtrim_stats.
Дополнительная маршрутизация в Claude Code
Команда /sub может направлять Claude Code через другую подписку. Для этого llmtrim управляет CLIProxyAPI, который используется как основной маршрут или как резервный переход:
llmtrim sub on
llmtrim sub on grok
llmtrim sub auth
llmtrim sub models
llmtrim sub mode fallback
llmtrim sub status
llmtrim sub off
Сопоставление моделей Claude с моделями CLIProxyAPI можно менять в интерфейсе llmtrim status. Эта возможность opt-in и может конфликтовать с условиями использования провайдера, поэтому её нужно включать осознанно.
llmtrim также создаёт локальных агентов для делегирования задач отдельным моделям. Такой подход использует Anthropic-совместимый прокси и описан в проекте claude-code-proxy.
Безопасность и локальность
Для перехвата HTTPS llmtrim создаёт локальный name-constrained CA в ~/.llmtrim/, настраивает HTTPS_PROXY и запускает демон при входе в систему. llmtrim uninstall отменяет эти изменения. Проверить ограничения сертификата можно командой:
llmtrim ca
openssl x509 -in ~/.llmtrim/ca.pem -noout -text
Прокси не сохраняет API-ключи и не записывает промпты на диск. В журнале остаются обезличенные счётчики токенов. Восстанавливаемые результаты инструментов могут временно находиться в ограниченной по объёму памяти демона и исчезают при перезапуске; стандартное время хранения — пять часов. Полная модель угроз опубликована в SECURITY.md.
Что показывают измерения
В 112 live A/B-тестах авторы проекта получили следующие агрегированные результаты:
| Метрика | Исходный запрос | После сжатия | Изменение |
|---|---|---|---|
| Входные токены | 71 031 | 49 062 | −31% |
| Выходные токены | 25 843 | 6 628 | −74% |
| Стоимость round-trip | $0,0365 | $0,0126 | −66% |
| Оценка качества | 78,9% | 82,2% | без измеренной деградации |
В отдельных тестах TruthfulQA, SQuAD v2 и BFCL не показали снижения качества. На GSM8K качество снизилось с 100% до 92% при агрессивном режиме, поэтому для математических задач стоит отдельно измерять соотношение экономии и качества. Важно, что сокращение выходных токенов в основном тесте получено через сравнение ответов, а не напрямую локальным сжатием ответа провайдера.
Anthropic и Gemini не публикуют точный токенизатор, поэтому для них используется приближённый BPE-подсчёт; для OpenAI подсчёт точный. Методика и результаты бенчмарков доступны в документации проекта.
llmtrim также можно сравнивать с локальными системами сжатия вроде Headroom, но важно различать их сценарии: Headroom ориентирован на слой контекста и память агентов, а llmtrim в первую очередь перехватывает API-трафик и сжимает конкретные запросы.
Источник: https://github.com/fkiene/llmtrim