

RAGFlow — RAG-движок с DeepDoc и агентами
📂 Исходный код на GitHubОткрытый RAG-движок, объединяющий RAG с агентными возможностями: глубокое понимание документов, шаблонная нарезка на чанки, проверяемые цитаты и агентные workflow поверх контекстного слоя для LLM.
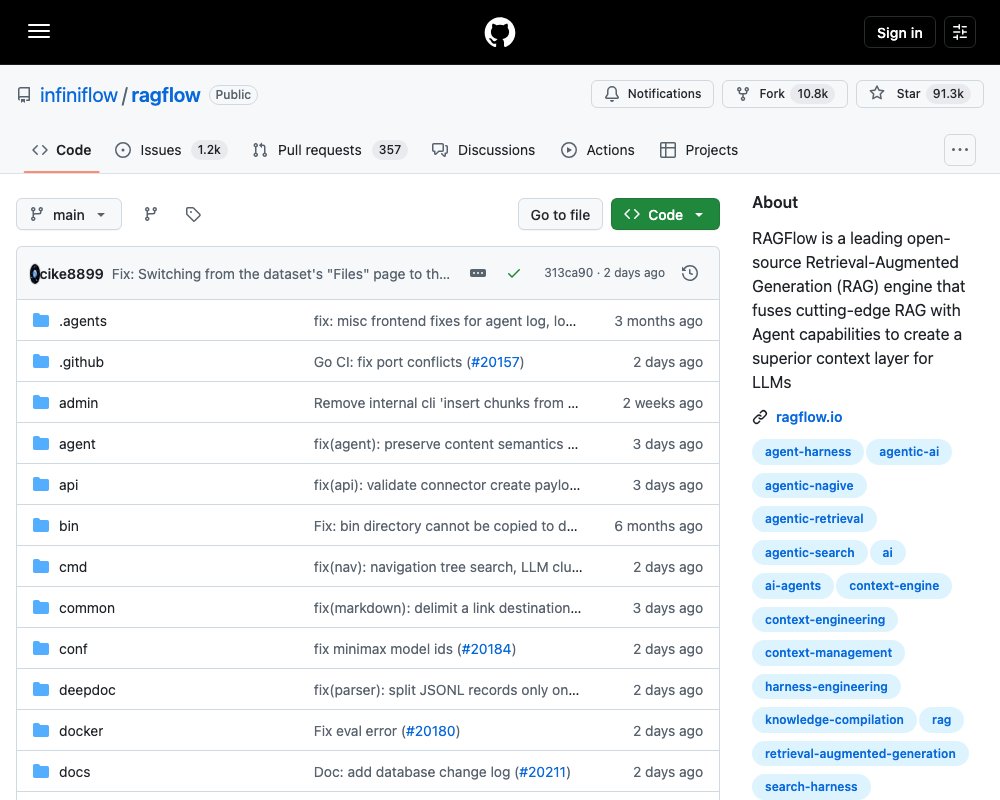
RAGFlow — открытый движок для Retrieval-Augmented Generation от компании infiniflow. Он берёт на себя ровно ту часть работы, которая обычно и ломает обычный RAG: превращение сложных документов в структурированные фрагменты, которые действительно можно процитировать. Поверх этого добавлен агентный слой: готовые шаблоны агентов, исполнение кода на Python и JavaScript, поддержка MCP и памяти агента. Лицензия Apache-2.0, проект живой — репозиторий обновляется постоянно, а свежие релизы собраны на странице релизов.
Если хочется посмотреть на систему без установки, есть облачный сервис: https://cloud.ragflow.io/
Что внутри
Ключевая идея проекта — «качество на входе даёт качество на выходе». Обычный RAG-пайплайн режет документ на куски и надеется, что нужный фрагмент попал в выдачу. В RAGFlow над этим работает отдельный слой понимания документов — DeepDoc, который разбирает неструктурированные данные сложных форматов и умеет находить «иголку в стоге» буквально неограниченного объёма токенов.
Дальше конвейер выглядит так:
- Парсинг — DeepDoc разбирает документ и восстанавливает его структуру.
- Нарезка на чанки по шаблонам — алгоритм объяснимый, шаблонов много, есть визуализация результата, чтобы человек мог вмешаться и поправить разбиение вручную.
- Извлечение и recall — несколько стратегий отбора кандидатов плюс повторное ранжирование (re-ranking) с их слиянием.
- Ответ со ссылками — ключевые источники видны сразу, на каждый утверждённый факт есть трассируемая ссылка на конкретный фрагмент.
Последний пункт — самый недооценённый. Когда модель отвечает и показывает, из какого куска документа взят каждый тезис, галлюцинации становятся заметны, а не просто подозрительны. В RAGFlow это встроено в интерфейс, а не оставлено на промпт.
Поддерживаются Word, Slides, Excel, TXT, изображения, сканы, структурированные данные и веб-страницы. С недавних релизов добавлены синхронизация данных из Confluence, S3, Notion, Discord и Google Drive, а также альтернативные движки парсинга — MinerU и Docling. Есть оркестрируемая ingestion-пайплайн: загрузка, очистка, разбиение и индексация выстраиваются в явную цепочку, а не в один неразборчивый шаг.
Агентные возможности
Агентный слой вырос из понимания, что одного RAG мало: нужен не только поиск, но и выполнение действий над найденным.
- Шаблоны агентов и готовый контекстный слой — context engine, на котором строятся рабочие сценарии.
- Кодовый исполнитель — компонент для запуска Python и JavaScript прямо в агенте. Требует gVisor: инструкция по установке.
- MCP — поддержка Model Context Protocol, так что агент умеет ходить во внешние инструменты.
- Память агента — механизм Memory, добавленный в декабре 2025 года.
- Мультимодальность — мультимодальная модель может разбирать изображения внутри PDF и DOCX.
- Оркестрация ingest — загрузка и обработка данных как управляемый процесс.
- Каналы чата — Feishu, Discord, Telegram, Line и другие мессенджеры как интерфейс к системе.
- Модели — поддерживаются DeepSeek, серия GPT-5, Gemini 3 Pro и другие; конкретный список провайдеров и ключи настраиваются в конфиге. Сами LLM и embedding-модели конфигурируются, внешние сервисы не вендорятся.
Отдельная деталь: для OpenClaw существует официальный скилл RAGFlow для доступа к датасетам RAGFlow.
Требования
Самый честный момент — RAGFlow нельзя поставить на ноутбук «на пробу». Минимальные требования:
| Ресурс | Значение |
|---|---|
| CPU | 4 ядра и больше |
| RAM | 16 ГБ и больше |
| Диск | 50 ГБ и больше |
| Docker | >= 24.0.0 |
| Docker Compose | >= v2.26.1 |
| Python | >= 3.13 |
Docker-образы собраны только под x86. На ARM64 придётся собирать образ самостоятельно по этой инструкции. Образ slim — около 2 ГБ. До версии v0.22.0 существовали два варианта образа: полный с моделями эмбеддингов (~9 ГБ) и slim без них (~2 ГБ). Начиная с v0.22.0 поставляется только slim, а суффикс -slim в теге больше не добавляется.
Запуск через Docker
Порядок такой. Сначала поднимаем лимит отображений памяти — Elasticsearch к нему чувствителен:
# Check current value
sysctl vm.max_map_count

# Set it if it is lower than 262144
sudo sysctl -w vm.max_map_count=262144
Чтобы изменение пережило перезагрузку, добавляем строку в /etc/sysctl.conf:
vm.max_map_count=262144Дальше клонируем репозиторий и фиксируем версию:
git clone https://github.com/infiniflow/ragflow.git
cd ragflow/docker

# Use a version tag so entrypoint.sh matches the image
git checkout v0.27.2
Запуск на CPU и вариант с GPU для ускорения задач DeepDoc:
# CPU mode
docker compose -f docker-compose.yml up -d

# GPU mode for DeepDoc acceleration
# sed -i S0 .env
# docker compose -f docker-compose.yml up -d
Проверяем, что контейнер поднялся:
docker logs -f docker-ragflow-cpu-1В логах должна появиться ASCII-логотип RAGFlow и строка * Running on all addresses (0.0.0.0). Пока этого нет, лучше не открывать интерфейс — браузер покажет ошибку сети, потому что система ещё инициализируется.
Дальше заходим в браузер по адресу машины. Порт 80 можно опускать, если не меняли конфигурацию. В файле docker/service_conf.yaml.template выбираем нужную фабрику LLM в user_default_llm и прописываем API_KEY — подробности в документации по ключам.
Файлы конфигурации
| Файл | Зачем |
|---|---|
| docker/.env | Базовые настройки: SVR_HTTP_PORT, MYSQL_PASSWORD, MINIO_PASSWORD |
| service_conf.yaml.template | Конфигурация бэкенд-сервисов, подставляется из переменных окружения при старте контейнера |
| docker-compose.yml | Собственно оркестрация запуска |
Чтобы сменить порт публикации, в docker-compose.yml заменяем 80:80 на <ВАШ_ПОРТ>:80. Переменные окружения из .env доступны как ${ENV_VARS} в шаблоне конфигурации — подробное описание в docker/README. Любые изменения конфигурации требуют перезапуска всех контейнеров:
docker compose -f docker-compose.yml up -dElasticsearch или Infinity
По умолчанию RAGFlow хранит полнотекстовые данные и векторы в Elasticsearch. Вместо него можно поставить Infinity от того же проекта:
# Stop containers and delete volumes — data will be lost
docker compose -f docker/docker-compose.yml down -v
Дальше в docker/.env ставим DOC_ENGINE=infinity и поднимаем контейнеры заново:
docker compose -f docker/docker-compose.yml up -dКлюч -v в down удаляет тома контейнеров вместе с данными. Важно: переключение на Infinity на Linux/arm64 официально не поддерживается.
Сборка своего образа
Если нужно что-то поправить в зависимостях, образ собирается из репозитория:
git clone https://github.com/infiniflow/ragflow.git
cd ragflow/
docker build --platform linux/amd64 -f Dockerfile -t infiniflow/ragflow:nightly .
За сборкой из-под прокси прокидываются аргументы сборки:
docker build --platform linux/amd64 \
  --build-arg http_proxy=http://YOUR_PROXY:PORT \
  --build-arg https_proxy=http://YOUR_PROXY:PORT \
  -f Dockerfile -t infiniflow/ragflow:nightly .
Готовые образы лежат в Docker Hub.
Запуск из исходников
Вариант для разработки: поднять зависимости отдельно, бэкенд и фронтенд запустить локально. Хук-и настраиваются один раз:
pipx install uv
git clone https://github.com/infiniflow/ragflow.git
cd ragflow/
uv sync --python 3.13
uv run python3 ragflow_deps/download_deps.py
git config --local --unset core.hooksPath
uv tool install lefthook
lefthook install
Сервисы-зависимости (MinIO, Elasticsearch, Redis, MySQL) поднимаются из docker-compose-base.yml, а имена хостов из docker/.env прописываются в /etc/hosts на 127.0.0.1. Дальше — активация окружения и старт бэкенда:
docker compose -f docker/docker-compose-base.yml up -d

source .venv/bin/activate
export PYTHONPATH=$(pwd)
bash docker/launch_backend_service.sh
Фронтенд запускается отдельно:
cd web
npm install
npm run dev
Если нет доступа к HuggingFace, помогает зеркало:
export HF_ENDPOINT=https://hf-mirror.comОстановить всё после работы:
pkill -f "ragflow_server.py|task_executor.py"Кому это пригодится
RAGFlow стоит рассматривать, когда документы неудобные: многостраничные PDF с таблицами, сканы, DOCX со смешанной вёрсткой, выгрузки из Confluence и Notion. Слабое место здесь одно и очевидное — ресурсы. Поднимать стек с Elasticsearch, MinIO, Redis и MySQL ради эксперимента на 16 ГБ RAM не хочется, поэтому для первого знакомства есть облако, а для продакшена — готовая документация, гайдлайны для пользователей и план развития. Обсуждения и помощь — в Discord, GitHub Discussions и в гайде по контрибьюту.
Источник: https://github.com/infiniflow/ragflow