

LLM Verify — проверка, не подменяют ли вам дорогую модель дешёвой
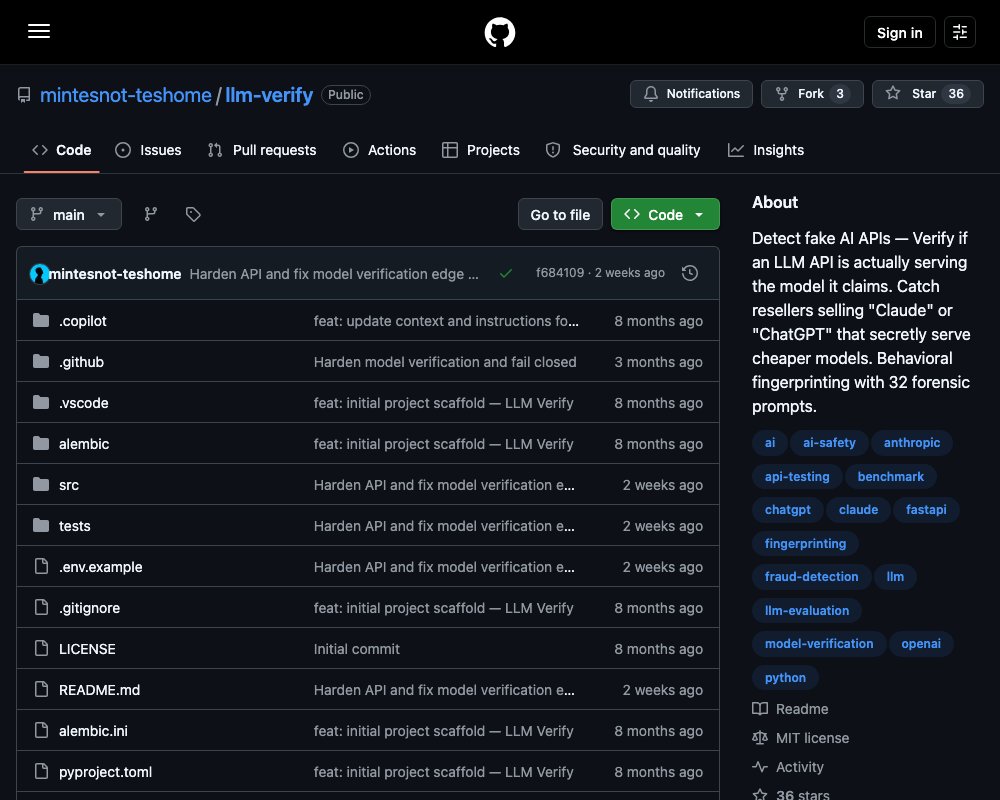
📂 Исходный код на GitHubИнструмент для поиска подмены моделей в LLM API: поведенческие отпечатки, 32 криминалистических промпта, сравнение подозрительного провайдера с доверенной базой и отчёт о признаках мошенничества. Python, FastAPI, MIT.
LLM Verify — проверка, не подменяют ли вам дорогую модель дешёвой
Продавцы доступа к LLM часто продают не то, что заявляют. Вместо настоящего Claude за ваши деньги стоит более дешёвая модель с системным промптом вида «Ты — Claude, созданный Anthropic». Отличить такую подмену по одному ответу нельзя, зато можно по поведению модели. Проект LLM Verify делает именно это: отправляет подозрительному API набор промптов, смотрит на отпечаток поведения и выносит вердикт. Это Python-сервис на FastAPI с открытой лицензией MIT.
Какую задачу решает
Подмена модели — это мошенничество. Клиент платит тариф премиум-класса, а ответы приходят от другой модели. Меняется не только цена. Меняется и то, что вы получаете: глубина рассуждений, объём контекста, стиль ответов.
LLM Verify проверяет, ведёт ли себя API так, как вёл бы себя настоящий Claude или настоящий GPT. Инструмент опирается на поведенческое снятие отпечатков. Он не спрашивает у модели «кто ты» в лоб и не верит ответу. Он сравнивает манеру отвечать: задержку, расход токенов, словарь, оформление, структуру.
Что внутри
- Поведенческие отпечатки. Модель опознаётся по тому, как она отвечает, а не по тому, что о себе заявляет.
- Сравнение бок о бок. Подозрительный API сравнивается с проверенной базовой моделью.
- 32 криминалистических промпта. Проверки личности, проверки возможностей, анализ стиля.
- Оценка по нескольким осям. Задержка ответов, расход токенов, словарь, шаблоны оформления.
- Асинхронность. Параллельные вызовы API с настраиваемым ограничением частоты.
- Любой совместимый API. Работает с любым адресом, который говорит по протоколу OpenAI.
Быстрый старт
# 1. Create virtual environment
python -m venv .venv
.venv\Scripts\activate   # Windows
# source .venv/bin/activate  # Linux/macOS

# 2. Install dependencies
pip install -e ".[dev]"

# 3. Copy environment config
cp .env.example .env
# Edit .env: set API_ACCESS_KEY and your provider keys

# 4. Run the API server
uvicorn src.main:app --reload
# or: benchmarker serve --reload

# 5. Run tests
pytest
Все маршруты /api/v1 по умолчанию требуют заголовок Authorization: Bearer <API_ACCESS_KEY>. Для локальной разработки его можно отключить переменной ALLOW_UNAUTHENTICATED=true. Имена хостов подозрительных адресов нужно перечислить точно в ALLOWED_API_HOSTS через запятую. Хост из SUSPECT_API_BASE_URL считается доверенным автоматически. Официальные адреса OpenAI и Anthropic встроены.
Когда вы сравниваете запуск с несколькими моделями или снимаете отпечаток, нужно указать селектор модели: baseline_model_name, suspect_model_name либо query-параметр model_name. Без него API отклоняет неоднозначный запрос.
Методы HTTP-сервиса
| Метод | Адрес | Назначение |
|---|---|---|
| GET | /health |
Проверка живости сервиса |
| POST | /api/v1/benchmarks/ |
Запуск нового набора тестов |
| GET | /api/v1/benchmarks/ |
Список всех запусков |
| GET | /api/v1/benchmarks/{id} |
Один конкретный запуск |
| GET | /api/v1/results/{run_id} |
Результаты запуска |
| POST | /api/v1/results/compare |
Сравнение двух запусков, поиск подмены |
| GET | /api/v1/results/{id}/fingerprint |
Снятие поведенческого отпечатка |
| POST | /api/v1/analysis/deep |
Полный отчёт о подмене модели |
Два сценария работы
Сценарий А: есть ключ от настоящего провайдера
Если у вас есть настоящий ключ от Anthropic или OpenAI, проверка идёт в четыре шага:
- Прогнать набор тестов по доверенной модели и получить базовую линию.
- Прогнать тот же набор по подозрительному API.
- Сравнить два запуска. Система смотрит на задержку, стиль, расход токенов, частоту ошибок, словарь и оформление.
- Получить вердикт:
MATCH,MISMATCHилиINCONCLUSIVE.
Сценарий Б: настоящего ключа нет
Официальный ключ не обязателен. Анализ только подозрительного API тоже находит тревожные признаки: противоречия, уходы от ответа, признаки работы через прокси и подозрительное сходство ответов. Доказать личность модели криптографически такой анализ не может.
В файле .env задаётся только подозрительный адрес:
SUSPECT_API_KEY=your-suspect-key
SUSPECT_API_BASE_URL=https://suspect-provider.example.com/api
Дальше идут проверки личности и снятие отпечатка:
curl -X POST http://localhost:8000/api/v1/benchmarks/ \
  -H "Authorization: Bearer $API_ACCESS_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "name": "Suspect Identity Test",
    "prompt_suite": "identity",
    "model_configs": [
      {"model_name": "claude-sonnet-4-20250514", "provider": "suspect"}
    ]
  }'
curl -H "Authorization: Bearer $API_ACCESS_KEY" \
"http://localhost:8000/api/v1/results/{run_id}/fingerprint?model_name=claude-sonnet-4-20250514"Проверки личности спрашивают у модели, кто она, десятью разными способами. Вопросы бывают прямые, косвенные, через подсказки на обход ограничений, через границу возможностей и через дату отсечения знаний. Настоящая модель отвечает на них одинаково. Поддельная противоречит сама себе.
На что смотреть без базовой линии
| Тревожный признак | Что это значит |
|---|---|
| Разные даты отсечения знаний | Модель называет разные даты в разных проверках, у настоящей дата одна |
| Называет себя другой моделью | Запрашивали Claude 4, а модель отвечает, что она Claude 3.5 Sonnet |
| Упоминает «прокси» или «управляемый сервер» | Модель сама знает, что стоит за ретранслятором |
| Очень высокая задержка, больше 10 секунд | Похоже на посредника, который добавляет лишний слой |
| Имя модели не совпадает | В ответе API написано model: X, а модель называет себя Y |
| Нестабильные возможности | Заявляет умения, которых у неё нет, или лишена тех, что есть у настоящей модели |
Поддерживаемые протоколы
У подозрительного API может быть любой из двух протоколов. Поле protocol в конфигурации модели выбирает нужный.
| Протокол | Когда использовать |
|---|---|
anthropic |
Подозрительный API говорит в формате Anthropic Messages API |
openai |
Подозрительный API говорит в формате OpenAI Chat Completions |
{
  "model_name": "claude-sonnet-4-20250514",
  "provider": "suspect",
  "protocol": "anthropic"
}
Глубокий анализ одной кнопкой
Вместо ручного прогона наборов и сравнения результатов можно сделать один вызов и получить готовый отчёт. Метод /api/v1/analysis/deep:
- Прогоняет все наборы промптов — проверки личности, проверки возможностей, снятие отпечатка — по каждой модели.
- Снимает поведенческий отпечаток каждой модели: стиль, словарь, структуру, задержку.
- Сравнивает модели между собой, чтобы заметить, что под разными именами стоит одна и та же модель.
- Ищет тревожные признаки и выстраивает находки по серьёзности.
- Возвращает отчёт с общим вердиктом.
curl -X POST http://localhost:8000/api/v1/analysis/deep \
  -H "Authorization: Bearer $API_ACCESS_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "name": "Investigate opuscode.pro",
    "model_configs": [
      {"model_name": "Opus 4.6", "provider": "suspect"},
      {"model_name": "Sonnet 4.5", "provider": "suspect"},
      {"model_name": "Haiku 4.5", "provider": "suspect"}
    ],
    "suites": ["identity", "capability", "fingerprint"]
  }'
Значения вердикта
| Вердикт | Значение |
|---|---|
FRAUD_DETECTED |
Несколько сильных независимых признаков подмены |
SUSPICIOUS |
Есть хотя бы одно заметное отклонение, которое стоит проверить |
INCONCLUSIVE |
Слишком мало успешных проверок или нет сопоставимых данных |
NO_FRAUD_SIGNALS |
Обязательные проверки прошли, ни один настроенный детектор не сработал |
Здесь важная оговорка. Значение NO_FRAUD_SIGNALS не означает «модель точно настоящая». Снятие отпечатка по поведению — это вероятностная процедура. Умелый посредник может повторять заявленную личность и стиль. Для самого надёжного результата нужно собрать доверенную базовую линию по тому же набору промптов и сравнить её с подозрительным запуском.
Правила сбора доказательств устроены так, чтобы система не спешила с выводами. Для достаточной базы нужно минимум 8 успешных проверок и 80 процентов успеха. Подозрительный адрес не может получить MATCH, просто отказываясь отвечать на сложные вопросы или уходя в таймаут. Сравнение запусков требует одинаковых наборов промптов. Противоречия в семействе и в версии модели считаются отдельно. Признаки работы через прокси и ретранслятор попадают в отчёт.
Где взять базовую линию бесплатно
Премиум-ключи есть не у всех. Для базовой линии подойдут провайдеры с бесплатными тарифами:
| Провайдер | Что даёт бесплатно | Где зарегистрироваться |
|---|---|---|
| Google Gemini | 15 запросов в минуту | https://aistudio.google.com |
| Mistral | Проблатный запас кредитов | https://console.mistral.ai |
| Groq | Бесплатный доступ с ограничением частоты | https://console.groq.com |
| OpenRouter | Часть моделей бесплатно | https://openrouter.ai |
Их подключают как провайдеров типа generic по протоколу, совместимому с OpenAI.
Как устроен проект
src/
├── adapters/      # AI provider API clients (OpenAI, Anthropic, generic)
├── handlers/      # FastAPI route handlers
├── models/        # SQLAlchemy ORM models
├── prompts/       # Benchmark prompt suites (identity, capability, fingerprint)
├── repositories/  # Database access layer
├── schemas/       # Pydantic request/response models
├── services/      # Business logic (runner, comparator, fingerprinting)
├── config.py      # Centralized settings
├── database.py    # Async SQLAlchemy setup
└── main.py        # FastAPI app entry point
Вывод
Если вы платите за доступ к дорогой модели через посредника, инструмент даёт способ проверить, что приходит в ответ. Он не доказывает подмену и не заменяет договор с провайдером. Но он заметно дешевле, чем полагаться на заверения продавца, и умеет не заявлять лишнего там, где доказательств мало. Лицензия — MIT.