

LocalAI — self-hosted движок для запуска LLM и мультимодальных моделей
📂 Исходный код на GitHubOpen-source AI-движок: запускает LLM, vision, голосовые, графические и видео-модели на любом железе, включая CPU. Совместим с OpenAI API.
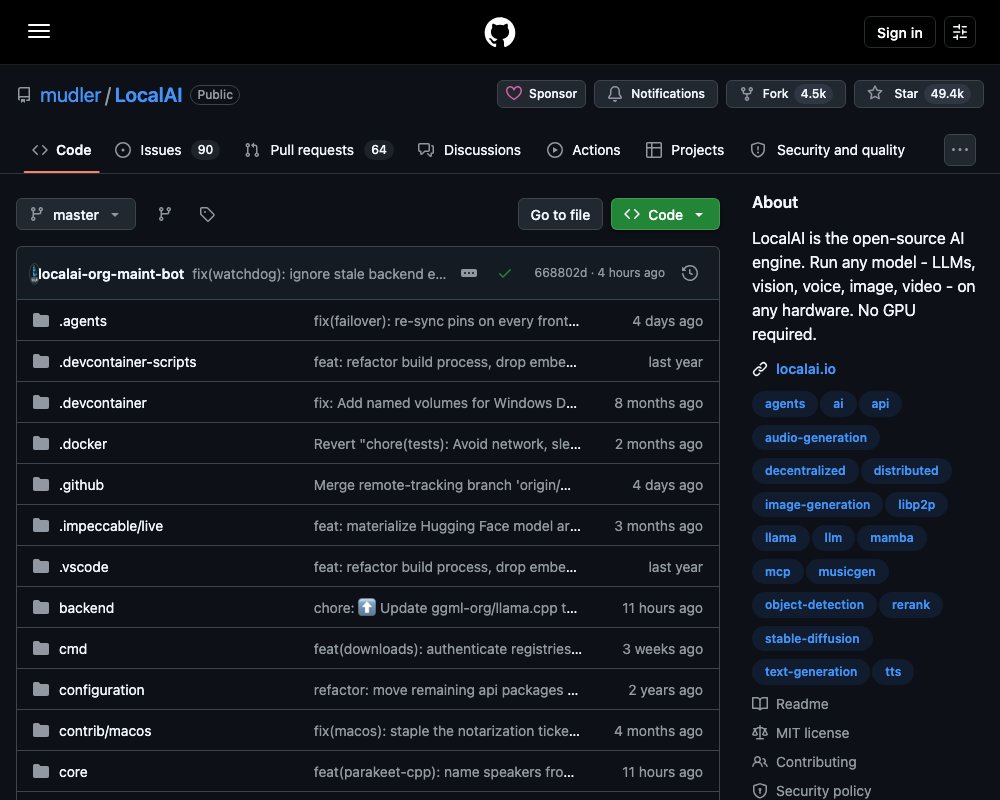
LocalAI — это open-source AI-движок, который запускает любые модели на любом железе: LLM, vision, голос, изображения и видео. GPU не обязателен. Проект создал Ettore Di Giacinto, код распространяется по лицензии MIT. Главная идея проста: вы поднимаете свой сервер инференса, который ведёт себя как OpenAI API, но все данные остаются на вашей инфраструктуре. Ни один запрос не уходит во внешнее облако.
Небольшое ядро вместо монолита
LocalAI построен как компактное ядро плюс подключаемые бэкенды. Каждый бэкенд оборачивает проверенный движок — llama.cpp, vLLM, whisper.cpp, stable-diffusion, MLX — в отдельный OCI-образ. Образ скачивается только тогда, когда вам нужна конкретная модель. Ставите то, что используете, и ничего лишнего.
Всего поддерживается больше 60 бэкендов. Их можно устанавливать и удалять на лету через Backend Gallery. Интерфейс открытый, поэтому свой бэкенд можно написать на любом языке.
Drop-in замена популярных API
Самое ценное в LocalAI — совместимость API. Сервер понимает API OpenAI, Anthropic и ElevenLabs на каждом бэкенде. Это значит, что существующее приложение можно переключить на локальные модели одной переменной окружения — заменой базового URL и ключа.
Внутри одного сервера доступны:
- генерация текста (llama.cpp, transformers, vLLM и другие, полная таблица — в матрице совместимости);
- синтез речи и распознавание аудио;
- генерация изображений и видео;
- Realtime API — разговор голосом в реальном времени;
- эмбеддинги и Reranker API для поиска;
- Vision API и детекция объектов;
- ограниченные грамматики — модель отвечает строго в заданном формате.
Быстрый старт
Самый простой способ — Docker. На чистом CPU:
docker run -ti --name local-ai -p 8080:8080 localai/localai:latestДля GPU достаточно выбрать нужный образ. LocalAI сам определяет возможности вашей видеокарты и скачивает подходящий бэкенд.
# NVIDIA GPU (CUDA 13)
docker run -ti --name local-ai -p 8080:8080 --gpus all localai/localai:latest-gpu-nvidia-cuda-13

# AMD GPU (ROCm)
docker run -ti --name local-ai -p 8080:8080 --device=/dev/kfd --device=/dev/dri --group-add=video localai/localai:latest-gpu-hipblas

# Intel GPU (oneAPI)
docker run -ti --name local-ai -p 8080:8080 --device=/dev/dri/card1 --device=/dev/dri/renderD128 localai/localai:latest-gpu-intel

# Vulkan
docker run -ti --name local-ai -p 8080:8080 localai/localai:latest-gpu-vulkan
Есть и десктопная сборка для macOS в виде DMG. Полные инструкции — в руководстве по началу работы, детали по ускорению — в гайде про GPU.
Загрузка моделей
Модели запускаются одной командой local-ai run. Источники разные:
# Из галереи моделей
local-ai run llama-3.2-1b-instruct:q4_k_m

# С Hugging Face
local-ai run huggingface://TheBloke/phi-2-GGUF/phi-2.Q8_0.gguf

# Из OCI-реестра Ollama
local-ai run ollama://gemma:2b

# Из YAML-конфига
local-ai run https://gist.githubusercontent.com/.../phi-2.yaml

# Из обычного OCI-реестра, например Docker Hub
local-ai run oci://localai/phi-2:latest
Каталог доступных моделей — на models.localai.io. Когда сервер запущен, с ним можно работать из терминала через встроенного агента: во второй сессии выполняете local-ai chat --model <имя>, и агент отвечает на вопросы, читает файлы и запускает команды, спрашивая подтверждение на каждое изменение. Команда /models показывает установленные модели, /model <name> переключает между ними. Подробности — в документации терминального агента.
Железо
LocalAI работает на NVIDIA (CUDA 12 и 13), AMD (ROCm), Intel (oneAPI и SYCL), Apple Silicon (Metal), а также через Vulkan и на NVIDIA Jetson. Поддерживается и обычный CPU — медленнее, но работает. Один и тот же сервер можно разворачивать и на ноутбуке разработчика, и на серверном кластере.
Мультимодальность и собственные движки
Большинство бэкендов оборачивают сторонние движки. Но у проекта есть и собственные движки на чистом C++ и GGML — без Python на этапе инференса. Вот несколько заметных:
| Движок | Что делает |
|---|---|
| vllm.cpp | Порт vLLM на C++20: paged KV cache, непрерывный батчинг, кэш префиксов |
| parakeet.cpp | Порт NVIDIA NeMo Parakeet для распознавания речи со стримингом |
| vibevoice.cpp | Порт Microsoft VibeVoice: синтез речи с клонированием голоса |
| face-detect.cpp | Детекция и распознавание лиц, защита от подделки |
| locate-anything.cpp | Детекция объектов с открытым словарём |
| depth-anything.cpp | Оценка глубины сцены по одному кадру |
Команда также развивает apex-quant — рецепты квантизации для MoE-моделей, которые дают качество не ниже Q8_0 и работают в обычном llama.cpp без доработок.
Агенты, MCP и многопользовательский режим
В LocalAI встроены автономные агенты: они используют инструменты, работают с RAG и навыками, поддерживают MCP и стриминг через SSE. Для готовых агентов есть каталог Agent Hub.
Сервер сразу готов к командной работе:
- авторизация по API-ключам и через OIDC;
- квоты и лимиты на пользователя с предиктивной аналитикой;
- учёт расхода токенов по каждому ключу;
- разграничение доступа по ролям;
- встроенный веб-интерфейс с историей чатов.
Распределённый режим
Для больших нагрузок есть распределённый режим: несколько нод LocalAI объединяются в кластер через PostgreSQL и NATS. Роутер учитывает, какая модель и где уже загружена в VRAM, и направляет запросы на нужную ноду. Поддерживаются автомасштабирование, распределённый инференс с разбиением модели по слоям и P2P-режим.
Куда смотреть дальше
- Документация и FAQ — основной источник знаний.
- LocalAI-examples — рабочие примеры, включая демо голосового ассистента в реальном времени.
- Релизы — проект развивается быстро: весной 2026 года вышли версии 4.1–4.3 с распределённым кластером, дообучением в интерфейсе и подписью OCI-образов бэкендов.
Если вам нужен локальный «OpenAI без облака» — под данные, под приватность или просто без ежемесячных счетов, — LocalAI сейчас один из самых зрелых вариантов: одна точка входа, десятки движков, любое железо.
Источник: https://github.com/mudler/LocalAI