SmarterRouter — умный роутер, который сам выбирает локальную модель под каждый запрос
📂 Исходный код на GitHubОткрытый локальный шлюз (Python, MIT), который профилирует ваши модели, собирает данные бенчмарков и направляет каждый запрос лучшей доступной модели — Ollama, llama.cpp или внешнему провайдеру. Следит за видеопамятью, кэширует ответы, при сбое автоматически переключается на запасную модель.
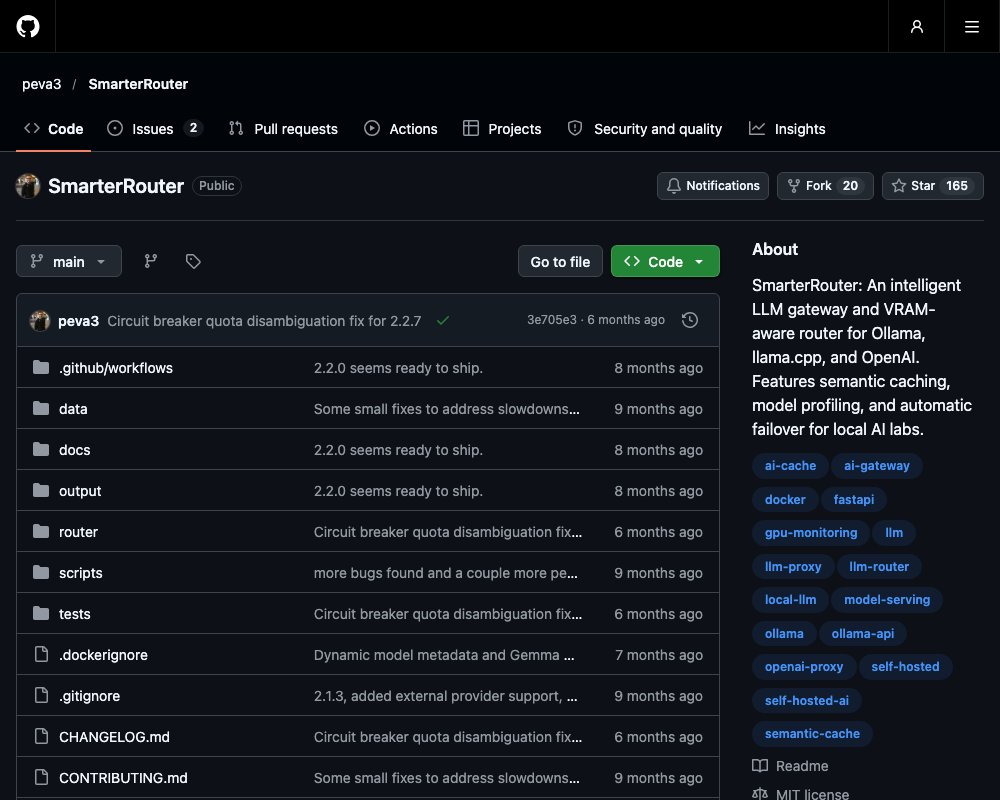
У локальных LLM есть известная проблема: моделей ставится всё больше, а выбирать вручную надоедает. Обычно человек в итоге держит самую большую модель — и страдает от медленных ответов на простых задачах, или самую быструю — и получает слабые ответы на сложных. SmarterRouter убирает этот выбор из ваших рук: это локальный роутер, который встраивается между приложением и моделями Ollama, llama.cpp или внешними API и отправляет каждый запрос самой подходящей модели. Профилирование, бенчмарки и сам выбор работают полностью на вашей машине — без облаков и без оплаты за API.
Зачем он нужен, если есть прокси
Большинство LLM-прокси пересылают запросы туда, куда вы настроили: конфиг пишется руками, и роутинга как такового нет. Авторы SmarterRouter сравнили свой проект с OptiLLM, ClewdR, LLM-API-Proxy и Reader — у всех конкурентов либо ручная настройка, либо поддержка только одного провайдера. Что делает SmarterRouter:
- Сам находит модели. Всё, что есть в вашем бэкенде, подхватывается автоматически.
- Сам тестирует модели. Каждая модель прогоняется через стандартный набор задач именно на вашем железе.
- Сам выбирает модель под каждый запрос — по сложности запроса и данным о моделях.
- Подключается без правок кода. Роутер говорит на OpenAI-совместимом API, поэтому с ним работает любой готовый клиент.
- Учится со временем. Оценки пользователей собираются и влияют на будущие решения роутера.
Как роутер выбирает модель
Перед отправкой запроса роутер оценивает его сложность: смотрит, есть ли в тексте логические задачи, код и много ли в нём инструкций. Дальше работает алгоритм с несколькими весами, который складывает три источника данных:
- Статические бенчмарки — общие данные о модели с HuggingFace и LMSYS.
- Локальные профили — измеренные показатели именно вашей машины. Бенчмарк с сайта ничего не знает о вашем железе, а локальный замер — знает.
- Созвучие задачи и модели — запросы с кодом Python уходят к моделям с «coder» в названии.
Баланс между скоростью и качеством задаётся одной переменной ROUTER_QUALITY_PREFERENCE от 0.0 (максимальная скорость) до 1.0 (максимальное качество), по умолчанию 0.5. Отдельная защита не даст маленькой модели взяться за сложную задачу: у каждой категории задач есть минимальный размер модели — для сложных задач по коду и рассуждениям это 8B, для творческих 4B. Модели меньше минимума получают жёсткий штраф в подсчёте очков.
Профилирование моделей
При первом запуске роутер тестирует каждую вашу модель стандартизированным набором промптов по образцу MT-Bench: рассуждения, код, творчество. Первый прогон занимает 30–60 минут, дальше данные уже готовы. В этот процесс встроены две важные детали:
- LLM-судья. Если включить эту опцию, сильная модель оценивает ответы слабых. Профили получаются заметно точнее, чем при примитивной проверке «ответил или нет».
- Проверка способностей. Модуль профилирования выясняет, умеет ли модель работать с изображениями и вызывать инструменты. Запросы, которым нужны эти умения, просто не уходят в модели, которые их не потянут.
Управление видеопамятью
Локальный запуск нескольких моделей упирается в видеопамять (VRAM), и здесь у роутера есть целый менеджер:
- Фоновый мониторинг. Роутер автоматически определяет видеокарты NVIDIA, AMD, Intel и Apple Silicon; системы с несколькими GPU поддерживаются.
- Точные замеры. При профилировании измеряется фактическое потребление памяти каждой модели, а не берётся оценка «с потолка».
- Бюджет памяти. Если не задать лимит вручную, роутер берёт 90% всей видеопамяти и оставляет 10% системе и драйверам.
- Вытеснение. Когда новая модель не помещается, роутер выгружает старые — по стратегии LRU (дольше всех не использовавшиеся) или «сначала самые большие». Закреплённые модели (
ROUTER_PINNED_MODEL) не выгружаются никогда.
Отдельно поддержаны AMD APU с единой памятью: там под задачи GPU используется почти вся системная память, и роутер это учитывает при планировании.
Установка и запуск
Быстрый старт через Docker — три команды:
git clone https://github.com/peva3/SmarterRouter.git
cd SmarterRouter
docker-compose up -d
Роутер поднимется на порту 11436. Проверить его здоровье можно командой curl http://localhost:11436/health, после чего он сам найдёт ваши модели Ollama и начнёт профилирование.
Есть и интерактивный мастер настройки: команда python -m smarterrouter setup находит вашу установку Ollama (локальную, в Docker или удалённую), определяет видеокарту, анализирует модели и генерирует готовый файл .env. Ещё есть скрипт ./docker-run.sh, который разворачивает контейнер одной командой с автоматической конфигурацией GPU.
Подключение к OpenWebUI: в настройках соединений укажите base URL http://localhost:11436/v1, имя модели — smarterrouter/main, ключ API не нужен. Дальше роутер сам решает, какую модель запускать.
Основные настройки живут в файле .env (шаблон — ENV_DEFAULT в репозитории):
| Переменная | Зачем | По умолчанию |
|---|---|---|
ROUTER_OLLAMA_URL |
адрес вашего бэкенда | http://localhost:11434 |
ROUTER_PROVIDER |
тип бэкенда: ollama, llama.cpp, openai | ollama |
ROUTER_QUALITY_PREFERENCE |
баланс скорости и качества | 0.5 |
ROUTER_PINNED_MODEL |
модель, которая всегда остаётся в памяти | нет |
ROUTER_ADMIN_API_KEY |
ключ защиты админ-эндпоинтов | нет |
Безопасность: в продакшене обязательно задайте ROUTER_ADMIN_API_KEY, иначе админ-эндпоинты (профили моделей, данные о видеопамяти, управление кэшем) останутся открытыми. Опционально включается ограничение частоты запросов: по умолчанию 60 запросов в минуту с одного IP на общих эндпоинтах и 10 на админских.
Внешние провайдеры
Роутер не заперт на одной машине. Включив внешних провайдеров (openai, anthropic, google, cohere, mistral), вы получаете тот же умный выбор и для облачных моделей — с префиксом в имени модели вроде openai/gpt-4o. Локальные и облачные модели можно смешивать в одном роутере.
Бенчмарки для облачных моделей приходят из базы provider.db — SQLite-файл на 400+ моделей, который собирает отдельный проект smarterrouter-provider из 28+ источников: LMSYS Chatbot Arena, LiveBench, BigCodeBench, MMLU, SWE-bench, HumanEval и других. База скачивается автоматически каждые 4 часа и весит около 200 КБ.
Прочее из коробки
- Горячая замена моделей — добавляйте и удаляйте модели без перезапуска роутера (с версии 2.1.6), вместе с расширенной статистикой кэша.
- Эмбеддинги — тот же API отдаёт и векторные представления текста, так что роутер закрывает и задачи поиска.
- Кэш ответов — одинаковые запросы не считаются заново, ответ приходит мгновенно.
- Запасная модель — если основная модель не ответила, роутер сам повторяет запрос на другой.
- Оптимизации версии 2.1.9 — асинхронный ввод-вывод с GPU, пакетная обработка запросов, кэширование промптов.
Проект написан на Python и распространяется по лицензии MIT. Подробная документация — руководство по установке, справочник конфигурации, описание API и технический разбор архитектуры. Баги и пожелания — через GitHub Issues.
Источник: https://github.com/peva3/SmarterRouter