Строим рассуждающую LLM с нуля: код книги Build a Reasoning Model
📂 Исходный код на GitHubКод книги Build a Reasoning Model (From Scratch): собираем рассуждающую LLM на PyTorch шаг за шагом.
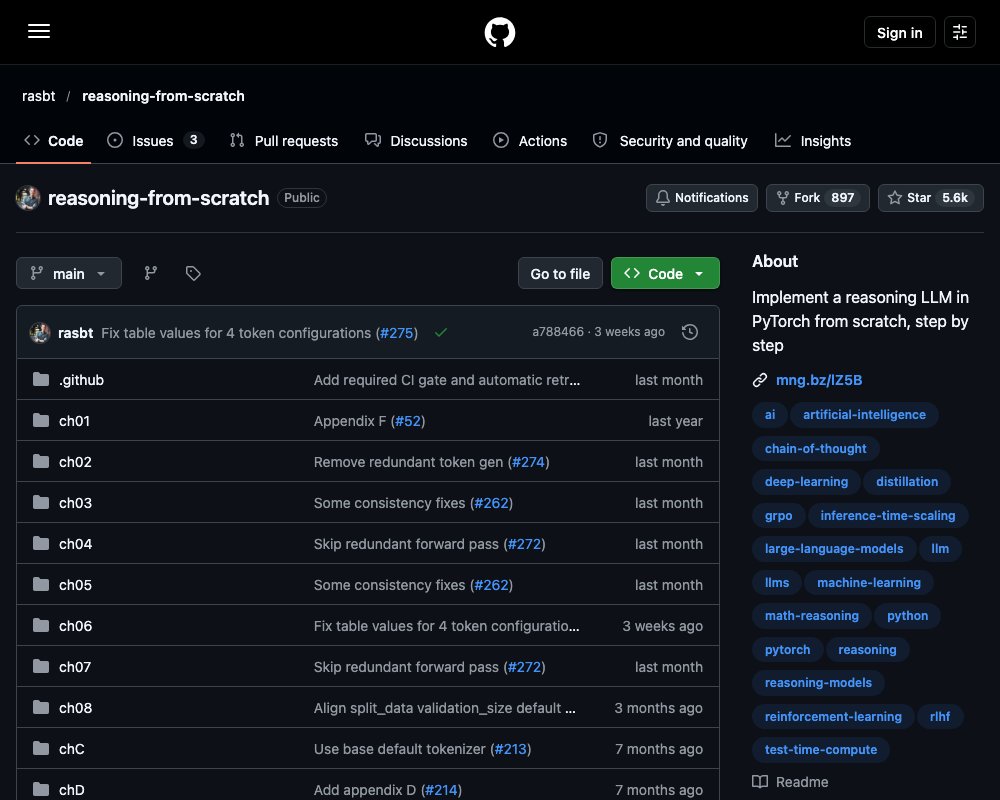
Рассуждающие модели — главная тема последних лет в развитии LLM. Модели вроде DeepSeek R1 или GPT-5 Thinking сначала рассуждают шаг за шагом, а потом дают ответ. Но если читать о них только теорию, легко составить себе неверное представление о том, как всё устроено внутри. Себастьян Расчка (Sebastian Raschka), автор известной книги Build a Large Language Model (From Scratch), написал продолжение — Build a Reasoning Model (From Scratch) (Manning, 2025). Этот репозиторий — официальный код книги. Здесь вы собираете собственную небольшую, но работающую рассуждающую модель на PyTorch.
У репозитория уже больше 5,6 тысячи звёзд на GitHub. Код открыт под лицензией Apache-2.0 и покрыт автотестами на Linux, macOS и Windows.
Идея книги
Автор выбирает практический путь. Мы не пишем LLM с самого нуля. Берём готовую предобученную базовую модель Qwen3 с открытыми весами и добавляем к ней рассуждения своими руками, шаг за шагом, в коде. Так видно, как устроен каждый приём.
Методы в книге повторяют то, что применяли создатели больших рассуждающих моделей: DeepSeek R1, GPT-5 Thinking и других. Отдельная часть кода отвечает за загрузку весов уже обученных моделей.
Из чего состоит курс
Восемь глав плюс приложения. Каждая глава — это Jupyter-ноутбук с основным кодом и отдельный ноутбук с решениями упражнений.
| Глава | Тема | Код |
|---|---|---|
| 1 | Как устроены рассуждающие модели | без кода |
| 2 | Генерация текста предобученной LLM | ch02_main.ipynb |
| 3 | Оценка качества рассуждающих моделей | ch03_main.ipynb |
| 4 | Улучшение рассуждений масштабированием на этапе инференса | ch04_main.ipynb |
| 5 | Масштабирование через самоисправление | ch05_main.ipynb |
| 6 | Обучение с подкреплением | ch06_main.ipynb |
| 7 | Улучшаем GRPO | ch07_main.ipynb |
| 8 | Дистилляция рассуждающих моделей | ch08_main.ipynb |
Основная линия такая. Сначала учимся генерировать текст базовой моделью и измерять её качество на задачах по математике (датасет MATH-500). Потом улучшаем ответы без переобучения. Выражение «масштабирование на этапе инференса» означает простую вещь: модель не переобучают, а тратят больше вычислений на один ответ (инференс — это прогон уже обученной модели). Просим модель рассуждать вслух (chain-of-thought), генерируем несколько вариантов и выбираем ответ голосованием (self-consistency), берём лучшее из N попыток (Best-of-N) или пусть модель дорабатывает свой ответ сама (self-refinement).
Дальше начинается обучение. В главах 6–7 модель учится через обучение с подкреплением методом GRPO. Идея простая: модель генерирует группу ответов на задачу, ответы сравнивают между собой, и модель учится повторять удачные. В главе 7 автор показывает улучшенные варианты GRPO в духе DeepSeek-V3.2, Olmo3 и GDPO.
Финальный приём — дистилляция. Большая модель-учитель генерирует примеры с рассуждениями, а маленькая модель учится на них. В книге учитель работает через Ollama или OpenRouter. Дистилляция делает рассуждения дешевле: маленькая модель отвечает быстро, но рассуждает.
Приложения
Отдельные приложения закрывают практические вопросы:
- Приложение C — исходный код архитектуры Qwen3 (chC_main.ipynb).
- Приложение D — работа с более крупными LLM (chD_main.ipynb).
- Приложение E — батчинг и пропускная способность (chE_main.ipynb).
- Приложение F — обзор методов оценки LLM: MMLU, лидерборды, «LLM как судья» (chF_main.ipynb).
- Приложение G — простой чат-интерфейс (код в chG).
Железо и окружение
Код написан так, чтобы работать на обычном домашнем компьютере за разумное время. Специальный сервер не нужен. GPU код подхватывает автоматически, если он есть.
Главы 2–4 спокойно работают и на CPU, и на GPU. Для глав 5 и 6, где идёт обучение, автор советует GPU, если хотите воспроизвести результаты глав.
Инструкции по установке Python и настройке окружения собраны в отдельном документе. Если что-то не запускается, смотрите гайд по решению проблем.
Склонировать репозиторий можно так:
git clone --depth 1 https://github.com/rasbt/reasoning-from-scratch.gitУпражнения и бонусные материалы
В каждой главе есть упражнения. Решения собраны в приложении B, а код с ними лежит в папках глав — например, ch02_exercise-solutions.ipynb рядом с основным ноутбуком.
Помимо основного кода, в репозитории много бонусных папок. Вот самые полезные находки:
- скрипты проверки ответов на MATH-500 и гибридный парсер LaTeX — к главе 3;
- скрипты масштабирования инференса на MATH-500: chain-of-thought, self-consistency, Best-of-N и самоисправление — к главам 4 и 5;
- скрипты GRPO с пакетным режимом и продвинутые варианты в духе DeepSeek-V3.2, Olmo3 и GDPO — к главам 6 и 7;
- скачивание готовых чекпоинтов обучения для глав 6–8;
- генерация данных для дистилляции через Ollama или OpenRouter и запуск моделей через Hugging Face
transformers— к главе 8.
Цитирование
Если книга или код пригодились в исследовании, автор просит сослаться на них. BibTeX-запись из репозитория:
@book{build-llms-from-scratch-book,
  author       = {Sebastian Raschka},
  title        = {Build A Reasoning Model (From Scratch)},
  publisher    = {Manning},
  year         = {2025},
  isbn         = {9781633434677},
  url          = {https://mng.bz/lZ5B},
  github       = {https://github.com/rasbt/reasoning-from-scratch}
}
Книга-компаньон
Build a Reasoning Model (From Scratch) — самостоятельная книга про методы улучшения рассуждений. Как устроена сама базовая LLM, здесь не объясняется. Если нужен фундамент, посмотрите предыдущую книгу автора Build a Large Language Model (From Scratch).
Полезные ссылки
- Репозиторий книги — лицензия Apache-2.0
- Книга на сайте Manning
- Обсуждения на GitHub
Поскольку репозиторий сопровождает печатную книгу, автор не принимает правки, которые меняют код основных глав, — текст книги и код должны совпадать. Вопросы и отзывы он просит оставлять в Manning Discussion Forum или GitHub Discussions.