

e2e — фреймворк сквозного тестирования, где цель теста пишется словами, а повтор идёт без модели
📂 Исходный код на GitHubФреймворк сквозного тестирования для веб- и мобильных приложений: агент выполняет цель, описанную в обычном тексте, тест проверяет результат локаторами, а подтверждённые действия записываются и в следующий раз повторяются без вызовов модели. Работает поверх Playwright и агент-девайс, поддерживает веб, iOS и Android, лицензия Apache-2.0.
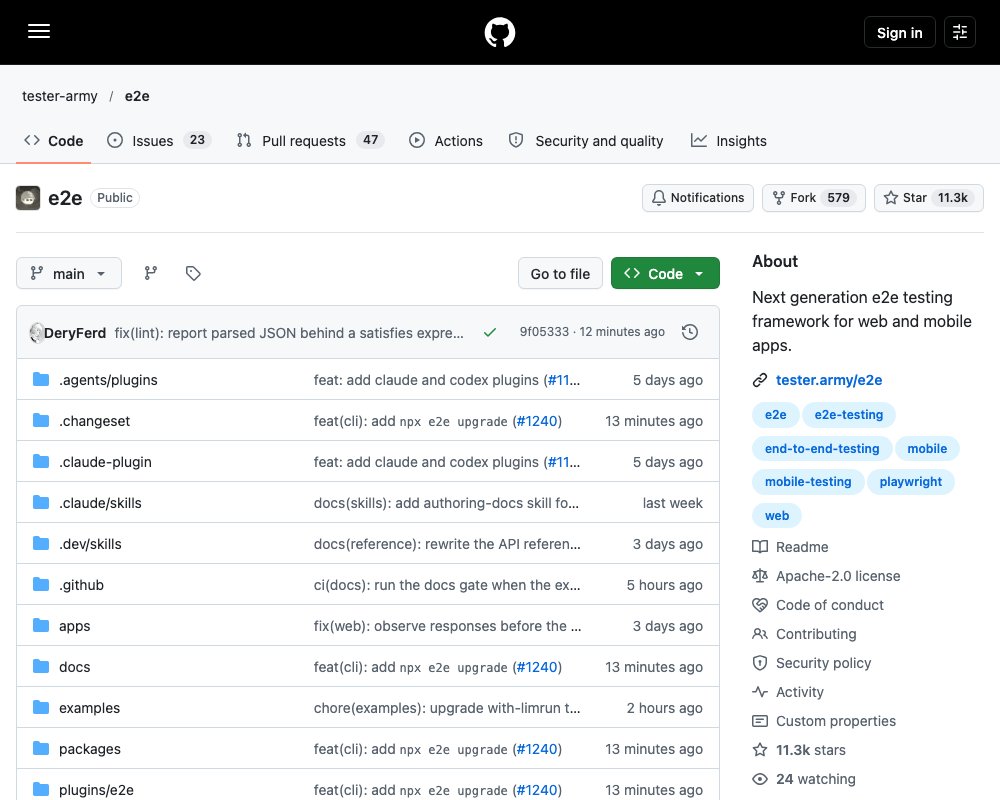
e2e — это открытый фреймворк сквозного тестирования для веб- и мобильных приложений, созданный командой TesterArmy. Сквозной тест (E2E, от англ. end-to-end) — это проверка всего пути пользователя через приложение целиком: от первого клика до конечного результата, а не отдельной функции или экрана. Обычно такие тесты пишутся руками: разработчик открывает страницу, кликает по кнопкам, ищет нужный элемент в DOM и фиксирует результат. Это работает, но дорого: любой редизайн ломает половину тестов, а поддерживать их никто не берётся.
Проект предлагает другой подход. Вместо того чтобы описывать, как нажать кнопку, вы пишете обычную фразу: «перевести рабочее пространство на тариф Pro». Агент сам смотрит на экран, принимает решения и доводит приложение до нужного состояния. Результат вы проверяете обычными локаторами и проверками — уже без участия модели.
Ключевая деталь, которая делает подход пригодным для CI: если шаг агента позже подтверждается проверкой, раннер записывает все действия, которые агент совершил. На следующем прогоне тест повторяет записанные действия без единого вызова модели. Стоимость падает до нуля, тест остаётся обычным тестом с обычными проверками, и при этом он по-прежнему проверяет реальное приложение.
Репозиторий: https://github.com/tester-army/e2e — Apache-2.0, TypeScript, около 11 300 звёзд. Документация: https://e2e.tester.army/docs.
Как устроен цикл «агент → проверка → повтор»
Ключевая идея проекта — в том, что агент и проверка живут в одном тесте и связаны между собой.
// tests/checkout.e2e.ts
import { test, expect } from 'e2e';

test('a member upgrades to Pro', async ({ app, agent, screen }) => {
  await app.open('/settings/billing');

  await agent.act('upgrade the workspace to the Pro plan');
  await agent.assert('the invoice preview shows a prorated amount');

  await expect(screen.getByRole('status')).toContainText('Pro');
});
Читать этот код нужно так. agent.act получает цель и сам выбирает действия: открывает нужную вкладку, нажимает кнопки, заполняет поля. agent.assert — тоже обращение к модели, но уже не действие, а проверка: «показывает ли экран, что сумма пересчитана за неполный период». Дальше идёт expect с локатором — это уже обычная проверка без модели, она ищет на странице элемент с ролью status и проверяет, что в нём есть слово Pro.
Механика повтора работает так:
- Агент выполняет цель и записывает последовательность действий: какие элементы нажаты, что введено, какой экран получился в итоге.
- Сразу после шага идёт проверка. Если проверка прошла, запись считается подтверждённой и сохраняется в кэш повторов (по умолчанию — папка
.e2e/cache/в проекте). - На следующем прогоне раннер не зовёт модель. Он проверяет, что открыт тот же маршрут, находит записанные элементы по роли, имени и test id, повторяет действия и сверяет конечное состояние с записанным.
- Если приложение изменилось — кнопка переехала, появилась новая страница, изменилось имя элемента — повтор не срабатывает, и агент берёт шаг на себя, продолжая с текущего экрана. Тест при этом не падает из-за «сломанного кэша», а просто дорожает на один вызов модели.
Что именно считается подтверждением записи, важно понимать отдельно. Подтверждают: проверки локаторов вида expect(locator).toHaveText(...), проверки адреса и URL, ожидания появления элемента, а также agent.assert и agent.waitFor. Не подтверждают: сравнение простого значения (expect(value).toBe(...)), чтение текста элемента, expect.poll и сам по себе успешный прогон шага. То есть записать действия «просто потому, что шаг не упал» нельзя — нужно, чтобы результат действия кто-то проверил.
Отдельно стоит сказать про данные, которые меняются от прогона к прогону. Дата, свежий email или сгенерированный идентификатор приведут к тому, что кэш никогда не совпадёт. Для таких значений есть обёртка unique(): она подставляет актуальное значение в момент повтора.
import { unique } from 'e2e';

const name = `E2E ${Date.now()} Company`;
await agent.act('create a company named {name}', { params: { name: unique(name) } });
await expect(screen.getByRole('heading', { name })).toBeVisible();
Параметры, которые меняют сам сценарий (выбор тарифа, например), передаются обычным params — такие значения повторяются как есть. Параметры, которые меняют только вводимые данные, оборачиваются в unique().
Ещё один режим кэша — read-only. В CI по умолчанию записи не пишутся, но прочитываются. В сочетании с флагом --strict-cache устаревшая запись не отдаётся агенту, а сразу роняет прогон с кодом REPLAY_STALE. Это полезно, когда вы хотите платить за модель только при реальном изменении интерфейса, а не молча перезаписывать запись на каждом прогоне.
Что вообще можно проверять
В тесте смешиваются три вида шагов, и разница между ними определяет, платите ли вы за модель.
| Вид шага | API | Обращение к модели |
|---|---|---|
| Цель | agent.act |
Да, если кэш не повторил шаг |
| Проверка смысла | agent.assert, agent.waitFor, agent.extract |
Да |
| Локатор | screen и expect |
Нет |
Локатор — это способ найти конкретный элемент: по роли и имени, по подписи поля, по test id. Он ничего не знает про смысл интерфейса и работает всегда одинаково. Именно поэтому проверки на локаторах стоит ставить в тех местах, где важна точная строка или точное значение.
Проверки смысла нужны там, где написать точное ожидание невозможно: «график идёт вверх», «на экране есть бейдж пробного периода», «поле с ошибкой подсвечено». Модель в этом случае смотрит на экран и решает, выполнено условие или нет. Если данных на экране не хватает, чтобы сделать вывод, проверка честно падает с кодом ASSERTION_INCONCLUSIVE — молчаливого «наверное, да» здесь нет.
agent.extract вытаскивает данные с экрана в типизированную структуру — например, через схему Zod. Это удобно, когда нужно собрать список и проверить его обычным expect уже без модели.
Отдельно отмечу правило, которое экономит деньги: одна цель — одна проверка. Просить агента сделать три разных дела в одном вызове (открыть тариф Pro, выставить три места и оформить заказ) — плохая идея. Правильная версия разбивает это на три шага, и каждый проверяется сразу. Так при сбое вы точно знаете, какой именно шаг сломался, и каждый шаг получает свой отдельный лимит вызовов модели и действий.
Установка и первые шаги
Нужен Node.js 24.8 или новее (либо 22.22.3 и выше в ветке Node 22). На Windows запуск идёт внутри WSL. Для мобильных тестов дополнительно нужен Xcode с рантаймом симулятора iOS либо Android SDK с эмулятором.
Мастер настройки делает всё сам:
npx e2e initОн спрашивает, какой движок использовать (веб через Playwright или мобильный через симуляторы и эмуляторы), и какой источник модели выбрать: шлюз (Vercel AI Gateway, OpenRouter, любой совместимый с OpenAI эндпоинт), подписку на ChatGPT, GitHub Copilot, OpenCode Console или SuperGrok — либо ничего, если тесты обойдутся без ИИ. Дальше мастер создаёт конфиг, пример теста и записи в .gitignore. Также он умеет поставить скилл агента (папка .agents/skills/e2e/) и зарегистрировать MCP-сервер в .mcp.json и .cursor/mcp.json. Существующие файлы он не трогает.
Первый тест запускается так:
npx e2e runПример теста, который создаёт мастер, работает без модели вообще — он просто открывает страницу и проверяет, что она видна. Дальше вы добавляете шаг с агентом, и вот тут уже понадобится ключ.
Модель подключается на ваш выбор. Через шлюз (Vercel AI Gateway, OpenRouter, любой совместимый с OpenAI эндпоинт) или через локальный сервер. Либо через уже оплаченную подписку: ChatGPT Plus или Pro, GitHub Copilot, OpenCode Console, SuperGrok или X Premium+, а также API-кредиты тарифов Claude Max и Team. Подписки подключаются одной командой:
npx e2e login openai
npx e2e login github-copilot
npx e2e login opencode-console
npx e2e login spacexai
Конфиг выглядит компактно:
import type { E2EConfig } from 'e2e';
import { web } from '@e2e-dev/web';
import { gateway } from 'ai';

export default {
  agents: { default: { model: gateway('openai/gpt-6-luna-fast') } },
  targets: [{ engine: web(), app: { url: 'http://localhost:3000' } }],
} satisfies E2EConfig;
Обратите внимание на поле agents. Это несколько «персон» в одном наборе тестов: у каждой свой агент со своим промптом, своим контекстом и, при желании, своей моделью. Тест привязывается к персоне через параметр, и один и тот же сценарий можно прогнать глазами покупателя и глазами администратора.
Состав пакетов
Проект разбит на несколько пакетов, чтобы платить только за то, что реально используется. Полный список лежит в каталоге packages репозитория: https://github.com/tester-army/e2e/tree/main/packages.
| Пакет | Зачем нужен |
|---|---|
e2e |
Ядро: SDK, раннер и CLI |
@e2e-dev/web |
Браузерный движок: Chromium, Firefox и WebKit через Playwright |
@e2e-dev/mobile |
Мобильный движок: симуляторы iOS и эмуляторы Android |
@e2e-dev/github |
Репортер, который публикует результаты комментарием к pull request |
@e2e-dev/kernel |
Размещённые браузеры Kernel для веб-движка |
@e2e-dev/lightpanda |
Lightpanda — открытый браузер без графического интерфейса, запускается на каждый прогон |
@e2e-dev/limrun |
Размещённые симуляторы iOS и эмуляторы Android в Limrun |
@e2e-dev/eas |
Размещённые устройства EAS Simulators |
@e2e-dev/smol |
Браузеры на smol machines: каждая попытка стартует отдельной веткой тёплой микровиртуальной машины с Chromium |
@e2e-dev/decision |
Исполнители на основе небольших моделей принятия решений: ограниченный набор действий и проверок вместо полноценного агента |
@e2e-dev/testmu |
Размещённые эмуляторы Android, симуляторы iOS и реальные устройства TestMu AI (бывший LambdaTest) |
Шесть пакетов из таблицы — это мост к внешним сервисам, которые решают неприятную практическую задачу: где вообще запускать браузер или устройство. Своя машина в CI обычно неудобна, а внешние сервисы решают это за деньги. Пакет @e2e-dev/decision — отдельная история: если полноценная большая модель не нужна, шаги можно выполнять гораздо более дешёвой моделью принятия решений, которая умеет ограниченный набор действий и проверок.
Готовые примеры под разные стеки
В каталоге examples лежат самостоятельные проекты — каждый со своим стеком и работающим набором тестов. Общий демо-пример один: вводишь имя и жмёшь «Поздороваться».
| Пример | Технология | Где запускается |
|---|---|---|
with-vite |
Vite и React | Chromium |
with-next |
Next.js App Router | Chromium |
with-astro |
Astro | Chromium |
with-expo |
Expo и React Native | Chromium, симулятор iOS, эмулятор Android |
with-swiftui |
SwiftUI | Симулятор iOS |
with-compose |
Jetpack Compose | Эмулятор Android |
with-kotlin-multiplatform |
Kotlin Multiplatform и Compose Multiplatform | Эмулятор Android, симулятор iOS |
with-flutter |
Flutter | Эмулятор Android, симулятор iOS |
with-maui |
.NET MAUI | Эмулятор Android, симулятор iOS |
with-limrun |
Те же приложения, но на размещённых устройствах | Удалённые iOS и Android |
Полный список с командами запуска: https://github.com/tester-army/e2e/blob/main/examples/README.md. Каждый пример ставит опубликованные пакеты из npm и работает вне репозитория, так что его можно взять как стартовый шаблон. В примерах агентные тесты требуют ключа AI_GATEWAY_API_KEY; без него они просто пропускаются.
Кодинг-агент, который проверяет свои локаторы
Отдельная часть проекта — MCP-сервер e2e mcp, который даёт кодинг-агенту (Claude Code, Codex, Cursor) живую сессию на вашем приложении. Агент видит экран, действует на нём и проверяет свою работу. Модель для этого не нужна — сервер просто отдаёт состояние приложения.
Практическая польза вполне конкретная. Раньше агент, писавший тест, угадывал локаторы по исходному коду и узнавал об ошибке только после прогона. Теперь он может проверить каждый локатор заранее, прямо в приложении:
0 nodes match getByLabel("Email").
A test using this locator would fail with LOCATOR_NOT_FOUND. ...

1 node matches getByRole("button", name: "Sign in").
Use: screen.getByRole("button", "Sign in")
Такой разбор ошибок экономит кодинг-агенту несколько циклов «угадал — запустил — упало — попробовал снова».
Есть и режим «без теста вообще». Команда e2e explore даёт агенту цель и наблюдение за приложением, а не готовый тест. Агент сам строит план, выполняет шаги и собирает находки: с серьёзностью проблемы, шагами для воспроизведения и, где возможно, скриншотом. Находки уровня issue роняют прогон с кодом 1, предупреждения — нет. Так можно за один прогон обойти приложение и получить список подозрительных мест, а затем превратить каждое в падающий тест.
Сколько стоит прогон
Ответ на этот вопрос — главный аргумент проекта. Из расходов вычитаются три вещи.
Во-первых, шаги без агента вообще не стоят ничего. Тест, в котором есть только локаторы и expect, не требует ни ключа, ни подписки. Такой тест можно гонять в CI сколько угодно.
Во-вторых, подтверждённые шаги повторяются без модели. В сводке прогона это видно прямо:
           AI  4.1k tokens · 2 model calls · anthropic/claude-sonnet-4.5
        Cache  4 replayed · 1 handed off · 1 missed
Четыре шага воспроизведены из записи, один передан агенту (значит, интерфейс изменился), один выполнен агентом с нуля.
В-третьих, у каждого вызова есть лимит: бюджет обращений к модели и таймаут. Целевое действие, которое не сработало, снимается через 15 секунд. Цикл замечает повторяющиеся вызовы и зацикливание: после трёх неудачных действий подряд агенту говорят сменить подход, после пяти просят вынести вердикт. Отдельный вызов assert делает одно заключение плюс один повтор, если ответ не пришёл в нужном формате.
Вердикт у шага всегда один из трёх: passed (на экране видно, что цель достигнута), failed (условие не выполнено или его нельзя показать) и blocked (шаг остановила внешняя причина — не настроенные данные, упавшее окружение, исчерпанный лимит). Только у failed и blocked есть код ошибки, и он влияет на код возврата процесса.
Запуск в CI и в рабочей машине
Тесты запускаются в GitHub Actions, EAS Workflows, Bitrise и Codemagic. Репортер @e2e-dev/github публикует результат одним комментарием к pull request и обновляет его при следующих прогонах. Отчёты, трассы, скриншоты и логи складываются в .e2e/.
Полезно помнить про две настройки по умолчанию. Локально кэш пишется и читается, в CI — только читается, если в конфиге не сказано иное. Кэш можно закоммитить в репозиторий, чтобы прогоны в CI сразу попадали в записанные сценарии; команда e2e init добавляет .e2e/cache/ в .gitignore, так что это нужно сделать руками. Отключить кэш для одного прогона можно флагом --no-cache.
Команды для работы с кэшем:
npx e2e cache ls      # list entries: test, target, age, number of actions
npx e2e cache stats   # entry count and size
npx e2e cache clear   # delete every entry
Ещё один полезный приём — общая папка кэша для нескольких копий проекта. Переменная E2E_CACHE_DIR (или флаг --cache-dir) указывает, где лежат записи; важно только, чтобы у всех копий был одинаковый projectId в package.json, иначе они не увидят записи друг друга.
Безопасность и приватность
Модель не видит сырой HTML, куки, заголовки и значения переменных окружения. На экране пароли маскируются, а значение секрета, если оно настроено, показывается как <secret:name>. Секреты вводятся отдельным инструментом type_secret: модель видит только имя секрета, а само значение подставляет раннер. Значение секрета не попадает ни в промпты, ни в отчёты, ни в трассы.
Дополнительно есть режим vision — скриншот с маскированием, когда одного текстового описания экрана недостаточно. Модель может действовать и по координатам на картинке, если так описать элемент словами не получается. Расплата за картинки — дополнительные входные токены, поэтому снимок берётся только тогда, когда без него не обойтись.
Телеметрия CLI собирает анонимные данные: какие команды и движки запускались и где прогон упал. Содержимое тестов, содержимое приложения и учётные данные не передаются. Отключается командой npx e2e telemetry disable или переменной E2E_TELEMETRY_DISABLED=1. Полный список полей — https://e2e.tester.army/docs/telemetry.
Уязвимости безопасности не следует выносить в публичные issue: https://github.com/tester-army/e2e/blob/main/SECURITY.md, письма — на security@tester.army.
Итог
e2e стоит рассматривать не как «Playwright с ИИ», а как попытку сделать агентный шаг частью обычного теста, а не отдельной дорогой веткой. Механика простая и понятная: агент сделал шаг — проверка подтвердила результат — шаг записан; в следующий раз шаг воспроизводится без модели. Пока приложение не меняется, тест стоит почти ноль; когда меняется — агент подхватывает шаг и чинит запись.
Ограничения стоит знать заранее. Проект ещё не дошёл до версии 1.0, и API вместе с конфигом могут меняться между минорными релизами. Модель в агентных шагах остаётся слабым звеном: чем точнее формулировка цели и чем лучше слова на экране совпадают с формулировкой, тем реже нужно вмешательство человека. Всё, что касается работы агента внутри шага, описано в документе https://e2e.tester.army/docs/agent-steps, а кэш повторов разобран отдельно: https://e2e.tester.army/docs/cache.
Участие в проекте принимается через CONTRIBUTING: https://github.com/tester-army/e2e/blob/main/CONTRIBUTING.md. Вопросы обсуждаются в Discord-сообществе TesterArmy: https://tester.army/discord. Лицензия — Apache-2.0: https://github.com/tester-army/e2e/blob/main/LICENSE.
Источник: https://github.com/tester-army/e2e