Unbrowse: агенты вызывают внутренние API сайтов напрямую, без браузера
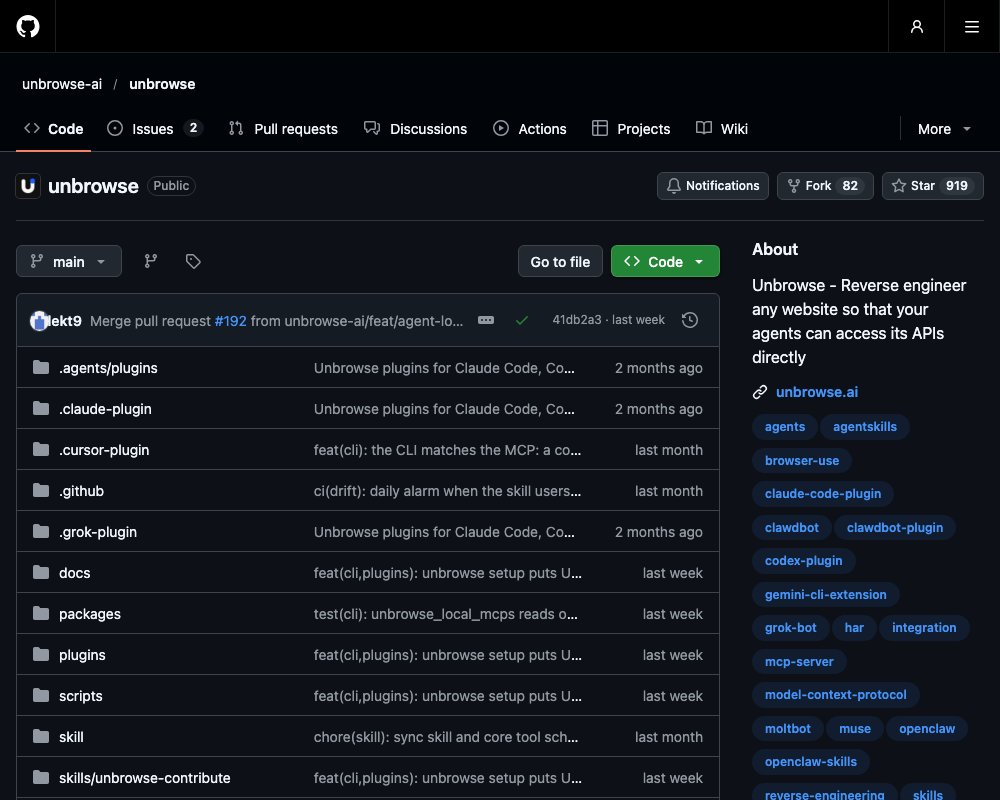
📂 Исходный код на GitHubКлиент с открытым кодом (TypeScript SDK и CLI) для сервиса unbrowse.ai: обращается к внутренним API сайтов напрямую вместо работы через браузер. Освоение сайта — через облачный браузер или два HAR-файла, дальше задачи проигрываются обычными HTTP-запросами. Лицензия MIT, основной язык — TypeScript.
У каждого сайта, даже без официального API и без MCP-сервера, фронтенд всё равно общается с бэкендом через свой внутренний HTTP API. Unbrowse использует это: он один раз разбирает, какие запросы делает сайт, а дальше проигрывает их напрямую. По заявлению авторов, такой подход ускоряет агентную работу с вебом в 50–100 раз и удешевляет её на 95% по сравнению с управлением браузером.
Это клиент с открытым кодом для облачного сервиса unbrowse.ai: TypeScript SDK @unbrowse/sdk для REST API и CLI unbrowse, построенный поверх него. Лицензия MIT, основной язык — TypeScript. Сам разбор сайтов выполняет облако, клиент только отправляет запросы.
Зачем это нужно
Типичный агент решает веб-задачи через браузер: открывает страницу, кликает, ждёт отрисовку, читает DOM. Это медленно и дорого: на каждый шаг уходят токены, а браузер нужно где-то запускать. Авторы Unbrowse предлагают другой путь. Раз фронтенд сайта уже ходит в бэкенд по HTTP, агент может делать те же запросы сам — без браузера, без селекторов и без ожидания рендера. Этой идее посвящена отдельная статья команды, «Internal APIs Are All You Need» (текст в репозитории, arXiv:2604.00694).
Как это работает
Работа строится на «способностях» (capabilities) — скомпилированных инструментах по одному на задачу конкретного сайта. Цикл из трёх шагов:
- Поиск (Discover). Unbrowse ищет подходящую способность сначала в вашем приватном пространстве, затем в публичном реестре сайтов, уже разобранных в инструменты.
- Запуск (Run). Найденная способность проигрывает те самые запросы, которыми сайт общается со своим бэкендом, но уже с новыми входными данными. Без браузера. Запуск считается успешным только когда результат проверен: один HTTP 200 ещё ничего не значит.
- Обучение (Learn once). Подходящей способности нет — агент выполняет задачу в записывающем облачном браузере Unbrowse (через MCP), либо вы загружаете две HAR-записи одной задачи (
unbrowse learn a.har b.har). Unbrowse компилирует запросы в способность, которую дальше можно вызывать одним обращением. Следующий раз — сразу шаг 2.
Подробности разбора описаны в docs/how-it-works.md. При обучении сервис группирует записанные запросы по семействам и выбрасывает пиксели, аналитику и опросы. Затем сравнивает две сессии с разными входными данными и на этой разнице определяет, какие поля запроса — это входы. Каждый токен и идентификатор (CSRF, номера заказов, id выбранного элемента) прослеживается до ответа, который его породил, поэтому многошаговый сценарий превращается в один вызов. Названия входов берутся из имён, которые агент дал заполняемым полям (origin, date, query). Результат — способность вида learned.*: версионированный YAML-каркас формата unbrowse/v1alpha1 плюс сгенерированный SKILL.md.
У каждой способности есть подсказки для агента: состояние (warm — проигрывается по HTTP, быстро; rendered — нужен рендер страницы в браузере, медленнее; cold — ещё не запускалась), здоровье (healthy, degraded, failing и другие), задержки p50/p95 и поле next — точный следующий шаг. Агент следует подсказке next и пропускает способности в состоянии failing или excluded, если есть альтернатива.
Когда сайт сопротивляется, предусмотрены обходы. Проверки на бота вида «Just a moment…» просто дожидаются в браузере с видимым окном. Если сайт однажды показал такую проверку, запросы к нему начинают отправляться с TLS-отпечатком настоящего браузера. А когда проигрывание не смогло ответить, страница отрисовывается в браузере — такой запуск помечается via: "rendered".
Подключение агентов
Самый быстрый способ — настроить сразу всех агентов на машине:
npx -y unbrowse setup && npx -y unbrowse loginsetup находит установленные хосты (Claude Code, Codex, Cursor, Gemini CLI, Copilot CLI, opencode, Windsurf), записывает навык unbrowse и навык unbrowse-contribute в папки навыков каждого хоста и в общий ~/.agents/skills, добавляет короткое правило «always use» в глобальные инструкции и регистрирует локальный MCP-прокси у Claude Code и Codex. После этого агенты обращаются к Unbrowse для любой веб-работы без дополнительных указаний.
Другие варианты:
# Только навык
npx skills add unbrowse-ai/unbrowse --skill unbrowse

# Удалённый MCP (OAuth в клиенте)
claude mcp add --transport http unbrowse https://unbrowse.ai/mcp
Навык, которому следуют подключённые агенты, лежит в skill/SKILL.md. Для хостов, требующих stdio, команда unbrowse mcp поднимает локальный прокси к облачному MCP-серверу. Есть плагины для Claude Code, Codex, Grok Build, OpenClaw, Hermes и elizaOS (plugins/); Grok, ChatGPT, Claude, Perplexity, Le Chat и Gemini CLI подключаются как custom connector (docs/connect.md).
Отдельный навык unbrowse-contribute описывает, что делать, когда ломается сам Unbrowse: агент запускает unbrowse bug, получает готовый отчёт об ошибке и открывает PR с исправлением в репозиторий — но только спросив человека (skills/unbrowse-contribute/SKILL.md).
CLI
CLI — тонкая оболочка над REST API /api/v1; JSON уходит в stdout, служебные сообщения — в stderr. Каждому инструменту MCP соответствует команда. Основные:
unbrowse login [--key ub_live_…]    sign in (browser OAuth) or store an API key
unbrowse discover <query>           your capabilities, then the public registry
unbrowse run <task…> [--set k=v]    run a task from your IP; waits for a verified result
unbrowse resume <runId> k=v…        answer what the run asked for, on the same run
unbrowse scrape <url>               read one page as markdown
unbrowse index <url>                teach Unbrowse a site: each flow becomes a tool
unbrowse learn a.har b.har          compile two recordings into a capability
unbrowse logins                     saved logins, masked
unbrowse registry [query]           public compiled sites (no account)
Коды выхода: 0 — успех, 1 — ошибка, 2 — нужен ввод (resume), 3 — требуется вход или логин, 4 — результат не проверен. Полный справочник — в docs/cli.md.
У запуска есть пять статусов. accepted и working — задача в работе. succeeded — результат получен и проверен. input_required — запуск ждёт ответы на уточняющие вопросы; их отправляют командой resume на том же запуске. outcome_unknown — изменение, возможно, произошло; вслепую повторять такой запуск нельзя. failed — ошибка. По умолчанию HTTP-запросы к сайту уходят с вашего IP; опция --from-unbrowse переключает исходящий трафик на серверы сервиса.
SDK
Для интеграций на TypeScript:
import { Unbrowse } from "@unbrowse/sdk";

const ub = new Unbrowse(); // UNBROWSE_API_KEY

let run = await ub.run({ task: "top stories on Hacker News", idempotencyKey: crypto.randomUUID() });
run = await ub.wait(run.runId); // until it leaves accepted/working
Ключ передавайте через idempotencyKey, если возможен повтор: с тем же ключом вернётся тот же запуск, а не новый. SDK без зависимостей, работает на Node 18.17+, Bun, Deno и любом рантайме с fetch. Справочник — в docs/sdk.md.
Пароли и доступы
CLI никогда не принимает пароль. Логины живут в менеджере паролей Unbrowse. В облачном браузере действие unbrowse_browse_act с autofill заполняет форму входа из хранилища — значения не проходят через агента. При проигрывании ответ 401 от сайта с сохранённым логином запускает один вход через браузер; сессия кэшируется и переиспользуется. Если логина нет, запуск возвращает одноразовую ссылку для сохранения пароля, а CLI выходит с кодом 3.
Есть и другой путь — переиспользовать сессии своего браузера: unbrowse cookies sync читает куки локально (расшифровка через системный keychain), загружает их в хранилище, а unbrowse cookies daemon держит их свежими в фоне. Читается только то, что вы явно синхронизировали.
Открытый код и публичный реестр
Код клиента открыт, разбор сайтов выполняет облачный сервис; граница описана в docs/open-source.md. Тарифы проверяются командой unbrowse usage (docs/pricing.md).
Публичный реестр пополняется сам. Маршруты, которые только читают данные и не требуют секретов, по умолчанию после очистки попадают в общий доступ (это можно отключить в консоли). Маршрут публикуется только после проверки: очищенная копия без куки должна отвечать на свежие запросы и ошибиться на бессмысленном. Логины и операции, которые что-то меняют на сайте, не публикуются никогда.
Каждый разобранный сайт дополнительно доступен как отдельный MCP-сервер (/api/v1/sites/<host>/mcp) и как документ OpenAPI 3.1. Для разработки: сборка на Bun, тесты SDK и CLI против локального стенда API, публикация по тегу версии.
Итог
Unbrowse занимает промежуточное место между «каждый раз водить настоящий браузер» и «вручную разбирать API сайтов». Сайт разбирается один раз — облачным браузером или из двух HAR-записей, — после чего задача вызывается как обычная функция с проверкой результата. Это не самостоятельный агент, а инфраструктура для ваших агентов: MCP-сервер, навык, CLI и SDK. Если у агента много повторяющихся веб-задач на одних и тех же сайтах, такой подход экономит и время, и токены.
Источник: https://github.com/unbrowse-ai/unbrowse