

Crawl4AI: открытый веб-краулер, который отдаёт страницы в виде Markdown для LLM
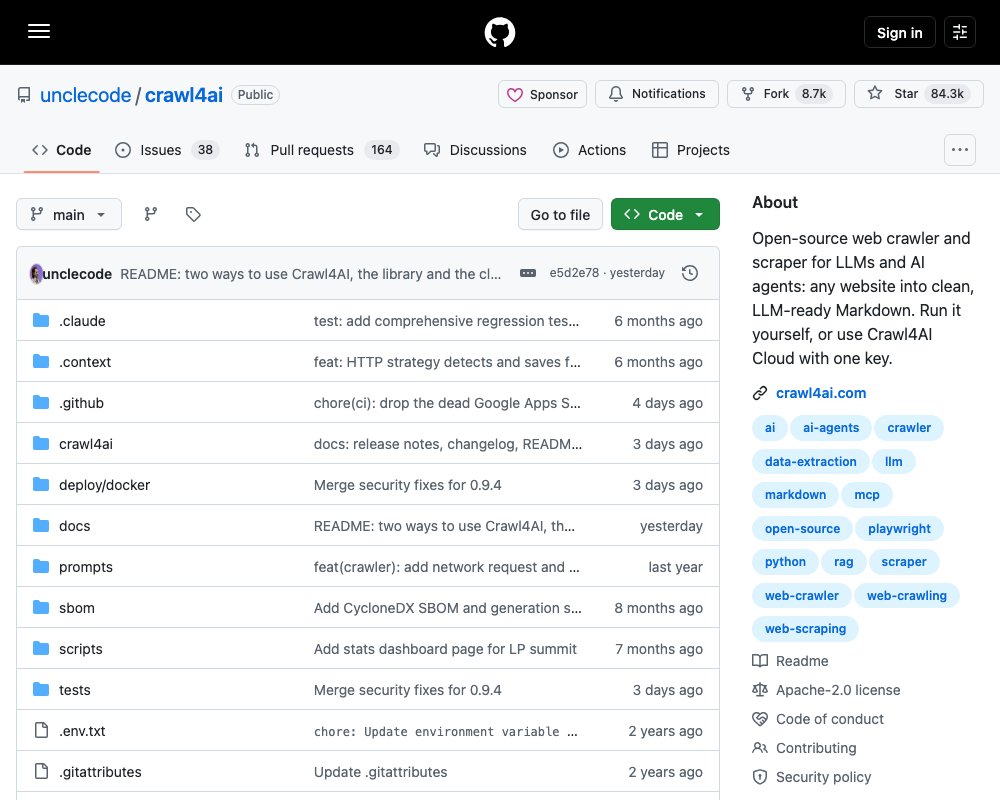
📂 Исходный код на GitHubОткрытый веб-краулер и скрапер для LLM и ИИ-агентов: превращает любой сайт в чистый, готовый для LLM Markdown. Лицензия Apache 2.0, язык — Python, более 84 тысяч звёзд на GitHub.
Crawl4AI: открытый веб-краулер, который отдаёт страницы в виде Markdown для LLM
Crawl4AI — Python-библиотека, Docker-сервер и облачный сервис, которые решают одну задачу: превращать произвольную веб-страницу в чистый Markdown, который удобно скормить LLM. Проект заточен под RAG, пайплайны данных и агентов, которым нужен доступ к вебу без боли с HTML-разметкой, рекламными вставками и навигационным мусором. Репозиторий на Python, лицензия Apache 2.0, на GitHub — больше 84 тысяч звёзд.
Смысл простой: если агент должен что-то прочитать в интернете, обычно приходится сначала писать свой скрапер, а потом переписывать его вывод в текст, пригодный для модели. Crawl4AI закрывает обе задачи сразу — это и браузерный движок, и генератор Markdown, и плагин для MCP.
Два способа использовать
Разработчик предлагает два пути, и выбор между ними — это выбор между «своё железо» и «свои деньги».
| 🐍 Библиотека | 🐳 Свой сервер | ☁️ Crawl4AI Cloud | |
|---|---|---|---|
| Кто крутит браузеры | вы, в своём Python-процессе | вы, в Docker на своей машине | авторы проекта |
| Тяжёлые JS-страницы и антиботы | ваши настройки и прокси | ваши настройки и прокси | решается автоматически |
| Поиск по вебу | — | — | /search и /answer |
| Цена | бесплатно, навсегда | бесплатно (ваш хостинг) | pay-as-you-go |
Локальный вариант ставится в две команды:
pip install -U crawl4ai
crawl4ai-setup        # one-time browser install
Дальше — обычный asyncio-код:
import asyncio
from crawl4ai import AsyncWebCrawler

async def main():
    async with AsyncWebCrawler() as crawler:
        result = await crawler.arun(url="https://news.ycombinator.com")
        print(result.markdown)

asyncio.run(main())
Облачный вариант — один ключ и REST-вызов без единого браузера на вашей стороне:
curl -s https://api.crawl4ai.com/scrape \
  -H "Authorization: Bearer $CRAWL4AI_KEY" \
  -H "Content-Type: application/json" \
  -d '{"url": "https://news.ycombinator.com"}' | jq -r .markdown
Тот же ключ работает для /search, /answer, /extract и для пачки URL разом (/scrape/batch, /scrape/jobs).
Генерация Markdown
Главная заявленная ценность — «умный» Markdown: заголовки, списки, таблицы и блоки кода в структуре, которую LLM читает спокойно. Поверх этого идут три механизма отсева мусора:
PruningContentFilterLXML— выкидывает меню, футеры и шаблонные блоки;BM25ContentFilter— то же, но применительно к конкретному запросу;LLMContentFilter— фильтрация средствами самой модели.
Ссылки на странице превращаются в нумерованный список цитат, а генератор Markdown можно заменить на свой: подключается кастомная стратегия, если дефолтная не устраивает.
Разница между сырым и отфильтрованным выводом видна на примере:
import asyncio
from crawl4ai import AsyncWebCrawler, BrowserConfig, CrawlerRunConfig, CacheMode
from crawl4ai.content_filter_strategy import PruningContentFilterLXML
from crawl4ai.markdown_generation_strategy import DefaultMarkdownGenerator

async def main():
    run_config = CrawlerRunConfig(
        cache_mode=CacheMode.BYPASS,
        markdown_generator=DefaultMarkdownGenerator(
            content_filter=PruningContentFilterLXML(threshold=0.48, threshold_type="fixed", min_word_threshold=0)
        ),
    )
    async with AsyncWebCrawler(config=BrowserConfig(headless=True)) as crawler:
        result = await crawler.arun(url="https://en.wikipedia.org/wiki/Web_crawler", config=run_config)
        print(len(result.markdown.raw_markdown), "characters of raw Markdown")
        print(len(result.markdown.fit_markdown), "characters after the filter")

asyncio.run(main())
Извлечение структурированных данных
Здесь у проекта четыре разных маршрута, и это важное различие — можно обойтись вообще без LLM:
JsonCssExtractionStrategy,JsonXPathExtractionStrategy,RegexExtractionStrategy— быстрый разбор по схеме, без участия модели;generate_schema— генерирует переиспользуемую схему по вашему описанию желаемого;LLMExtractionStrategy— извлечение в типизированную JSON-схему через любой провайдер, поддерживаемый LiteLLM (в том числе локальныйollama/llama3.3);CosineStrategy— находит среди чанков те, что соответствуют запросу.
Для больших страниц предусмотрено разбиение на чанки: по темам, по регулярке и по предложениям.
Схема на CSS выглядит так — никакого LLM не требуется:
import asyncio, json
from crawl4ai import AsyncWebCrawler, BrowserConfig, CrawlerRunConfig, CacheMode, JsonCssExtractionStrategy

schema = {
    "name": "Quotes",
    "baseSelector": "div.quote",
    "fields": [
        {"name": "text", "selector": "span.text", "type": "text"},
        {"name": "author", "selector": "small.author", "type": "text"},
        {"name": "tags", "selector": "a.tag", "type": "list", "fields": [{"name": "tag", "type": "text"}]},
    ],
}

async def main():
    run_config = CrawlerRunConfig(
        extraction_strategy=JsonCssExtractionStrategy(schema),
        scan_full_page=True,   # scroll to the end, so the page loads every quote
        scroll_delay=0.5,
        cache_mode=CacheMode.BYPASS,
    )
    async with AsyncWebCrawler(config=BrowserConfig(headless=True)) as crawler:
        result = await crawler.arun(url="https://quotes.toscrape.com/scroll", config=run_config)
        quotes = json.loads(result.extracted_content)
        print(f"Extracted {len(quotes)} quotes")

asyncio.run(main())
Управление браузером
Краулер умеет работать не в безликом headless-режиме, а как полноценный браузер:
- свой профиль — persistent-контекст с сохранёнными логинами, куками и настройками;
- удалённые браузеры — подключение по Chrome DevTools Protocol (CDP);
- сессии — состояние браузера живёт между шагами многошагового обхода;
- прокси — с аутентификацией и ротацией;
- stealth —
enable_stealthплюс отдельный адаптер недетектируемого браузера для сайтов, которые палят автоматизацию; - полный контроль — заголовки, куки, user-agent, вьюпорт;
- движки — Chromium, Firefox и WebKit.
Пример с сохранённым профилем — так проходят сайты с авторизацией:
import os
from pathlib import Path
from crawl4ai import AsyncWebCrawler, BrowserConfig, CrawlerRunConfig, CacheMode

async def main():
    user_data_dir = os.path.join(Path.home(), ".crawl4ai", "browser_profile")
    os.makedirs(user_data_dir, exist_ok=True)
    browser_config = BrowserConfig(headless=True, user_data_dir=user_data_dir, use_persistent_context=True)
    run_config = CrawlerRunConfig(cache_mode=CacheMode.BYPASS, magic=True)
    async with AsyncWebCrawler(config=browser_config) as crawler:
        result = await crawler.arun(url="ADDRESS_OF_A_CHALLENGING_WEBSITE", config=run_config)
        print(result.success, len(result.markdown))

asyncio.run(main())
Обход и скрапинг
Отдельного внимания стоит AdaptiveCrawler — он останавливается, когда уже научился достаточно, чтобы ответить на запрос. Это экономит и трафик, и деньги, если рядом стоит платная модель.
Остальное:
- глубокий обход в ширину, в глубину и best-first, с восстановлением после падений через
resume_state; - обнаружение URL через
AsyncUrlSeeder(sitemaps, Common Crawl) иDomainMapper; сprefetch=Trueпоиск URL идёт в 5–10 раз быстрее; - динамические страницы: выполнение JavaScript, ожидание элементов, полная прокрутка (
scan_full_page) для бесконечной ленты и lazy-изображений; - скриншоты и PDF любой страницы;
- медиа и ссылки: изображения, аудио, видео,
srcset, внутренние и внешние ссылки, iframe, метаданные; - сырой HTML и локальные файлы через
raw:иfile://; - хуки на каждом шаге обхода;
- кэширование повторных загрузок;
arun_many— много URL разом с адаптивным по памяти диспетчером.
Docker-сервер и REST API
Если библиотека не подходит (например, нужен общий сервис для нескольких агентов), есть готовый образ. По умолчанию всё закрыто: без токена сервер отвечает только внутри своего контейнера.
export CRAWL4AI_API_TOKEN="$(openssl rand -hex 32)"
docker run -d -p 11235:11235 --name crawl4ai --shm-size=1g \
  -e CRAWL4AI_API_TOKEN="$CRAWL4AI_API_TOKEN" \
  unclecode/crawl4ai:latest
curl -s http://localhost:11235/md \
-H "Authorization: Bearer $CRAWL4AI_API_TOKEN" \
-H "Content-Type: application/json" \
-d '{"url": "https://news.ycombinator.com"}' | jq -r .markdownЭндпоинты: /md, /html, /crawl, /crawl/stream, /screenshot, /pdf, /execute_js. Плюс дашборд мониторинга на http://localhost:11235/dashboard, песочница на /playground, пул браузеров с прогретыми страницами и образы под AMD64 и ARM64.
CLI и MCP
Из коробки есть консольная утилита crwl:
# A page as Markdown
crwl https://news.ycombinator.com -o markdown

# Deep crawl, breadth first, at most 10 pages
crwl https://docs.crawl4ai.com --deep-crawl bfs --max-pages 10

# Ask a question about a page (needs an LLM key: crwl config)
crwl https://www.example.com/products -q S0
К серверу или к облаку подключается MCP — одна строка в конфиге агента:
claude mcp add --transport http crawl4ai https://api.crawl4ai.com/mcp \
  --header "Authorization: Bearer $CRAWL4AI_KEY"
Так же подключаются Codex, Cursor и OpenCode. Для облака доступны /search (поиск без браузера, с ранжированием и очисткой), /answer (прямой ответ на вопрос, пока экспериментально) и /extract (извлечение без собственного LLM-ключа).
Лицензия и атрибуция
Apache 2.0. Атрибуция не обязательна по лицензии, но автор просит её указывать — бейджем в README или одной строкой в документации:
This project uses Crawl4AI (https://github.com/unclecode/crawl4ai) for web data extraction.Документация по библиотеке и API-справочник лежат на docs.crawl4ai.com, примеры — в каталоге docs/examples, планы развития — в ROADMAP.md, текст лицензии — в LICENSE. Актуальная версия на момент публикации — v0.9.4.
Источник: https://github.com/unclecode/crawl4ai