Unsloth: десктоп-приложение для запуска и обучения LLM
📂 Исходный код на GitHubДесктоп-приложение для запуска и обучения LLM и диффузных моделей. Поддержка GGUF, MLX, Qwen3.8, DeepSeek-V4, MiniMax-H3, Gemma 4, FLUX и других моделей.
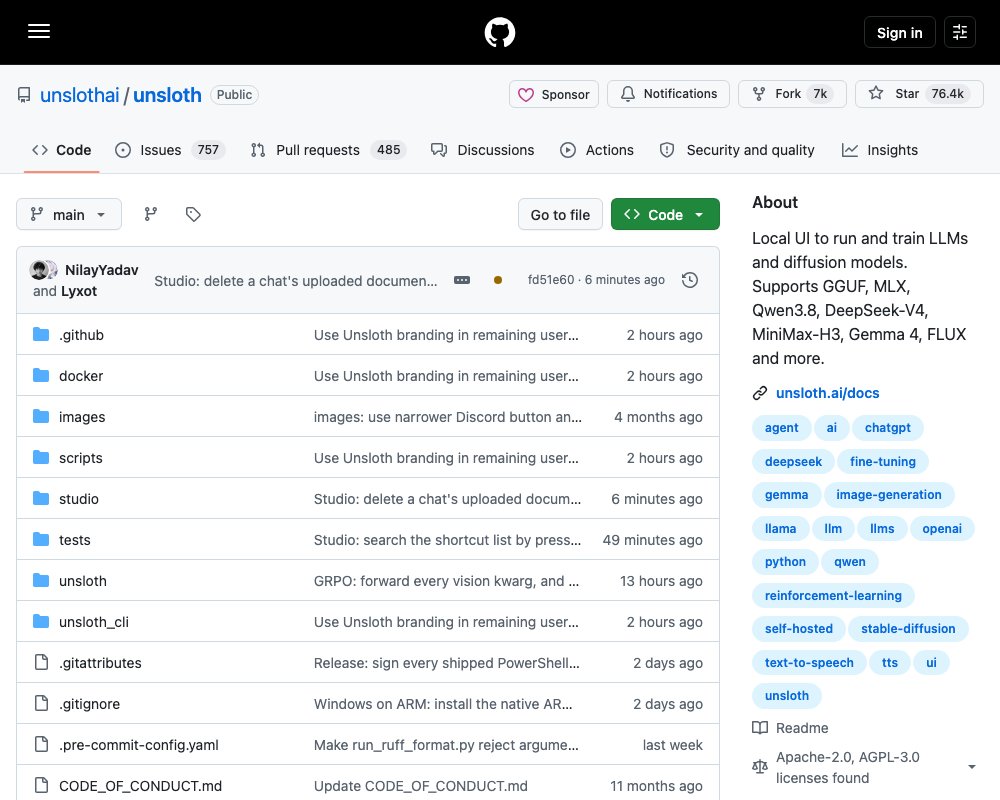
Unsloth — первое десктоп-приложение для запуска и обучения локальных LLM, диффузных и аудио моделей. Поддерживает Windows, Linux, WSL и macOS, включая Multi-GPU, NVIDIA, AMD, Intel, CPU и Vulkan. 76k звёзд на GitHub.
Установка
Нативные десктоп-приложения доступны для скачивания:
Ручная установка через терминал:
# macOS, Linux, WSL
curl -fsSL https://unsloth.ai/install.sh | sh

# Windows (PowerShell)
irm https://unsloth.ai/install.ps1 | iex
Unsloth Studio (web UI) запускается командой unsloth studio. Docker-образ unsloth/unsloth доступен на Docker Hub.
Возможности
Запуск моделей
Unsloth запускает LLM, MLX, GGUF, диффузные, embedding и аудио модели: Qwen3.8, GLM-5.3-Flash, Kimi K3, MiniMax-H3, DeepSeek-V4, Gemma 4 и другие.
Интеграция с агентами: unsloth start подключает локальные модели к Claude Code, Codex, OpenCode, DeepSeek Harness, Hermes Agent и OpenClaw через совместимые с OpenAI и Anthropic API.
unsloth start claude --model unsloth/Qwen3.8-27B-GGUF:UD-Q4_K_XLSearch & RAG: приватный неограниченный веб-поиск, deep research, auto-compaction (скользящее контекстное окно) и RAG.
Изображения и видео: запуск и обучение диффузных и мультимодальных моделей.
Удалённый доступ: модели доступны по LAN или через безопасный Cloudflare HTTPS.
Обучение
Fine-tuning LLM, диффузных, TTS и embedding моделей в 2 раза быстрее с тратой VRAM на 70% меньше без потери точности. Поддержка RL, LoRA, QLoRA, full fine tuning, pretraining, GRPO, DPO и FP8.
Экспорт моделей в форматы GGUF, NVFP4, FP8 и другие. Построение датасетов из PDF, CSV, DOCX и других форматов через Data Recipes.
Бесплатные ноутбуки
Unsloth предоставляет ноутбуки для Google Colab и Kaggle:
| Модель | Ускорение | Экономия VRAM |
|---|---|---|
| Gemma 4 (E2B) | 1.5x | 50% |
| Qwen3.5 (4B) | 1.5x | 60% |
| gpt-oss (20B) | 2x | 70% |
| Qwen3: GRPO | 2x | 70% |
| Llama 3.1 (8B) Alpaca | 2x | 70% |
| Orpheus-TTS (3B) | 1.5x | 50% |
Unsloth Start
Команда unsloth start за одну строку подключает локальные модели к coding-агентам:
| Агент | Команда |
|---|---|
| Claude Code | unsloth start claude |
| OpenAI Codex | unsloth start codex |
| DeepSeek Harness | unsloth start dsh |
| Hermes Agent | unsloth start hermes |
| OpenCode | unsloth start opencode |
| OpenClaw | unsloth start openclaw |
Дополнительные возможности
- Connections: комбинация локальных моделей с API-провайдерами (OpenAI, Anthropic) или серверами (vLLM, Ollama) в одном интерфейсе.
- MoE-модели: обучение MoE LLM в 12 раз быстрее с тратой VRAM на 35% меньше — DeepSeek, GLM, Qwen и gpt-oss.
- Длинный контекст: 7x длиннее RL-контекст, 500K+ контекст на 80GB GPU.
- FP8 и Vision RL: FP8 и VLM GRPO на consumer GPU.
- Vulkan: принудительный выбор бэкенда через
UNSLOTH_LLAMA_CPP_BACKEND=vulkan.
Лицензия
Двойная лицензия: Apache 2.0 для ядра Unsloth, AGPL-3.0 для Unsloth Studio UI.
Источник: https://github.com/unslothai/unsloth