

nd-video-studio — видео из HTML с диктором, музыкой и сведением
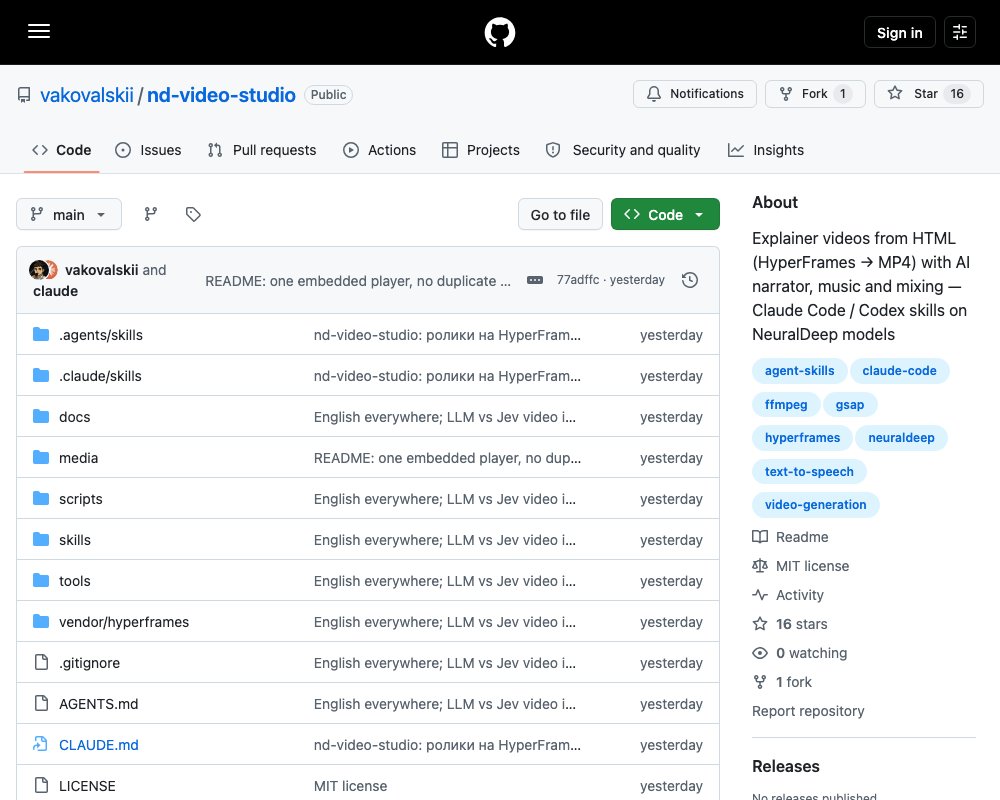
📂 Исходный код на GitHubВидеостудия для агентов: HTML-композиция рендерится в MP4 через HyperFrames, а вокруг неё собираются закадровый голос, музыка и финальный микс. Внутри два скилла для Claude Code и Codex, 17 Python-скриптов и локальная студия музыки на своём ACE-Step. Лицензия MIT.
nd-video-studio — видео из HTML с диктором, музыкой и сведением
nd-video-studio — небольшая видеостудия для агентов. Она берёт HTML-композицию, прогоняет её через HyperFrames и получает MP4. Вокруг ролика собирается закадровый голос, музыка и финальный микс. Всё это делают Python-скрипты, которые запускает Claude Code или Codex по инструкции из скилла. Лицензия — MIT, язык — Python.
Идея в том, чтобы не учить агента пользоваться видеоредактором. Композиция — это обычная HTML-страница. Агент уже умеет её писать. Остаётся добавить к ней тайминги, звук и правила анимации, а потом отрендерить.
Что лежит в репозитории
Репозиторий создан в сентябре 2026 года, у него 16 звёзд. Основное содержимое — два скилла и папка scripts/ с семнадцатью Python-скриптами и двумя shell-скриптами.
| путь | что делает |
|---|---|
skills/nd-video/ |
скилл «от идеи до MP4»: приёмы HyperFrames, голос, музыка, сведение |
skills/ndt-content/ |
скилл «видео из брифа целиком на моделях NeuralDeep» |
scripts/nd_probe.py |
проверяет, что все модели и адреса API пайплайна отвечают |
scripts/nd_research.py |
поиск через Search API, результат пишется в sources.md |
scripts/nd_script.py |
пишет сценарий по брифу, на выходе narration.json со сценами |
scripts/nd_retime.py |
расставляет начала реплик по настоящей длине озвучки |
scripts/nd_align.py |
сверяет озвучку с текстом через whisper-1, даёт тайминги слов |
scripts/nd_images.py |
картинки через FLUX, удаление фона, увеличение |
scripts/nd_review.py |
визуальная проверка кадров моделью с картинками |
scripts/music_studio.py + tools/music-studio.html |
локальная студия музыки поверх своего ACE-Step |
scripts/beat_map.py + tools/beat-sync.js |
карта битов трека и привязка анимации к ней |
scripts/tts_gpt_audio.py |
голос через gpt-audio от OpenAI (OpenRouter) |
scripts/tts_hub.py |
голос через TTS NeuralDeep |
scripts/music_lyria.py |
музыка через Google Lyria 3 (OpenRouter) |
scripts/music_acestep.py |
музыка через свой ACE-Step 1.5 |
scripts/fit_narration.py |
вписывает реплики в отведённое время |
scripts/voice_fx.py |
эквалайзер, компрессор, реверберация и пресеты |
scripts/mix.py |
сведение голоса и музыки с приглушением музыки |
scripts/build_audio.sh |
три предыдущих шага одной командой |
vendor/hyperframes/ |
частичная копия скиллов HyperFrames вместе с их лицензией |
Оба скилла лежат ещё и в .claude/skills/ и .agents/skills/, поэтому Claude Code и Codex подхватывают их сами.
Порядок работы
Первое, что стоит понять про этот пайплайн: голос идёт раньше вёрстки. Скорость речи нельзя угадать по тексту. Автор пишет, что голос ryan на сервисе NeuralDeep звучит со скоростью примерно 1,7 слова в секунду, а черновик сценария рассчитан на 2,1. Поэтому:
- Бриф и раскадровка. Одна мысль на сцену. У сцены заголовок в виде вопроса, 2–4 реплики диктора и ключевая идея в конце. Автор отдельно отмечает: без субтитров и без карты переходов зритель не понимает, что смотрит.
- Сценарий.
nd_research.pyсобирает выдержки из поиска вsources.md,nd_script.pyпишет по нимnarration.json. Факты в сценарии потом правят руками. - Голос.
tts_hub.pyкладёт wav-файлы вaudio/raw/line_NN.wav. - Пересчёт таймингов.
nd_retime.pyпереписывает начала реплик по реальной длине файлов. Дальше верстать HTML. - Сверка.
nd_align.pyрасшифровывает озвучку и сравнивает с текстом. TTS иногда глотает и путает слова: в демо «reuse» превратилось в «ray use». На слух это почти не слышно, скрипт это ловит и просит переозвучить конкретную реплику. Заодно он даётwords.jsonс таймингами слов — по нему в HTML подсвечивается каждое слово в момент произнесения. - Картинки и композиция.
nd_images.pyгенерирует изображения, агент собираетindex.htmlиз сцен, субтитров и подсветки слов. - Проверка кадров.
npx hyperframes check, потомsnapshot --at t1,t2,...и взгляд на лист контактов.nd_review.pyделает то же самое моделью с картинками: она ловит мелкий текст, наложения и пустые кадры, но путает метки времени, поэтому это второй взгляд, а не замена своим глазам. - Звук.
bash build_audio.sh . trailer. - Рендер.
npx hyperframes render --output renders/<name>.mp4.
Голос
Два источника. tts_hub.py берёт Qwen3-TTS на сервисе NeuralDeep: восемь голосов, стиль задаётся обычным текстом, скорость — отдельным параметром. Для русского языка используется ESpeech с RUAccent. tts_gpt_audio.py ходит в openai/gpt-audio через OpenRouter, и автор считает, что он звучит лучше.
У gpt-audio есть особенность: модель отвечает как ассистент («Understood, here is…») и может вслух прочитать служебные теги вроде <line>. Поэтому скрипт задаёт системный промпт «you are a TTS engine», отправляет голый текст, а потом расшифровывает результат, сравнивает с исходником и повторяет попытку.
Дальше реплики нужно вписать в отведённое время. fit_narration.py срезает тишину по краям, а слишком длинные реплики ускоряет через atempo — тембр при этом сохраняется. Больше ×1,12 слышно уже отчётливо, и скрипт помечает такую строку как TOO LONG: нужно сократить текст и переозвучить только её.
Обработка голоса лежит в voice_fx.py. Там шесть пресетов:
| пресет | что делает |
|---|---|
natural |
ничего не делает |
trailer |
бас +5 дБ на 110 Гц, верх +2,5 дБ на 3 кГц, компрессия 4:1, хвост реверберации 1,4 с на 18% |
deep |
тон на 2 полутона ниже |
titan |
тон на 4 полутона ниже |
cathedral |
хвост реверберации 3,2 с на 45% |
radio |
полоса 350–3400 Гц |
Пресеты намеренно сделаны очень разными. Автор пробовал делать их похожими и обнаружил, что после нормализации громкости мелкие правки почти не слышны. Сравнить варианты можно на слух: voice_fx.py fit ab --compare 0.
Музыка и сведение
Музыку можно взять двумя способами. Lyria 3 через OpenRouter стоит 0,08 доллара за трек и 0,04 за 30-секундный фрагмент. Google не любит промпты, где упоминаются AI, видео или продукт: такой запрос возвращает PROHIBITED_CONTENT и деньги не списывает. В промпте описывают только музыку — жанр, темп, инструменты, настроение, «No vocals».
Второй путь — свой ACE-Step 1.5 под лицензией MIT. Подробности разбора в docs/acestep.md. Коротко: вариант XL — это 4 млрд параметров, около 9 ГБ в bf16. Нужно от 12 ГБ видеопамяти с выгрузкой на CPU и квантизацией, либо от 20 ГБ без них. В качестве опорной конфигурации автор приводит одну RTX A4500 20 ГБ: XL вместе с языковой моделью занимает 16,6 ГБ, трек на 60 секунд с размышлениями делается за 78 секунд, два варианта по 60 секунд без размышлений — за 11 секунд. Просить больше двух вариантов сразу нельзя: карта кончается.
Сервер слушает только 127.0.0.1, поэтому к нему идут через ssh-туннель. Управлять им удобно из локальной студии: python3 scripts/music_studio.py поднимает страницу на http://127.0.0.1:8765 с пресетами, историей и кнопкой, которая кладёт трек в проект.
Сведение — mix.py. Голос приводится к −16 LUFS, музыка садится на −27 LUFS и приглушается под голосом боковым компрессором. Трек обрезается по длине ролика, с затуханием 1,5 с в начале и 4 с в конце. Отдельно автор предупреждает: loudnorm внутри пересэмплирует звук в 192 кГц и съедает хвост, поэтому после него обязательно идут aresample и apad.
Синхронизация с битами
Отдельная идея, пришедшая из ролика vibecoder-anthem: монтажные склейки и движения камеры должны попадать в настоящие биты трека, а не в сетку темпа.
beat_map.py разбирает трек через librosa и собирает beats.json с битами, сильными долями и акцентами. Дальше beat-sync.js даёт агенту четыре функции: притянуть примерное время к ближайшему биту, найти следующий бит или следующую долю, собрать акценты в окне и перенести готовую анимацию на другую версию трека.
Две детали, на которые стоит посмотреть. Первая: определитель темпа ошибается на октаву. Трек для ролика про Jev автор просил на 110, а получил 73,8 — это 147,6, поделённое на два. Вторая: сгенерированная музыка темп держит плохо, а ACE-Step держит. Drum and bass на 174 получился 172,3 BPM с разбросом ±5 мс.
Требования и ключи
Нужен Node 22+, FFmpeg и Python 3.10+. Скрипты используют только стандартную библиотеку Python. Рендер идёт через npx hyperframes@0.8.81 — версия зафиксирована в каждом проекте.
Ключи три. ND_API_KEY — доступ к моделям NeuralDeep, работает отовсюду. OPENROUTER_API_KEY — для gpt-audio и Lyria; OpenRouter отдаёт 403 на российских адресах, так что нужен сервер за границей или свой прокси. ACESTEP_API_KEY — если сервер с музыкой закрыт ключом. Всё это лежит в .env, который добавлен в .gitignore.
Что стоит за этим
Репозиторий честно небольшой и свежий. Но в нём собраны грабли, на которые обычно наступают при автоматической сборке видео: как заставить TTS не читать служебные теги, как поймать проглоченное слово, почему сначала голос, а потом вёрстка, почему после loudnorm нужно чинить длину, и почему пресеты обработки голоса должны отличаться сильно, а не на пару децибел.
Есть и правило честности, прописанное прямо в скиллах: если в ролике разбирается чужая модель, на экране нужно отмечать, что подтверждено источником, а что является оценкой. И в посте о видео надо честно перечислить, что именно использовалось — если на одном шаге музыка пришла из Lyria, писать «сделано целиком на моделях NeuralDeep» нельзя.