

MicroLLM lab: маленькие языковые модели в браузере на WebGPU
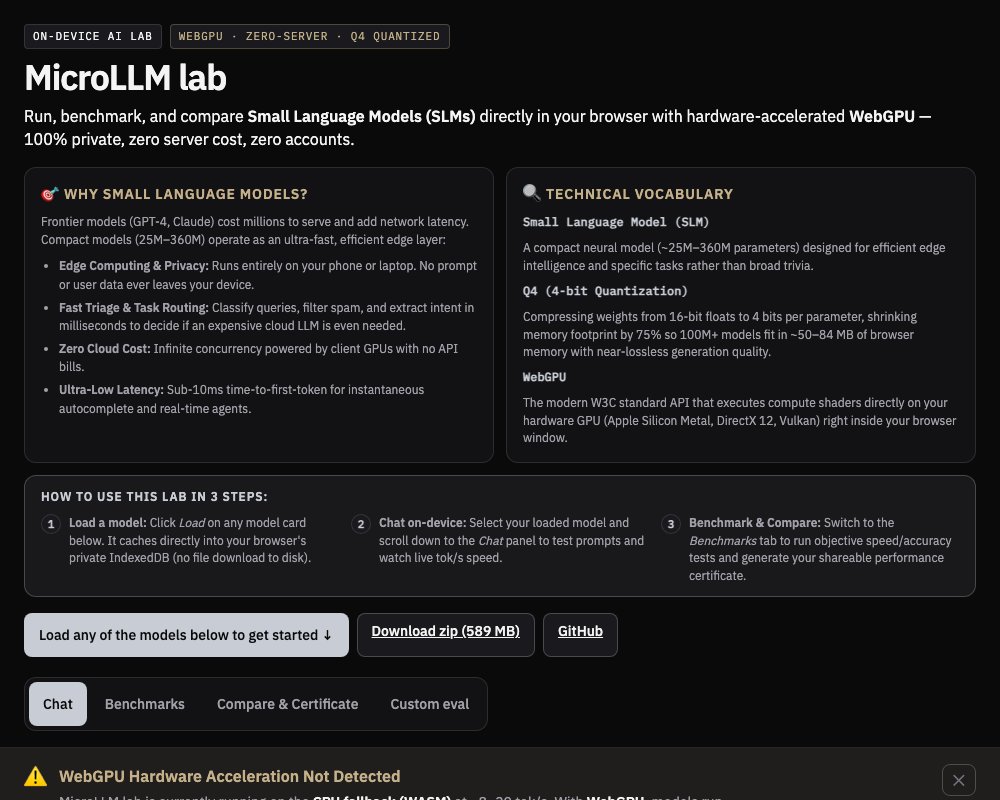
MicroLLM lab — это эксперимент с сайта stateofutopia.com, где языковые модели размером от 26 до 362 миллионов параметров запускаются прямо во вкладке браузера. Никаких API-ключей, никакого Python, никакой установки CUDA. Модели работают через WebGPU прямо на вашей видеокарте, а веса лежат в локальном хранилище браузера (IndexedDB) и никогда не уходят на сервер.
Ссылка на инструмент: https://stateofutopia.com/experiments/microllmlab/
Исходный код: https://github.com/robss2020/microllm-lab
Логика проекта простая и местами спорная: облачные модели лучше, и авторы это признают. Ценность эксперимента в том, что он даёт пощупать компромисс между скоростью и качеством маленьких моделей в тех же браузерах, где живут ваши пользователи.
Что такое маленькие языковые модели
Маленькая языковая модель (SLM) — это компактная нейросеть, обычно от 25 до 360 миллионов параметров. Она не пытается отвечать на любой вопрос, а заточена под конкретные задачи и работает быстро на обычном железе.
Авторы перечисляют четыре причины, по которым такая модель вообще имеет смысл:
- Приватность по умолчанию. Промпт не покидает устройство. Это удобно для черновиков, медицинских заметок и всего, что не хочется отправлять в лог чужого сервиса.
- Экономия задержки. Первый токен приходит локально: нет очереди, нет холодного старта, нет сообщения «превышен лимит запросов».
- Нулевая цена после скачивания. Файл на 80 МБ обходится дешевле одного рабочего дня API-запросов, причём работает даже в самолёте.
- Очень быстрый первый отклик. Заявленная задержка до первого токена — меньше 10 мс.
Как устроен запуск: WebGPU и сжатие Q4
Веса модели сначала переводят в 4-битный формат (Q4). Числа типа float16 занимают 16 бит на параметр, в Q4 — 4 бита. Дополнительно модель разбивается на группы по 32 веса. Экономия памяти получается примерно четырёхкратная: модели в сто с лишним миллионов параметров помещаются в 50–84 МБ оперативной памяти браузера, а качество генерации почти не падает.
Дальше за дело берётся WebGPU. Это стандарт консорциума W3C, который даёт браузеру прямой доступ к вычислениям на GPU: Metal на Apple Silicon, DirectX 12 на Windows, Vulkan на Linux. Вместо того чтобы отправлять вычисления в облако, браузер выполняет их на вашей видеокарте.
Веса не скачиваются в виде обычного файла на диск. Они сразу попадают в приватное хранилище IndexedDB, которое браузер не показывает в списке загрузок. На каждой карточке модели видно, лежит ли она уже на этом устройстве.
Если WebGPU недоступен, движок постепенно переходит на резервные варианты: сначала WASM, потом обычный JavaScript. Скорость при этом заметно падает, но чат продолжает работать.
Какие модели лежат в лаборатории
В наборе восемь моделей, все под свободными лицензиями (Apache-2.0, кроме GPT-2 — MIT) и все уже сжаты в Q4.
| Модель | Параметры | Размер Q4 | Лицензия | Автор |
|---|---|---|---|---|
| PetitGPT research-v1 | 124.6M | 74 МБ | Apache-2.0 | yangqi0 |
| SmolLM2 135M Instruct | 134.5M | 80 МБ | Apache-2.0 | Hugging Face Smol Models Research |
| SmolLM 135M Instruct | 134.5M | 80 МБ | Apache-2.0 | Hugging Face Smol Models Research |
| L20-Edu 135M | 134.5M | 80 МБ | Apache-2.0 | AliceYin |
| SmolLM2 360M Instruct | 362M | 216 МБ | Apache-2.0 | Hugging Face Smol Models Research |
| MiniMind2 104M | 104M | 62 МБ | Apache-2.0 | jingyaogong |
| MiniMind2 Small 26M | 26M | 15 МБ | Apache-2.0 | jingyaogong |
| GPT-2 124M | 124M | 77 МБ | MIT | OpenAI |
Несколько моделей стоит разобрать подробнее.
PetitGPT — исследовательский проект, который автор этой лаборатории перенёс в браузер. Модель на 124.6 миллиона параметров обучалась на одной RTX 4090 примерно на 13 миллиардах токенов. Это decoder-трансформер в стиле Llama: пред-нормализация через RMSNorm, групповое внимание, RoPE, SwiGLU, связанные embedding. Обычно она самая быстрая в наборе и служит точкой отсчёта для остальных.
SmolLM2 135M Instruct — второе поколение компактной линейки Hugging Face, 2025 год. Модель предобучена примерно на 2 триллионах токенов, а затем дообучена на инструкциях. Архитектура такая же, как у PetitGPT (30 слоёв, ширина 576, 576 голов внимания), поэтому сравнение честное. Медленнее из-за большего словаря и префикса ChatML, но на объективных тестах заметно точнее.
SmolLM 135M — первое поколение той же линейки, 2024 год, предобучено примерно на 600 миллиардах токенов. Тот же размер, что у SmolLM2. Полезен, чтобы увидеть, что даёт год работы над данными и рецептом обучения.
L20-Edu 135M — учебная модель от AliceYin, обученная на одной NVIDIA L20 примерно на 13 миллиардах токенов. Та же архитектура, но заметно меньше вычислений на обучение, так что ответы будут слабее. Смысл в другом: это проверяемый пример того, что вообще можно получить на одной видеокарте.
SmolLM2 360M Instruct — старший собрат в той же линейке: 32 слоя, ширина 960. Медленнее грузится и считает, но на тестах обычно точнее.
MiniMind2 — учебный проект с нуля: цель — обучить крошечную LLM на одной бытовой видеокарте, с открытым кодом и документацией на китайском. Экспорт в стиле Llama: 16 слоёв, ширина 768, 6.4 тысячи токенов в словаре, ChatML. По-китайски модель заметно сильнее, чем по-английски. Версия на 26 миллионов параметров (8 слоёв, ширина 512) качается и работает быстрее всех, но английский у неё короткий и неуверенный.
GPT-2 124M — классика февраля 2019 года, Architecture от Alec Radford и коллег, позже перевыпущенная под MIT. Двенадцать слоёв, LayerNorm, GELU, обучаемые абсолютные позиции, словарь на 50 тысяч BPE-токенов. Это модель дополнения текста, а не чат. При жадной расшифровке она часто зацикливается — и это свойство самой модели, а не ошибка расшифровщика.
Как пользоваться: три шага
- Загрузите модель. Нажмите Load на любой карточке. Веса попадут в приватное хранилище IndexedDB браузера, файл на диск не скачивается.
- Поговорите с моделью. Выберите загруженную модель и откройте панель чата — там видно скорость в токенах в секунду.
- Прогоните тесты. На вкладке Benchmarks можно измерить скорость и точность, а потом сгенерировать сертификат с результатами, которым можно поделиться.
Вкладка Compare показывает графики по последнему прогону для каждой модели: долю пройденных тестов, среднюю скорость и общее время прогона. На графиках используется Chart.js, он лежит в комплекте, чтобы архив работал без интернета.
Для тех, кто хочет свои тесты, есть редактор: код на JavaScript выполняется прямо на этой странице, а каждый check выполняется на тексте, который сгенерировала модель. Отдельная кнопка собирает готовый промпт, чтобы отдать его более крупной LLM.
Что именно измеряется
Тесты в лаборатории объективные: регулярные выражения и точное совпадение токенов. Качество текста они не оценивают. Это сделано намеренно — если модель на 135 миллионов параметров проваливает арифметику, это и есть результат измерения, а не ошибка теста.
Замеряются две величины: скорость (токенов в секунду при непрерывной генерации, общее время прогона) и точность (доля пройденных объективных тестов). Есть отдельный тест на устойчивую скорость — 256 токенов подряд. Перед запуском интерфейс оценивает время по вашей последней измеренной скорости.
Что получилось на Apple M4
Замеры на Apple M4 (Safari, Metal, Q4) при жадной расшифровке:
| Тест | PetitGPT | SmolLM2 135M Instruct |
|---|---|---|
| «Say hello…» | 87 мс · 115 ток/с | 227 мс · 66 ток/с |
| Объективный набор | 10 из 14 | 14 из 20 |
Инструктивная модель медленнее (больший словарь, префикс ChatML), но заметно точнее на простых задачах, с которыми модель на 135 миллионов параметров ещё может справиться. Общее время прогона набора на этом M4 — около 1.5 секунды для PetitGPT и около 6 секунд для SmolLM2 (20 тестов, остановка на EOS). По словам авторов, на Mac mini этого года скорость превышает сотню токенов в секунду, а GTX 1060 десятилетней давности всё ещё держит планку.
Ограничения, о которых предупреждают авторы
Эти модели галлюцинируют, и использовать их для ответов, от которых зависит что-то важное, нельзя. Контекст в этой сборке ограничен 2048 токенами — иначе KV-кэш не поместился бы в память ноутбучной видеокарты. Расшифровка только жадная: без температуры и top-k/top-p.
Запуск у себя и конвертация моделей
Страницу нельзя открывать как локальный файл file:// — модулям, воркерам и fetch нужен настоящий адрес. Локальный запуск выглядит так:
python3 -m http.server
# открыть http://127.0.0.1:8000/
Перевести в формат лаборатории можно и свою модель Hugging Face, но только из семейства в стиле Llama:
python3 -m venv .venv && .venv/bin/pip install torch transformers safetensors
.venv/bin/python tools/convert_hf_to_pgw.py HuggingFaceTB/SmolLM2-135M-Instruct models/my-model
Для моделей формы GPT-2 есть отдельный конвертер:
.venv/bin/python tools/convert_gpt2_to_pgw.py openai-community/gpt2 models/gpt2Остаётся дописать строку в models/catalog.json. Весь архив весит около 591 МБ, скачать его можно с той же страницы. Код лаборатории — Apache-2.0, у каждого файла весов остаётся лицензия автора.
Итог
MicroLLM lab — не замена облачным моделям и не попытка обойтись без них. Это честная демонстрация компромисса: вот скорость, вот цена приватности, вот точность, на которую можно рассчитывать, а вот и цена качества. Модели сознательно не прячут свои слабые места за привычным окном чата — вместо этого проект их измеряет.
Если вы делаете функциональность, которая работает на устройстве пользователя, такой инструмент позволяет почувствовать границы этого компромисса заранее, а не после релиза.