

App Landing SEO — два агентных навыка: SEO-лендинг для мобильного приложения и генерация картинок
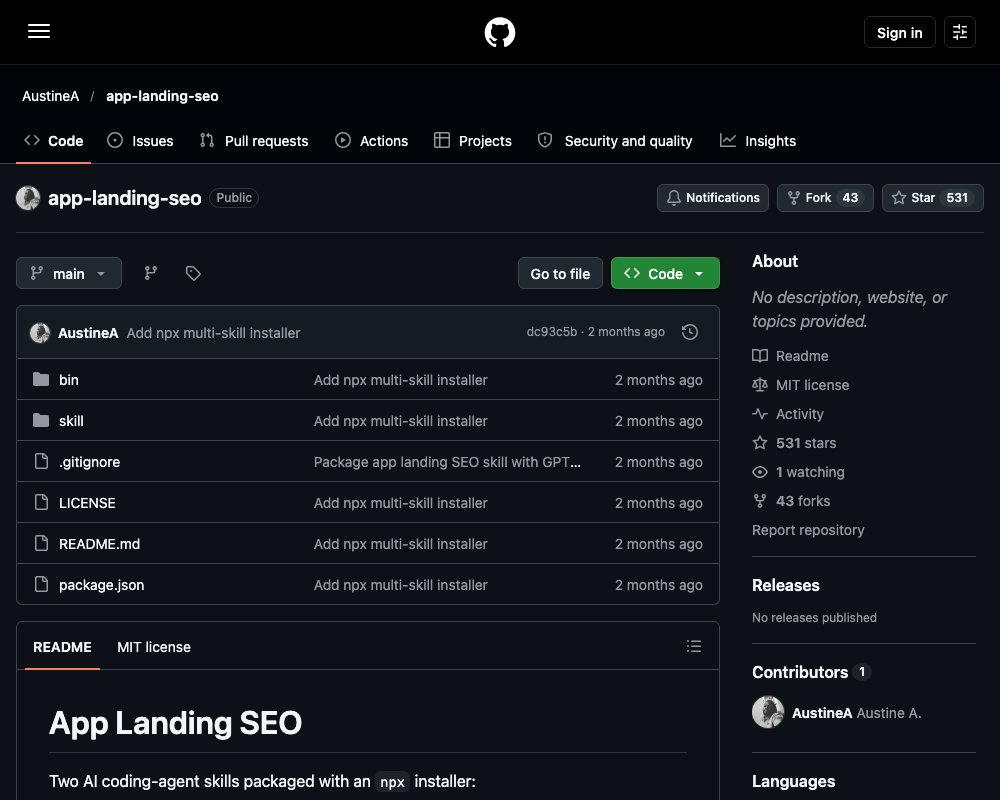
📂 Исходный код на GitHubПакет из двух агентных навыков для кодинг-агентов: app-landing-seo собирает SEO-лендинг для мобильного приложения с гайдами и разметкой Schema.org, gpt-image генерирует к нему изображения через OpenAI gpt-image-2. Установка одной командой npx, лицензия MIT.
У мобильного приложения обычно есть карточка в магазине — и почти всегда нет нормальной страницы в вебе. Поисковики не читают описание из App Store, а значит приложение просто не находят по запросам вроде «как вести учёт остатков». App Landing SEO — это набор из двух агентных навыков, который закрывает эту дыру: один собирает SEO-лендинг с гайдами под ключевые запросы, второй рисует к этим гайдам иллюстрации.
Что внутри пакета
| Навык | Что делает |
|---|---|
app-landing-seo |
Исследует карточку приложения в магазине, подбирает ключевые запросы, собирает статический лендинг, пишет гайды, добавляет разметку Schema.org и проверяет результат |
gpt-image |
Генерирует и правит растровые изображения через модель OpenAI gpt-image-2 |
Навык gpt-image лежит в том же репозитории, но умеет работать и сам по себе. Основной навык вызывает его, когда доходит до картинок для гайдов.
Установка
npx github:AustineA/app-landing-seoУстановщик копирует оба навыка в каталог ~/.agents/skills/ и делает символические ссылки в каждом найденном агенте. Список агентов фиксированный:
- Claude Code
- Codex
- Cursor
- Windsurf
- Antigravity
- Trae
- Amp
Если каталога конкретного агента нет, установщик его пропускает. Ссылка делается один раз, а не копия — обновление файлов в ~/.agents/skills/ сразу видно во всех агентах.
Дополнительные команды:
npx github:AustineA/app-landing-seo status    # что установлено и куда подключено
npx github:AustineA/app-landing-seo uninstall # убрать оба навыка и все ссылки
Сам установщик лежит в bin/install.mjs — это обычный скрипт на Node.js без зависимостей, его легко прочитать перед запуском.
Что нужно из окружения
- Node.js 18 и новее — для самого установщика
uv(предпочтительно) или Python 3 с пакетомopenai— для генерации картинокGPT_API_KEYилиOPENAI_API_KEY— ключ OpenAI- Доступ в интернет — для исследования магазина и для обращения к Images API
Список зависимостей для навыка с картинками лежит в skill/gpt-image/requirements.txt, там ровно одна строка: openai.
Как пользоваться
Откройте проект приложения или лендинга в агенте и скажите одну фразу:
SEO optimize my app landing pageДальше навык ведёт работу сам. Он разбирает карточку в магазине, выбирает ключи, пишет код, готовит тексты, добавляет разметку и в конце проверяет собранный результат.
Шесть фаз работы
Полное описание сценария лежит в skill/app-landing-seo/SKILL.md. Вот как они устроены.
Фаза 1. Данные из магазина
Агент тянет полные метаданные через публичный API iTunes — авторизация не нужна:
curl -s "https://itunes.apple.com/lookup?id=<APP_ID>&country=us"Оттуда берутся название, bundleId, описание, цена, жанры, число оценок, скриншоты, иконка, версия и продавец. Навык также проверяет карточку в Google Play — предполагать, что приложение только для iOS, не надо.
Скриншоты и иконку он скачивает в полном разрешении. Для этого достаточно поменять суффикс в ссылке: 512x512bb.jpg → 1024x1024bb.png для иконки, 392x696bb.jpg → 1284x2282bb.png для скриншотов.
Дальше агент читает каждый скриншот и описывает то, что на нём видно. Оттуда же он берёт цвета бренда и стиль шрифта. Всё это ложится в файл app.md в корне проекта: таблица идентичности, дословное описание, список функций, список файлов. Дальше по этому файлу строится вся работа.
Фаза 2. Подбор ключевых запросов
Если подключены MCP-инструменты astro, агент берёт подсказки ключей и текущую позицию приложения в App Store. Параллельно он проверяет длинные запросы через обычный поиск в вебе, потому что лендинг ранжируется в Google, а не в магазине.
Запросы делятся на три группы: 3–5 основных запросов идут в title, H1 и первый экран, дополнительные — в заголовки секций и тексты о функциях, ещё 6–10 длинных запросов — каждый получает отдельную страницу-гайд.
Правило, которое решает всё остальное: каждый длинный запрос должен отвечать на боль, которую приложение действительно закрывает. И желательно так, чтобы эта боль была видна на скриншоте. Именно это превращает трафик в загрузки.
Ещё одно правило — смотреть выдачу по каждому основному запросу и отбрасывать отравленные. По запросу «stock tracker» выдача может вернуть приложения для биржи, а не для склада.
Фаза 3. Сборка лендинга
По умолчанию стек — Vite и React со статической генерацией на этапе сборки. Обычная SPA без рендеринга на сервере для поисковиков почти пустая, поэтому на выходе нужен готовый HTML.
Примерно тридцать строк скрипта генерации решают задачу, и клиентский JavaScript на сайт не попадает: аккордеон FAQ работает на нативном <details>.
landing/
  package.json          # build: vite build --ssr ... && node scripts/prerender.mjs
  vite.config.ts        # plugins: [react()], ssr: { noExternal: true }
  index.html            # только для разработки: <div id="root"> + /src/entry-client.tsx
  public/               # style.css, assets/
  src/
    data.ts             # весь текст: FAQ, тела гайдов, заголовки, описания
    seo.ts              # тип PageMeta и сборщики JSON-LD
    components.tsx      # Header, Footer, StoreBadge, FaqItem, GuideCard, CtaCallout
    pages/              # Home.tsx, GuidePage.tsx, GuidesIndex.tsx
    routes.tsx          # ROUTES: по записи на страницу, гайды собираются из data.ts
    entry-server.tsx    # renderRoute(route): полный документ — head, JSON-LD, тело
    entry-client.tsx    # только для разработки
  scripts/prerender.mjs # пишет dist/<path>/index.html + sitemap.xml + robots.txt
Ключевые решения внутри этой схемы:
renderToStaticMarkup, а неrenderToString— в HTML не остаётся служебных меток гидратации, а она и не нужна- Пути заканчиваются на
/, скрипт пишет<путь>/index.html, внутренние ссылки абсолютные от корня сайта - На проде отдаётся только статика, клиентский вход остаётся для dev-сервера
- Атрибут в React называется
fetchPriority, строчными буквами он ругается предупреждением
Требования к странице:
| Элемент | Правило |
|---|---|
| H1 | Ровно один, с главным ключевым запросом |
title |
До 60 символов, формат «Бренд — ключевой запрос для аудитории» |
| Meta description | До 155 символов, ключ плюс отличия |
| JSON-LD | SoftwareApplication (с offers и installUrl), FAQPage, WebSite |
| Скриншоты | В alt — что реально на экране; вес до 200 КБ после сжатия |
| FAQ | 8–10 вопросов, каждый — реальный поисковый запрос, ответ в 2–3 предложения |
Объекты разметки собираются в seo.ts из data.ts. Благодаря этому текст, который видит человек, и текст, который читает поисковик, всегда совпадают: массив FAQPage и видимый FAQ берутся из одного места.
Фаза 4. Страницы-гайды
На каждый длинный запрос — одна страница. Все гайды описаны как структура данных, а не как готовый HTML:
{ slug, title, description, h1, intro, featureImage: { src, alt, width, height },
  howto?, sections: [{ h2, paras, cta?, figure? }], faq, related }
Из этой структуры получается всё остальное: карточка, блок призыва к действию, ссылки в подвале, запись в sitemap.xml и разметка.
Адрес страницы совпадает с ключевым запросом: /guides/how-to-keep-track-of-inventory-small-business. Первый абзац сразу отвечает на вопрос — это приманка для быстрого ответа в выдаче. Дальше идёт обучение задаче, а приложение упоминается как инструмент. Сначала учим, потом продаём.
Заголовки H2 держат вторичные формулировки того же запроса. Объём — 600–900 слов по делу. На странице нужны скриншот приложения с подписью, призыв к действию в середине и свой FAQ из двух вопросов, которого нет на главной. Разметка — Article, BreadcrumbList, FAQPage, а для пошаговых гайдов ещё и HowTo.
Картинки для гайдов навык не подменяет: ни стоковыми снимками, ни градиентами, ни другими моделями. Он вызывает навык gpt-image, который работает через OpenAI gpt-image-2. Полный сценарий — в skill/gpt-image/SKILL.md, сам генератор лежит в skill/gpt-image/scripts/generate_image.py.
Каждый промпт для картинки заканчивается запретом на любой текст:
Landscape editorial feature image, 3:2 composition. Absolutely no text, words,
letters, numbers, captions, watermarks, interface labels, or logos.
Параметры вызова:
"$GPT_IMAGE_SKILL_DIR/scripts/generate_image.py" "<промпт под гайд>" \
  --model gpt-image-2 \
  --aspect-ratio 3:2 \
  --quality high \
  --background opaque \
  --format webp \
  --output "<каталог сайта>/assets/guides/<slug>-feature.webp"
На выходе картинка 1536×1024. Дальше навык открывает её в полном размере и проверяет: нет ли лишних букв, не поехали ли объекты, не появился ли чужой логотип, не срезается ли кадр на карточке. Если что-то не так, промпт меняют и картинку генерируют заново. Больше двух попыток на один гайд не делают.
У gpt-image есть параметры и для других задач: --sprite для игровых ассетов на прозрачном фоне, --reference для правки по образцу, форматы png, jpeg, webp.
Фаза 5. Чистка текста от ИИ-мусора
Отдельная фаза проходит по всему написанному тексту. Навык смотрит на признаки машинного текста в порядке заметности:
- Длинное тире — главный признак. На весь сайт допустимо несколько штук, не по одной на абзац
- Отрицательные параллелизмы: «не X, а Y». Максимум один на сайт
- Правило тройки: «без A, без B, без C». Разбивать на пары или на обычный список
- Одинаковые зачины у всех страниц
- Ровный ритм коротких фраз подряд
- Словарь запрещённых слов: delve, tapestry, robust, seamless, effortless, leverage, elevate, showcase, streamline и подобные
- Обороты «выступает как», «служит как» там, где хватает «является»
- Причастные обороты в конце фразы: «подчёркивая», «отражая», «выделяя»
Проверка делается скриптом, а не на глаз:
grep -o "—" <файлы> | wc -l
grep -inE "delve|tapestry|testament|pivotal|crucial|vibrant|seamless|effortless|leverage|elevate|robust|meticulous|showcas|foster|transformativ|game.chang|revolutioniz|empower|streamlin" <файлы>
При этом слоги, заголовки, внутренние ссылки и разметку трогать нельзя. Если текст изменился, разметку пересобирают из изменённого источника, чтобы она не разошлась с видимым текстом.
Фаза 6. Проверка
Сборка npm run build должна пройти. После этого навык разбирает собранные файлы dist/**/index.html скриптом и проверяет:
- ровно один H1 на страницу
- присутствует canonical
- каждый блок
<script type="application/ld+json">разбирается - каждая внутренняя ссылка и картинка ведёт на существующий файл
- каждая запись в
sitemap.xmlсоответствует реальному файлу - видимые вопросы FAQ на главной совпадают с
nameвFAQPage
Дальше — отдельные проверки картинок и локальный запуск dist/ через python3 -m http.server. Проверять через file:// нельзя: на таких адресах ломаются абсолютные ссылки, а чистые адреса страниц на них не работают.
Отдельно навык просит сделать скриншоты в headless Chrome на широком и узком экране и посмотреть на них. В репозитории записаны три известные ловушки:
- Chrome в headless ограничивает ширину окна примерно 500 пикселями, поэтому съёмка с
--window-size=390даст обрезанную вёрстку, а не мобильную версию - префлайт Tailwind убирает маркеры у
olиul, их нужно вернуть в стилях статьи - SVG-логотипы без
viewBoxпри изменении размера кадрируются, а не масштабируются
После выкладки навык напоминает отправить sitemap.xml в Google Search Console.
Бонус: ASO
Пока данные из магазина свежие, навык просит записать в app.md заметки по продвижению внутри самих магазинов: где в подзаголовке есть свободные ключи, какие слова ещё не заняты, и что мешает оценкам. Отдельный совет — просить пользователя оставить оценку в момент, когда он уже получил пользу, а не во время первого запуска. iOS разрешает около трёх таких просьб в год, и тратить их до первого результата не стоит.
Лицензия
MIT, файл лежит в LICENSE. Код на JavaScript, зависимостей нет.