

Kimi K3 на чистом C: 2.78 триллиона параметров в 8 ГБ RAM без GPU
📂 Исходный код на GitHubДвижок инференса Kimi K3 (2.78 триллиона параметров) на одном CPU в 8.24 ГБ RAM. Портативный C99: без BLAS, без фреймворка, без GPU — весь движок весит 176 КБ.
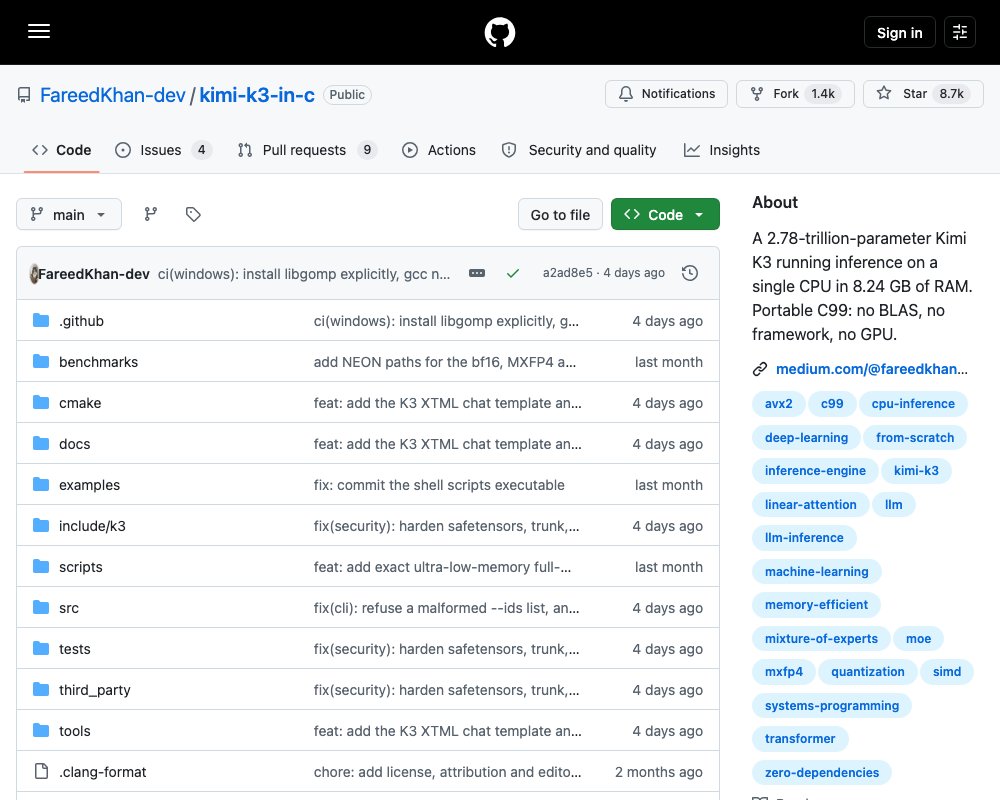
Запустить Kimi K3 — модель на 2.78 триллиона параметров весом 1.56 терабайта — на обычном процессоре, без единой видеокарты, в 8.24 ГБ оперативной памяти. Именно это и делает репозиторий kimi-k3-in-c: портативный инференс-движок на C99, шесть файлов исходников, ни BLAS, ни PyTorch, ни ONNX, ни GPU-библиотек. Из зависимостей остаются libm и OpenMP, а весь движок занимает 179 736 байт.
Проект не про скорость: ответ на промпт «The capital of France is» занимает там около получаса. Он про другое — модель помещается на машину, которая уже есть, и выдаёт побайтово одинаковый результат при 8 ГБ и при 224 ГБ.
Четыре сокращения вместо квантизации
Любая триллионная модель упирается не в вычисления, а в ёмкость: держать всё в bfloat16 — значит 5.56 ТБ. Дальше срабатывают четыре сокращения, и ни одно не отбрасывает ни одного веса.
| Уровень | Размер | За счёт чего |
|---|---|---|
| Все параметры в bfloat16 | 5 560 ГБ | стартовая точка |
| Чекпоинт как отгружен | 1 560 ГБ | эксперты уже приходят по 0.53125 байта на вес |
| Резидентный набор | 113.49 ГБ | роутинг: 1.45 ТБ экспертов никогда не грузятся |
| Измеренный потолок | 8.24 ГБ | стриминг плотного треунка слой за слоем |
Итог — сокращение в 675 раз относительно bfloat16-модели и в 189 раз относительно отгруженного чекпоинта. Меняется только расположение байтов, сама модель не трогается.
Ключевой ход в том, что Kimi K3 использует архитектуру mixture of experts. В модели 93 слоя, слой 0 — обычная плотная FFN, остальные 92 маршрутизируют токен и выбирают 16 экспертов из 896. Активно около 104 миллиардов параметров из 2.78 триллиона, то есть 3.7 процента; остальные 96.3 должны существовать где-то достижимом, но не обязательно в RAM.
Пере census чекпоинта:
=== shard census: what the 1.56 TB actually is ===
shards            : 96
total bytes       : 1560936091448  (1.56 TB)

--- routed experts (the part that is streamed, never resident) ---
  experts total     : 82,432   (896 routed x 92 MoE layers)
  bytes per expert  : 17,547,264  exactly
                      = 33,030,144 params x 0.53125 bytes
                      = 0.5 bytes/nibble + 1/32 byte for the shared E8M0 scale
  routed expert set : 82,432 x 17,547,264 = 1.447 TB
82 432 маршрутизируемых эксперта — 1.447 ТБ, то есть 93 процента всего чекпоинта. Всё остальное (проекции внимания, роутеры, нормы, эмбеддинги) — 7 процентов, 113.49 ГБ в bfloat16: 108.81 ГБ плотного треунка и 4.70 ГБ эмбеддингов с выходной головой.
Скрипт ./scripts/pack-trunk.sh за четыре минуты переписывает 93 плотных слоя в один файл на 109 ГБ, где слой L лежит по известному смещению и читается одним вызовом. Именно это превращает нижнюю границу памяти в регулируемую ручку.
Кодовая база
Шесть C-файлов, собираемых в один бинарник. Публичный заголовок открывается тремя инвариантами, каждый из которых — место, где правдоподобная реализация даёт модель, которая работает, выдаёт связный английский текст и при этом неверна, без падения и без NaN:
A_logиндексируется per head, а не per channel — из отгруженныхhead_dimfloat'ов осмысленны только первыеnum_heads, остальное — паддинг.- MLA использует NoPE, но 64 rope-размера всё равно существуют и кэшируются: отсутствует только вращение, а выбрасывание слотов меняет ширину головы.
- Смещение роутинга влияет только на отбор; комбинирующие веса берутся из несмещённых сигмоидных скоров.
Сборка важна не меньше кода:
CFLAGS = -O3 -std=gnu99 -Wall -Wextra -Wpointer-arith -Wshadow -Wvla \
         -march=native -fopenmp -ffp-contract=off
LDFLAGS = -lm -fopenmp
Флаг -ffp-contract=off выглядит странно. По умолчанию компилятор может слить умножение и сложение в одну FMA, что меняет округление. Но здесь скалярный путь, путь OpenMP и путь AVX2 обязаны давать бит-идентичные результаты — иначе оптимизация по скорости тихо превращается в потерю точности.
Чтение чекпоинта построено как индекс, а не как данные: 96 файлов safetensors, JSON-заголовок разбирается ручным сканом без библиотек, тензоры кладутся в хеш-таблицу с FNV-1a (имена длинные и с глубокими общими префиксами, поэтому хеш должен мешать каждый байт).
indexed 497220 tensors from 96 shards in 0.27 sПолмиллиона тензоров проиндексированы за четверть секунды, и дальше движок не читает ненужный шард: 1.56 ТБ на диске — каталог, а не рабочий набор.
Второе место, где можно незаметно получить другую модель, — конфиг: отсутствующее поле здесь ошибка, а не значение по умолчанию.
/* An absent field is an ERROR, never a default. Missing names are accumulated so
 * the message lists all of them at once. */
static int cfg_req_int(jval root, const char *key, int *out,
                       const char **missing, int *nmissing)
{
    jval v = json_get(root, key);
    if (v.type != JSON_NUM) {                 /* absent OR the wrong type */
        if (*nmissing < K3_CFG_MAXMISS) missing[(*nmissing)++] = key;
        return 0;
    }
    *out = (int)v.num;
    return 1;
}
Если ридер подставит дефолты, модель всё равно заговорит: беты SiTU получат корректные 4.0 и 25.0, поэтому ничего не выглядит подозрительно, а full_attn_layers вернётся пустым — и все 93 слоя поедут как KDA.
Пресеты и бюджеты памяти
$ ./bin/k3 --list-presets
presets (trunk / expert-cache, in GB):
  ultra          2.50 / 0.31    ~3 GB planned: streamed model tables, one state slot. Slow.
  laptop         3.00 / 1.00    8.2 GB peak RSS. The ordinary-path floor.
  desktop       16.00 / 10.00   31.9 GB peak RSS.
  workstation   60.00 / 30.00   95.5 GB peak RSS; the expert cache starts to matter here.
  server       110.00 / 13.00   ~128 GB peak RSS; 90 of 93 trunk layers pinned. Fastest.
  max          110.00 / 109.00  ~224 GB peak RSS; trunk pinned and a large expert cache.
Пресет — сокращение для двух бюджетов: --trunk-gb и --cache-gb, при смешивании побеждает более поздний флаг. Оговорка: --preset без --trunk бесполезен — без упакованного треунка движок грузит все 113.5 ГБ резидентно.
Что показали измерения
Лестница памяти от 8 до 224 ГБ замерялась в cgroup с жёстким MemoryMax и MemorySwapMax=0 — иначе превышение бюджета уходит в своп и s/token измеряет пропускную способность свопа.
| Бюджет | Закреплено слоёв | Кэш, ГБ | s/token | Пиковый RSS, ГБ |
|---|---|---|---|---|
| 8 | 0 | 0.49 | 32.69 | 8.24 |
| 32 | 11 | 10.80 | 31.44 | 31.90 |
| 64 | 27 | 23.59 | 28.60 | 63.71 |
| 128 | 60 | 49.19 | 29.40 | 128.18 |
| 192 | 90 | 77.00 | 21.32 | 191.83 |
| 224 | 90 | 108.98 | 19.21 | 223.82 |
И первым читать надо последнюю строку таблицы, которой нет: во всех двенадцати бюджетах id токенов совпали побайтово. Цена — 32.69 s/token против 19.21, то есть в 28 раз больше памяти на 1.70 раза скорости. Скачок с 8 до 64 ГБ даёт 14 процентов.
Два результата, которые стоит выделить отдельно.
LRU-кэш экспертов не работает, и это свойство модели. Семь бюджетов подряд читают ровно 25.83 ГБ на токен, пока кэш растёт с 28 до 1 344 слотов — фактор 48 при нулевом изменении объёма. Ответ в архитектуре: quantile balancing выравнивает использование экспертов по пулу, а плоское использование убивает least-recently-used кэш — горячего подмножества нет. Счётчик попаданий при этом показывает 100.00 процента рядом с настоящим resident hit rate в 0.00 процента для тех же 1 472 запросов: батч-префетч положил эксперт в арену микросекунды назад, прочитав его с диска.
Распределение памяти побеждает её объём. При фиксированных 128 ГБ отдача почти всего бюджета треунку даёт 16.80 s/token против 28.38 — ускорение в 1.69 раза одной только аллокацией. Парадокс: самая быстрая конфигурация читает 25.83 ГБ на токен с нулевым hit rate, а самая медленная — 14.46 ГБ при 44 процентах. Победитель перемещает на 79 процентов больше байт экспертов и всё равно выигрывает. Оптимизировать естественный кандидат — hit rate — значит уйти в более медленную конфигурацию. Правило простое: сначала треунк до полного закрепления, потом кэш.
Отдельно про честность измерений: три прогона одной конфигурации подряд дают разброс 33.1 процента — треть замера это шум, и это порог для любых утверждений о времени. Полосу уверенно преодолевают только два эффекта: размах лестницы в 70 процентов и trunk-first в 69 процентов. Невременные результаты от дрожания планировщика не зависят. Причина разброса найдена: два прогона с идентичными счётчиками, одинаковыми 374.99 ГБ и одинаковыми закреплёнными слоями отличаются только скоростью диска, 2 709 против 5 874 МБ/с. Диск и есть узкое место: от 40.9 до 60.6 процента стенного времени уходит на I/O.
Почему треунк не квантизуют
У треунка 108.81 ГБ в bfloat16: int8 ужал бы его вдвое, int4 — вчетверо. У движка ровно два типа весов и никакой ручки:
enum { K3_WF32 = 0, K3_WBF16 = 1 };Причина измерена. Исследование взяло 31 тензор внимания, квантизовало с симметричным per-row масштабированием: int8 стоит около 1 процента, int4 — около 17, отношение 18 держится на всех сэмплированных тензорах, а худшие строки на int4 доходят до 65 процентов. Технический отчёт модели говорит, что эксперты — MXFP4 с обучением с учётом квантизации, «тогда как все неэкспертные компоненты остаются в более высокой точности». Этот список — ровно треунк: его намеренно не квантизовали и никогда не тренировали терпеть четыре бита. Потерянные на lossless-стриминге секунды можно вернуть памятью; точность, потерянная на округлении в четыре бита, не возвращается ни при каком бюджете.
Проверка и границы
Валидация построена лестницей ворот. Сначала крошечный oracle на 13 слоях с hidden 128 и словарём 256 — тем же графом тензоров, что и у настоящей модели, но с эталоном из PyTorch, зафиксированным в репозитории. Три гейта: teacher forcing, жадный декод и инкрементальный путь с KV-кэшем и состоянием KDA.
GATE 1  teacher forcing : 32/32 positions match tf_pred
GATE 2  greedy decode   : 20/20 generated tokens match full_ids
GATE 3  incremental    : 20/20 generated tokens match full_ids

VERDICT: ENGINE MATCHES THE REFERENCE EXACTLY
Три разных пути исполнения дают одинаковые id токенов, и все точны: на дискретном argmax не существует «маленькой ошибки». Автор оговаривает, что эта строка относится к игрушечной модели, а не к чекпоинту на 2.78 Т. Дальше идёт полная конформанс-проверка: 93 слоя, 93 passed, 0 failed, 5 639 секунд. Построчный forward из независимой реализации занял 3 608 секунд против 169.73 у C-движка, расхождение логитов — 7.87 × 10⁻⁶ при бюджете 5.1 × 10⁻⁴, корреляция 1.000000000.
Честно названо и то, чего проверка не покрывает: паритет логитов гонялся на id 3,4,5,6,7, которые декодируются как $%&'(, — это синтетический мусор, и тот же прогон показывает KV cache 0.00 B, то есть путь KV не проверен вообще. Сильное свидетельство об арифметике и нулевое о качестве вывода.
Чего в движке нет: зрения (MoonViT-V2 полностью описан в конфиге на 27 слоёв и не имеет здесь ни строчки кода — 0.057 процента чекпоинта, то есть работа на 0.9 ГБ, а не на 1.56 ТБ), SIMD в рекуррентности KDA, чанкового префилла (потолок 32 768 токенов, но промпт на 21 000 токенов — это один квадратичный проход), бенчмарков качества. Контекст ограничен памятью, а не движком. Архитектура разобрана в docs/ARCHITECTURE.md, методики замеров — в docs/BENCHMARKING.md и docs/PERFORMANCE.md, выбор бюджета — в docs/TUNING.md, планы — в docs/ROADMAP.md.
Проверить всё это можно за минуту и без чекпоинта: make -j, затем make test прогоняет весь набор тестов без весов, без сети и без Python. Дальше ./scripts/k3-doctor.sh проверит тулчейн, подберёт пресет под объём RAM и напечатает точную следующую команду. Сам чекпоинт — 1.56 ТБ, то есть часы, а не минуты, и скрипт загрузки сверяет количество шардов и размер каждого по отдельности: частичная загрузка не падает громко, она молча портит токены.
Лицензия — Apache 2.0, LICENSE, правки вендоренных компонентов объявлены в NOTICE. Весов модели в репозитории нет и прав на них он не даёт: Kimi K3 выпущена Moonshot AI под собственной лицензией.