Strata — большая языковая модель на домашнем компьютере
📂 Исходный код на GitHubДвижок локального запуска Qwen3.8-Flash-Next на любом бытовом железе: установка в один клик для Windows и Linux, распределение работы между GPU, CPU, RAM и SSD, API, совместимый с OpenAI и Anthropic, опциональный разбор картинок. Лицензия MIT.
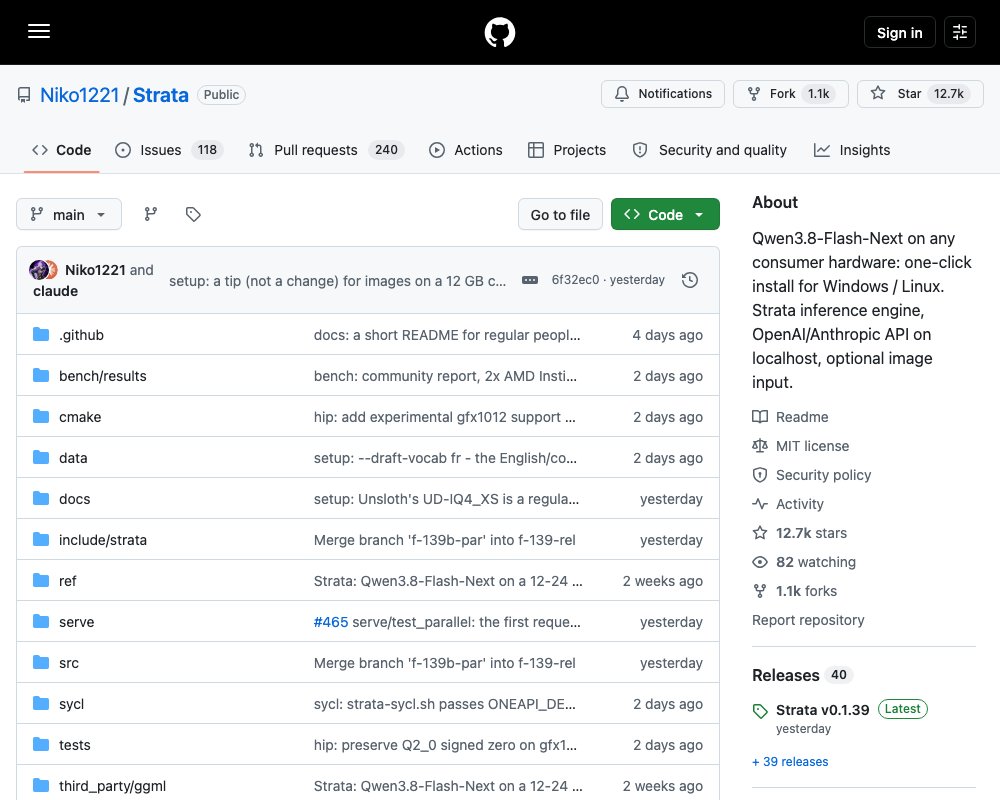
Strata — это локальный движок для запуска больших языковых моделей на обычном игровом компьютере. Он берёт модель Qwen3.8-Flash-Next на 125 миллиардов параметров и размещает её в памяти, которой обычно хватает только серверу. Никакой отправки данных наружу: всё считается на вашей машине.
Проект выпущен под лицензией MIT. Установка занимает один скрипт. Дальше модель отвечает через локальный HTTP-сервис, к которому подключаются ваши приложения и агенты для написания кода.
Что внутри
Обычно модель такого размера требует сервера с сотнями гигабайт видеопамяти. Strata решает эту задачу иначе: он раздаёт работу на всю машину сразу.
Авторы объясняют это через кухню. То, чем пользуешься постоянно, лежит на столе. Остальное ждёт в кладовке.
В основе модели лежит команда из 24 576 маленьких специалистов, которых авторы называют экспертами. На каждое слово нужны только десять из них. Дальше начинается разделение:
- Видеокарта хранит несколько тысяч самых востребованных экспертов.
- Оперативная память хранит их все.
- Процессор параллельно работает с остальными.
- SSD хранит большую таблицу соответствий.
Поверх этого есть ещё приём «угадал и проверил». Маленький помощник предполагает следующие несколько слов, а большая модель проверяет все варианты разом и оставляет правильные. Ответ получается тот же, но на 1,6–1,8 раза быстрее. Длинные тексты читаются крупными кусками, до 8 192 токенов за раз, со скоростью больше 1 000 токенов в секунду.
Подробное описание есть в документации по принципу работы, а все числа с расчётами — в разделе подробностей. Есть и научная работа.
Требования к железу
| Что нужно | Требования |
|---|---|
| Видеокарта | NVIDIA GeForce RTX 20, 30, 40 или 50 серии, либо AMD Radeon RX 7900 XT/XTX, RX 7800 XT/7700 XT, RX 9060 XT, RX 9070/9070 XT, Radeon AI PRO R9700 или серии RX 6800/6900. Нужно от 12 ГБ видеопамяти |
| Оперативная память | От 32 ГБ. 64 ГБ позволяют запустить любой размер модели |
| Место на диске | Около 80 ГБ свободного места. Лучше SSD — первый запуск будет заметно быстрее |
| Система | Windows 10/11 или Linux и свежий драйвер от NVIDIA или AMD |
Остальное делает установщик. Две или три видеокарты умеют работать вместе, это описано в разделе про несколько GPU.
Слабые карты тоже пробовали — сообщество собрало рабочие варианты для старых видеокарт и для Intel Arc на Linux с сборкой из исходников. Процессоры без AVX2 работают, но медленно. Полный список требований — в инструкции по установке.
Установка
Можно поручить всё AI-ассистенту. Отправьте Claude Code, Cursor, Codex или GitHub Copilot такой запрос:
Set up Strata on this PC for me: https://github.com/Niko1221/Strata - follow docs/AI_SETUP.md in that repository.Подробности этого сценария — в инструкции для ИИ. Через MCP-сервер Strata можно ставить, запускать и останавливать прямо из агента.
Ручной путь простой. Скачайте архив репозитория и распакуйте, либо склонируйте репозиторий. Дальше:
- Windows: двойной клик по
START-HERE.bat. - Linux: запуск
./setup.shв папке Strata.
Шаги одинаковые для NVIDIA и AMD. Установщик сам находит карту и ставит подходящий движок. Затем он задаёт три вопроса: какую модель и какого размера взять, сколько контекста нужно (это сколько текста модель держит в голове) и читать ли картинки. На каждый вопрос можно просто нажать Enter и получить рекомендованный ответ. После этого скачивается модель, около 70 ГБ, и запускается. Если загрузка оборвалась, запустите скрипт ещё раз — продолжение с места остановки.
Браузер откроет приложение по адресу http://127.0.0.1:8080.
Важный момент: пока модель стартует, компьютер может зависнуть на 1–3 минуты, в первый раз дольше. Strata загружает в оперативную память 35–55 ГБ и часть её блокирует под видеокарту. Это нормально. Не закрывайте окно, в нём видно, что происходит.
В следующий раз снова запустите START-HERE.bat или ./setup.sh. Модель поднимется сразу, ничего не скачивая дважды. Закрытие окна останавливает её. Обновление без запуска — UPDATE.bat на Windows и ./update.sh на Linux.
Какую модель выбрать
Установщик рекомендует вариант по вашей оперативной памяти. Одна и та же модель выходит в нескольких размерах: чем сильнее сжатие, тем быстрее работа и тем слабее модель.
| Оперативная память | Рекомендация | Почему |
|---|---|---|
| 32 ГБ | Coder | влезает в 32 ГБ, версия заточена под код. На карте с 24 ГБ заработают также Q2_0 и IQ2_XS |
| 48 ГБ | IQ2_XS или Q2_0 | крупные размеры уже не помещаются, Q2_0 самый быстрый |
| 64 ГБ | IQ2_XS, либо IQ3_XXS или IQ3_S | влезают все размеры; IQ3_S лучший и самый медленный |
| от 96 ГБ | IQ3_S или UD-IQ4_XS от Unsloth | место для крупных размеров и всех остальных программ |
Отдельно стоит сказать про варианты:
- Coder — версия для кода, из которой удалили половину экспертов. По замерам авторов она набирает 91% результата полной модели в SWE-bench Verified и помещается в 32 ГБ RAM. Вне кода она слабее, включая китайский и другие языки с иероглифами. Для таких задач берут Q2_0, IQ2_XS или IQ3_S, где сохранены все эксперты.
- Swift 1.5 — доработанная модель, которая думает заметно меньше времени перед ответом. Ответ приходит раньше при примерно том же качестве.
- UD-IQ4_XS от Unsloth — версия примерно в 4 бита, по качеству между IQ3_S и UD-Q4_K_XL. Скачивается 94 ГБ. Если оперативной памяти меньше 80 ГБ, часть модели читается с SSD во время ответа, поэтому работа медленнее. Помогает NVMe SSD.
- UD-Q4_K_XL от Unsloth (экспериментально) — ближе всего к полной модели. Но большую часть приходится читать с SSD, и на ПК с 64 ГБ скорость ответа всего 7–8,5 токена в секунду.
Размеры, объём загрузок и правила выбора описаны в списке моделей.
Использование
В браузере по адресу http://127.0.0.1:8080 есть Chat, живой Monitor с состоянием модели и нагрузкой на GPU, CPU и RAM, а также About с настройками и адресами.
Для приложений и агентов нужно добавить провайдер, совместимый с OpenAI, с базовым адресом http://127.0.0.1:8080/v1. Подойдёт любой ключ и любое имя модели. Для приложений на API Anthropic адрес другой: http://127.0.0.1:8080/v1/messages, а для Claude Code достаточно переменной ANTHROPIC_BASE_URL=http://127.0.0.1:8080. Codex CLI и другие клиенты OpenAI Responses API используют /v1/responses.
Дополнительные настройки:
- Размышление переключается между off, low, medium и high в меню чата или через параметр reasoning effort в приложении. Off — самый быстрый, high — лучше для сложных задач.
- Картинки включаются ответом «да» на вопрос «Images?» при установке. Дальше в чате есть кнопка Picture, в приложениях картинки прикладываются как обычно. Карты AMD читают изображения на Linux через процессор, на Windows пока не могут.
- Доступ с телефона или с другого ПК включается так:
START-HERE.bat --setup --host 0.0.0.0 --api-key <секрет>. Ключ обязателен. - Параллельные запросы: по умолчанию Strata отвечает на один запрос, остальные ждут. Параметр
"parallel": 2в файле настроек включает несколько одновременных ответов. На карте с 12 ГБ каждый ответ станет медленнее. Подробности — в описании пакетной обработки. - Длинные запросы: первое сообщение чата Strata читает полностью, примерно минута на 30 000 токенов. Дальнейшие сообщения начинают обрабатываться за секунды.
Скорость
Замеры сделаны на двух обычных игровых ПК. Токен — примерно три четверти слова.
| Размер | NVIDIA RTX 5070 (12 ГБ), Ryzen 5 7600, 64 ГБ RAM | AMD RX 9070 XT (16 ГБ), Ryzen 9 3900X, 47 ГБ RAM |
|---|---|---|
| Q2_0 | 94 токена/с | 60 токенов/с |
| IQ2_XS | 79 токенов/с | 52 токена/с |
| IQ3_XXS | 62 токена/с | — |
| IQ3_S | 53 токена/с | — |
| Coder | 55 токенов/с | 44 токена/с |
Скорость чтения запроса выше: 2 650 токенов/с на NVIDIA и 1 160 токенов/с на AMD для размера Q2_0. Полные таблицы — в деталях замеров, результаты сообщества — в отдельном файле. Чем больше видеопамять на карте, тем быстрее: на RTX 3090 с 24 ГБ стоит ожидать около 100–140 токенов в секунду.
Если что-то пошло не так
- Компьютер завис при первом запуске. Это нормально, пока грузится модель. Ждите и не закрывайте окно. Если через десять минут всё ещё тишина, перезагрузите ПК, закройте лишние программы или возьмите размер поменьше.
- Загрузка остановилась. Запустите
START-HERE.batили./setup.shснова, продолжение пойдёт с места остановки. - Всё тормозит, мигает индикатор диска или появилось сообщение, что движок неожиданно остановился. Не хватает свободной оперативной памяти. Закройте другие программы, браузеры много едят, или возьмите размер поменьше: Q2_0 или IQ2_XS.
- Порт 8080 уже занят. Strata уже запущена. Найдите её окно.
Другие проблемы и решения собраны в разборе неполадок. Если не помогло, откройте issue и приложите лог strata-<модель>.log из папки Strata.
Лицензия
Код Strata открыт под лицензией MIT, файл лежит в репозитории. У отдельных частей и у самой модели есть свои лицензии, список — в разделе про лицензии.
Модель Qwen3.8-Flash-Next сделана командой Qwen. Сжали её в GGML-форматы ISTA-DASLab, UkisAI (версия Swift 1.5) и Unsloth. В движке используются части llama.cpp и ggml.
Источник: https://github.com/Niko1221/Strata