

PageIndex — RAG без векторных баз: поиск по документам через рассуждения LLM
📂 Исходный код на GitHubОткрытый движок RAG без векторных баз: LLM строит древовидный индекс документа и находит ответ логическим обходом дерева.
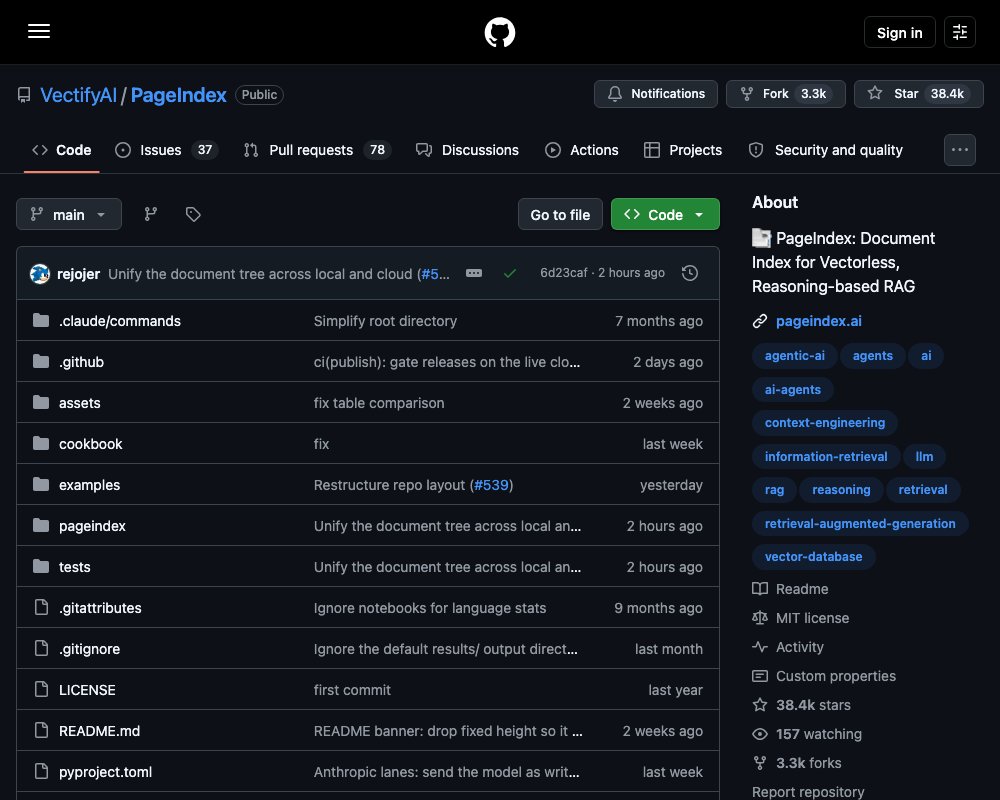
PageIndex — открытый движок RAG, который отказывается от векторных баз данных и чанкинга. Вместо этого он строит иерархический древовидный индекс документа и позволяет LLM найти ответ через рассуждения. Проект от VectifyAI написан на Python и распространяется под лицензией MIT.
В чём проблема векторного поиска
Классический RAG ищет по семантической близости. Но близость — это не то же самое, что релевантность. Релевантность требует рассуждения, а не совпадения эмбеддингов.
На профессиональных документах — финансовых отчётах, юридических договорах, технических регламентах — это различие становится критичным. Векторный поиск пропускает то, что релевантно, но не похоже на запрос. И возвращает то, что похоже, но по делу не относится.
Авторы PageIndex предлагают смотреть на задачу иначе, как это сделала AlphaGo: не запоминать все возможные позиции, а рассуждать по дереву вариантов.
Как это работает
Схема состоит из двух шагов.
- Индексация. Для каждого документа строится древовидный индекс — иерархическое оглавление с аннотациями узлов. Сама структура извлекается из разметки документа без участия LLM, а модель лишь суммирует и уточняет узлы. Поэтому для индексации достаточно базовой модели.
- Поиск. Агентно рассуждающая LLM обходит это дерево так же, как человек-эксперт листает длинный отчёт: смотрит оглавление, выбирает нужный раздел, спускается глубже, читает найденное.
| Vector RAG | PageIndex | |
|---|---|---|
| Индекс | векторный индекс | древовидный индекс |
| Поиск | поиск по семантической близости | рассуждение LLM по дереву |
| Результат | непрозрачный «поиск по вайбу» | прослеживаемая ссылка на источник |
| Контекст | только эмбеддинг запроса | вся история диалога, знание домена и т.д. |
Каждый ответ можно проследить до конкретной страницы документа. Retrieval становится объяснимым: видно, по каким узлам дерева прошла модель и почему.
Подробнее об идеологии проекта — в введении на блоге PageIndex.
Быстрый старт
Библиотека ставится через pip:
pip install -U pageindexМинимальный пример — локальный режим со своим ключом OpenAI:
import os
from pageindex import PageIndexClient

os.environ["OPENAI_API_KEY"] = "your-openai-key"

client = PageIndexClient(
    index="gpt-5.6-luna",               # model to build the tree index
    chat="gpt-5.6-sol",                 # model to search the tree
)
doc_id = client.submit_document("report.pdf")["doc_id"]

answer = client.chat("What was the 2023 operating margin?", doc_id=doc_id)
print(answer)
Рекомендации по моделям простые. Для параметра index хватит дешёвой модели: LLM там только суммирует узлы. Для параметра chat берите лучшую модель, которую можете себе позволить: именно она ведёт поиск по дереву.
Клиент умеет стриминг, поиск по нескольким документам и цитаты с указанием страниц. PageIndex также легко встроить в собственный агент — SDK совместим с OpenAI Agents SDK, Claude Agent SDK и другими фреймворками. Подробности в документации по интеграции с агентами.
Сколько стоит и как быстро
Индексация в локальном режиме стоит около $0.001 за страницу на базовой модели. Учебник на 1000 страниц обойдётся примерно в доллар и несколько минут — один раз. Все последующие вопросы переиспользуют готовый индекс.
В бенчмарках проекта документы от 9 до 1098 страниц индексировались за 13 секунд до 4,5 минут. Время растёт предсказуемо вместе с длиной документа.
Альтернатива поиску — скармливать модели весь PDF при каждом вопросе. Такой подход дорожает с ростом документа, а PageIndex — нет: модель читает только те узлы, до которых добралось рассуждение. На документах, где оба способа дают одинаковый ответ, нативная подача PDF обходится в 2,1 раза дороже при 52 страницах и в 16,6 раза при 420. А при 805 страницах документ уже не влезает в контекстное окно.
Точность
Команда измеряла качество на открытом бенчмарке PageIndex-OSS-Benchmark: 62 вопроса точного поиска по 34 PDF на 1945 страниц из датасета MMLongBench-Doc-V2. Все ответы — факты из текста, поэтому ошибка означает провал поиска или чтения, а не рассуждения.
На финансовом бенчмарке FinanceBench PageIndex показал 98,7% точности. Полные результаты оценки опубликованы в репозитории Mafin2.5-FinanceBench, а разбор — в посте блога.
Локально или в облаке
Локальный режим удобен для текстовых PDF и приватных рабочих процессов: всё считается на вашей машине с вашим ключом LLM.
PageIndex Cloud берёт на себя парсинг, OCR, понимание изображений, построение индекса и хранилище. Слой поиска остаётся совместимым с вашей моделью: вы запрашиваете облачный индекс через провайдера, которого уже используете.
| Local | Cloud | |
|---|---|---|
| Документы | текстовые PDF | текстовые, сканы, документы с картинками |
| Индексация | на вашей машине | управляется PageIndex |
| Хранилище | локальная папка | облако |
| Цитаты | до страницы | до блока |
| OCR и понимание картинок | — | да |
| MCP-сервер | — | да |
Для облака меняется одна строка: параметр index получает значение cloud, а клиент — ключ PageIndex API. Есть и PageIndex File System — облачный слой файлового индексирования, который масштабирует рассуждение с одного документа на весь корпус. Специализированное развёртывание в VPC или on-premises доступно по запросу.
Кому подойдёт
PageIndex создан для длинных и сложных документов, где важен точный ответ с указанием источника: финансовая отчётность, юридические и регуляторные документы, технические руководства, медицинская литература, академические учебники. Если ваши документы уже хорошо размечены и вам не нужен OCR, локальный режим закрывает сценарий полностью бесплатно — кроме расходов на API модели.
Полная документация — на docs.pageindex.ai, руководства по началу работы — в разделе getting started.
Источник: https://github.com/VectifyAI/PageIndex