

LlamaIndex — Python-фреймворк для RAG и агентных приложений
📂 Исходный код на GitHubOpen-source Python-фреймворк LlamaIndex для сборки RAG- и агентных приложений: коннекторы к данным, индексы, ретривер и более 300 интеграций.
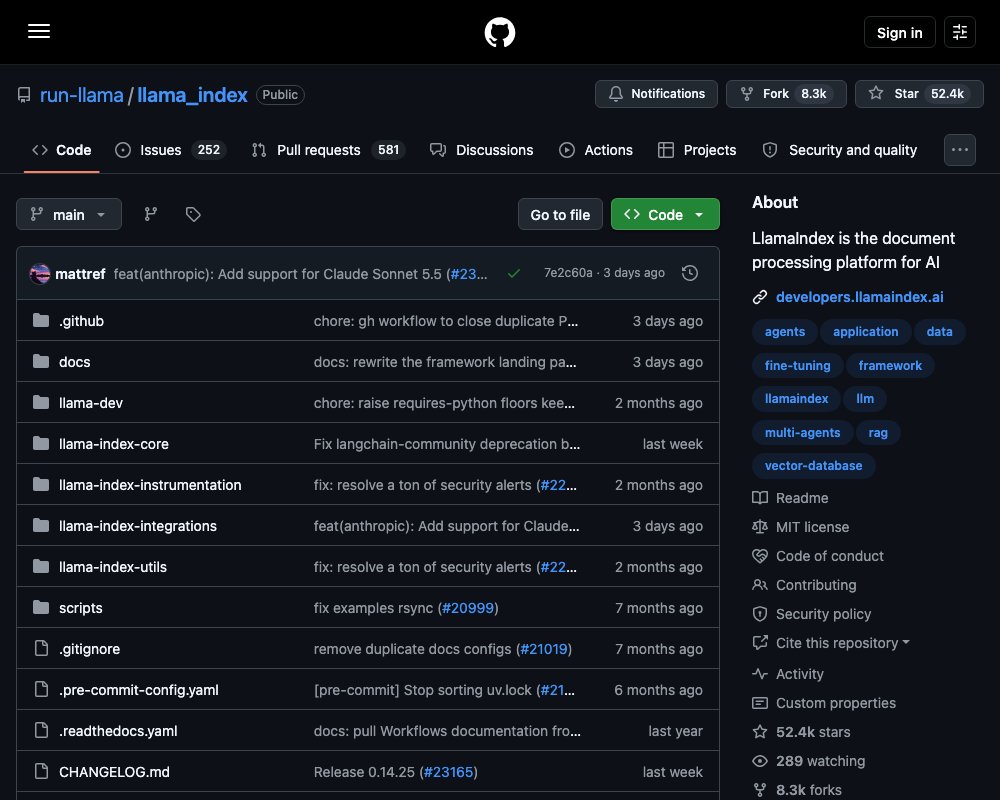
LlamaIndex — один из самых известных open-source фреймворков для работы с LLM. Он появился в 2022 году как «фреймворк данных»: библиотека, которая помогает подключить к языковой модели ваши собственные документы. Сегодня у проекта больше 52 тысяч звёзд на GitHub, лицензия MIT, а основной язык — Python.
За три года компания LlamaIndex сильно изменилась. Сейчас её главный продукт — платформа LlamaParse для разбора и извлечения данных из документов. Но открытый фреймворк никуда не делся: он по-прежнему доступен, развивается и остаётся удобным инструментом для сборки RAG-приложений и агентов. Об этом и пойдёт речь.
Зачем нужен фреймворк данных
LLM обучены на публичных данных. Они хорошо рассуждают и генерируют текст, но ничего не знают о ваших внутренних документах: о базе знаний компании, контрактах, отчётах или технической документации.
Проблему решает дополнение модели своими данными — retrieval-augmented generation (RAG). Идея простая: сначала находим в документах подходящие фрагменты, затем передаём их модели как контекст вместе с вопросом.
На практике всё сложнее. Документы бывают в разных форматах. Их нужно где-то хранить, разбивать на части, превращать в векторы, искать по ним и ранжировать результаты. Именно эту цепочку задач и закрывает LlamaIndex. Фреймворк даёт четыре группы инструментов:
- Коннекторы к данным. Загрузка из API, PDF, HTML, SQL и других источников.
- Структурирование. Построение индексов и графов, с которыми удобно работать LLM.
- Интерфейс запросов. Вы передаёте промпт и получаете ответ, основанный на найденных в данных фрагментах.
- Интеграции с внешними инструментами. Фреймворк сочетается с LangChain, Flask, Docker и чем угодно ещё.
Есть два уровня API. Высокий уровень позволяет загрузить данные и задавать по ним вопросы буквально в пять строк кода. Низкий уровень нужен продвинутым пользователям: он позволяет заменить любой модуль — коннектор, индекс, ретривер, механизм запросов, переранжирование.
Устройство: core плюс интеграции
Пакеты LlamaIndex устроены модульно. Есть два способа начать работу.
Первый — стартовый пакет llama-index. В него входят ядро фреймворка и набор часто используемых интеграций. Это самый быстрый путь для знакомства.
Второй — ядро llama-index-core плюс интеграции на ваш выбор. Полный список есть на странице интеграций. Их больше 300: разные LLM, модели эмбеддингов, векторные хранилища и инструменты загрузки данных. Такой подход даёт точный контроль над зависимостями.
Пространства имён сразу показывают, что откуда взято. Если в импорте есть слово core — это ядро фреймворка. Если нет — это интеграция:
# typical pattern
from llama_index.core.xxx import ClassABC  # core submodule xxx
from llama_index.xxx.yyy import (
    SubclassABC,
)  # integration yyy for submodule xxx

# concrete example
from llama_index.core.llms import LLM
from llama_index.llms.openai import OpenAI
Это делает код предсказуемым. Вы всегда видите, что зависит от ядра, а что — от внешнего пакета, и при необходимости можете заменить интеграцию на другую.
Быстрый старт
Устанавливаем ядро и нужные интеграции:
# custom selection of integrations to work with core
pip install llama-index-core
pip install llama-index-llms-openai
pip install llama-index-llms-ollama
pip install llama-index-embeddings-huggingface
Минимальный RAG-пример с OpenAI выглядит так:
import os

os.environ["OPENAI_API_KEY"] = "YOUR_OPENAI_API_KEY"

from llama_index.core import VectorStoreIndex, SimpleDirectoryReader

documents = SimpleDirectoryReader("YOUR_DATA_DIRECTORY").load_data()
index = VectorStoreIndex.from_documents(documents)
SimpleDirectoryReader читает файлы из папки, а VectorStoreIndex строит по ним векторный индекс. Затем индекс превращается в механизм запросов:
query_engine = index.as_query_engine()
query_engine.query("YOUR_QUESTION")
По умолчанию данные хранятся в памяти. Для сохранения на диск в папку ./storage достаточно одной команды:
index.storage_context.persist()А так индекс загружается обратно:
from llama_index.core import StorageContext, load_index_from_storage

# rebuild storage context
storage_context = StorageContext.from_defaults(persist_dir="./storage")
# load index
index = load_index_from_storage(storage_context)
Полностью локальный вариант без OpenAI тоже возможен. В примере ниже используется Ollama для LLM и модель эмбеддингов с Hugging Face:
from llama_index.core import Settings, VectorStoreIndex, SimpleDirectoryReader
from llama_index.embeddings.huggingface import HuggingFaceEmbedding
from llama_index.llms.ollama import Ollama
from transformers import AutoTokenizer

# set the LLM
Settings.llm = Ollama(
    model="llama-3.1:latest",
    request_timeout=360.0,
)

# set tokenizer to match LLM
Settings.tokenizer = AutoTokenizer.from_pretrained(
    "meta-llama/Llama-3.1-8B-Instruct"
)

# set the embed model
Settings.embed_model = HuggingFaceEmbedding(
    model_name="BAAI/bge-small-en-v1.5"
)

documents = SimpleDirectoryReader("YOUR_DATA_DIRECTORY").load_data()
index = VectorStoreIndex.from_documents(
    documents,
)
Объект Settings — это глобальная конфигурация. Вы один раз задаёте модель, токенизатор и модель эмбеддингов, а дальше все модули фреймворка используют их по умолчанию.
Готовые примеры лежат в папке docs/examples репозитория. Обновлённые руководства и справочник API — в документации.
LlamaParse и экосистема компании
Важно понимать контекст: open-source фреймворк — не главный фокус компании сегодня. Команда заявляет, что агенты — это новые «потребители» документов. Им нужны инструменты, которые достают контекст из сложных документов дёшево, точно и в большом масштабе. Отсюда текущие приоритеты.
LlamaParse — коммерческая платформа для работы с документами. В неё входят несколько продуктов:
- Parse — агентный OCR и разбор документов, поддержка более 130 форматов.
- Extract — извлечение структурированных данных из документов.
- Index — загрузка, индексация и RAG-конвейеры.
- Split — разбиение больших документов на подкатегории.
- Agents — сборка документных агентов через Workflows и Agent Builder, см. LlamaAgents.
LiteParse — отдельный open-source проект run-llama/liteparse. Это быстрый и дешёвый парсер текста, полностью бесплатный. Хороший вариант, если нужен только разбор файлов без облачной платформы.
Наконец, компания развивает открытые бенчмарки — ParseBench и ExtractBench. Они измеряют качество разбора и извлечения данных, чтобы сравнение инструментов было честным.
Безопасность сборки
Отдельного упоминания заслуживает проверка статических файлов. В пакет llama-index-core входит папка _static с кешем библиотек nltk и tiktoken. Она нужна для работы в окружениях, где доступ к диску ограничен.
Чтобы убедиться, что эти файлы не подменены, проект использует GitHub-механизм attest-build-provenance. Проверка выполняется локально через GitHub CLI:
#!/bin/bash
STATIC_DIR="venv/lib/python3.13/site-packages/llama_index/core/_static"
REPO="run-llama/llama_index"

find "$STATIC_DIR" -type f | while read -r file; do
    echo "Verifying: $file"
    gh attestation verify "$file" -R "$REPO" || echo "Failed to verify: $file"
done
Скрипт сверяет каждый файл установленного пакета с подписанными артефактами сборки репозитория.
Кому подойдёт LlamaIndex
Фреймворк хорошо вписывается в несколько сценариев.
Первый — быстрый прототип RAG. Пять строк кода дают рабочий поиск по документам с ответами LLM. Это удобно для проверки идеи до вложений в инфраструктуру.
Второй — продакшн-приложения с собственными данными. Низкоуровневые API позволяют заменить любой модуль: подключить своё векторное хранилище, свой ретривер, свою схему переранжирования.
Третий — локальные и приватные развёртывания. Связка Ollama и открытых моделей эмбеддингов полностью убирает зависимость от внешних API. Данные не покидают ваш контур.
Четвёртый — документные агенты. Если задача — автоматизировать работу с потоками документов, стоит посмотреть на платформу LlamaParse и связку с фреймворком.
Проект активно развивается, а сообщество большое: репозиторий принимает как правки ядра, так и новые интеграции. Правила описаны в руководстве для контрибьюторов. Лицензия MIT разрешает использование в коммерческих проектах.
Источник: https://github.com/run-llama/llama_index