

GPT Researcher — автономный агент для глубоких исследований с отчётами и ссылками на источники
📂 Исходный код на GitHubОткрытый агент глубокого исследования: генерирует детальные отчёты с цитатами на основе веб- и локальных источников. Поддерживает MCP, Deep Research и мультиагентный режим.
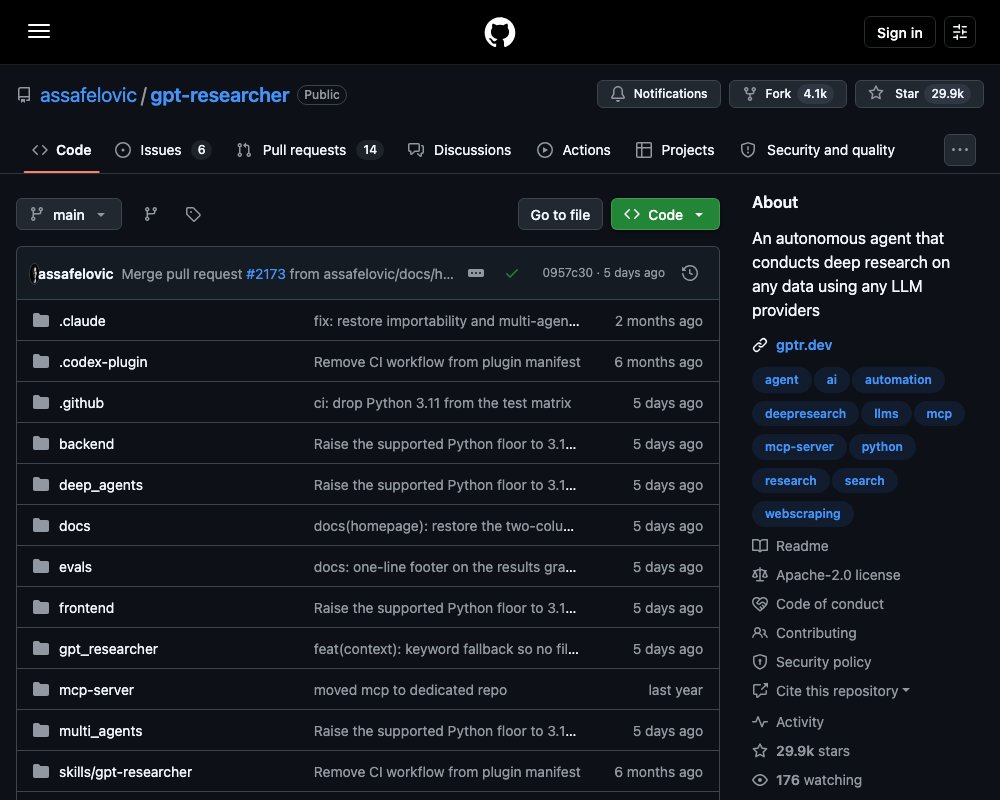
GPT Researcher — открытый агент для глубоких исследований. Вы даёте ему задачу, а он сам составляет план, ищет информацию в интернете и локальных файлах, проверяет источники и собирает подробный отчёт со ссылками. Проект написан на Python и распространяется по лицензии Apache 2.0. Авторы называют его первым открытым агентом глубокого исследования, который работает и с вебом, и с локальными данными.
Зачем нужен отдельный агент для исследований
Обычные способы изучить тему с помощью нейросетей дают слабый результат. Автор проекта называет четыре причины:
- Ручное исследование занимает недели и требует больших ресурсов.
- LLM обучены на устаревших данных и выдают выдуманные факты по актуальным вопросам.
- У моделей есть лимит контекста. Длинный отчёт не получается сгенерировать за один проход.
- Сервисы, которые опираются на несколько источников, дают поверхностные и односторонние ответы.
Ставка GPT Researcher проста: чем больше источников проверено, тем ниже шанс ошибки. Агент скрейпит десятки сайтов по каждой теме, а затем выбирает факты, которые повторяются чаще всего. Такой подход не убирает смещения полностью, но заметно его снижает.
Как устроена архитектура
Проект вдохновлён статьями Plan-and-Solve и RAG. Идея в том, чтобы разделить работу между ролями:
- Агент-планировщик получает задачу и формирует список вопросов. Вместе эти вопросы покрывают тему с разных сторон.
- Агенты-исполнители параллельно ищут ответ на каждый вопрос.
- Каждый найденный ресурс суммируется, и система запоминает, откуда взята информация.
- Финальный «издатель» сводит все выдержки в один отчёт.
Параллельная работа даёт два плюса: скорость растёт, а результат становится стабильнее. Отчёты выходят детальными — больше 2000 слов с опорой на 20 и более источников.
Ключевые возможности
- Генерация отчётов по веб-источникам и локальным документам.
- Умный сбор и фильтрация изображений для отчётов.
- Встроенные иллюстрации, которые генерирует Google Gemini по ходу исследования.
- Отчёты длиной больше 2000 слов.
- Более 20 источников на одно исследование.
- Скрейпинг сайтов с выполнением JavaScript.
- Память и контекст на протяжении всего исследования.
- Экспорт в PDF, Word и другие форматы.
- Готовые фронтенды: лёгкий на HTML, CSS и JS и продакшн-версия на NextJS.
Три способа установки
Через pip
Пакет опубликован на PyPI, поэтому проще всего начать с установки как библиотеки:
pip install gpt-researcherДальше агент вызывается из кода в несколько строк:
from gpt_researcher import GPTResearcher

query = "why is Nvidia stock going up?"
researcher = GPTResearcher(query=query)
research_result = await researcher.conduct_research()
report = await researcher.write_report()
Как веб-сервис
Для сервера нужен Python 3.11 или новее, а также ключи OpenAI и Tavily:
export OPENAI_API_KEY={ваш ключ OpenAI}
export TAVILY_API_KEY={ваш ключ Tavily}
pip install -r requirements.txt
python -m uvicorn main:app --reload
После запуска веб-интерфейс доступен на localhost:8000. Есть и вариант с Docker: поднимаются сервер на порте 8000 и React-приложение на порте 3000.
Как Claude Skill
Отдельный путь — установка прямо в Claude:
npx skills add assafelovic/gpt-researcherПосле этого Claude сможет запускать глубокие исследования прямо в диалоге, без своего сервера и фронтенда.
Работа с MCP
MCP поддерживается с двух сторон.
Как клиент, GPT Researcher подключает внешние источники данных: GitHub-репозитории, базы данных, собственные API. Так агент ищет не только в вебе, но и в ваших данных:
researcher = GPTResearcher(
    query="What are the top open source web research agents?",
    mcp_configs=[
        {
            "name": "github",
            "command": "npx",
            "args": ["-y", "@modelcontextprotocol/server-github"],
            "env": {"GITHUB_TOKEN": os.getenv("GITHUB_TOKEN")}
        }
    ]
)
Гибридный режим включается одной переменной окружения:
export RETRIEVER=tavily,mcpКак сервер, проект вынесен в отдельный репозиторий gptr-mcp. Через него любой MCP-совместимый клиент, например Claude Desktop, получает возможность глубокого исследования. Обычный веб-поиск через MCP возвращает сырые ссылки, а сервер GPT Researcher отдаёт готовый проверенный результат с экономией контекста.
Режим Deep Research
Обычное исследование проходит в один слой. Deep Research работает рекурсивно: тема разбивается на подтемы, каждая изучается отдельно, а вложенность задаётся параметрами глубины и ширины. Получается древовидный обход темы.
Особенности режима:
- настраиваемые глубина и ширина обхода;
- параллельная обработка ветвей;
- общее управление контекстом между ветвями;
- около 5 минут на одно исследование;
- около 0,4 доллара за запуск на модели o3-mini.
Подробности есть в документации Deep Research.
Исследование по локальным документам
Агент умеет работать не только с вебом. Через переменную DOC_PATH указывается папка с файлами, и исследование идёт по ним. Поддерживаются PDF, plain text, CSV, Excel, Markdown, PowerPoint и Word:
export DOC_PATH="./my-docs"Это удобно, когда факты нужно искать во внутренних документах компании, а не в открытом интернете.
Мультиагентный режим
Отдельная ветка проекта — команда агентов, построенная на LangGraph и AG2. Подход вдохновлён статьёй STORM: над одной темой работают агенты с разными ролями, от планирования до публикации. Средний запуск выдаёт отчёт на 5-6 страниц в форматах PDF, Docx и Markdown. Код живёт в папке multi_agents основного репозитория.
Наблюдаемость и фронтенд
Для отладки сложных мультиагентных сценариев есть интеграция с LangSmith. После настройки трёх переменных окружения все взаимодействия агентов видны в дашборде: видно, кто что вызвал и где теряется время.
Фронтендов два. Лёгкий статический вариант отдаётся прямо из FastAPI. Полноценный построен на NextJS и Tailwind: ввод запроса, прогресс исследования в реальном времени и интерактивный показ находок.
Итог
GPT Researcher закрывает конкретную задачу: превратить вопрос в проверенный отчёт со ссылками, а не в набор ссылок. Проект подходит трём сценариям:
- Как библиотека в Python-коде, когда исследование нужно встроить в своё приложение.
- Как веб-сервис или Docker-развёртывание с готовым интерфейсом.
- Как MCP-сервер или Claude Skill, когда глубокое исследование нужно внутри ассистента.
Внести вклад в проект можно через CONTRIBUTING.md, дорожная карта опубликована на Trello, а живое обсуждение идёт в Discord-сообществе.