

PS5LM Plus — llama.cpp на видеокарте взломанной PS5
📂 Исходный код на GitHubПорт llama.cpp на взломанную PlayStation 5: нативное приложение запускает GGUF-модели на GPU консоли, показывает дашборд на телевизоре, раздаёт веб-чат и OpenAI-совместимый API по локальной сети.
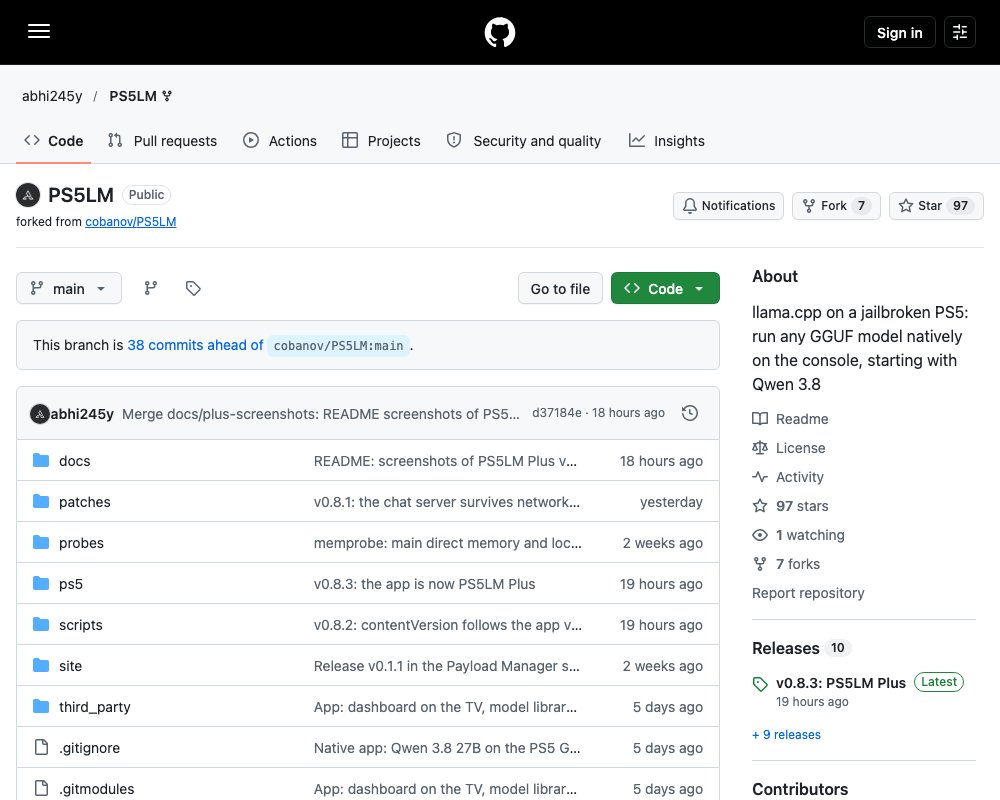
PS5LM Plus — это нативное приложение для взломанной PlayStation 5, которое запускает языковые модели прямо на консоли, на её GPU. Вместо облака и чужого железа получается локальный сервер с открытым API: к нему подключаются opencode, codex, Claude Code и aider. Разбираемся, что именно лежит в репозитории и что нужно, чтобы всё заработало.
Что это за проект
Изначально PS5LM сделал Mert Cobanov: это порт llama.cpp на PS5, который работает как payload — модуль, загружаемый в память консоли до старта приложения. Автор этого форка добавил нативное приложение (его называют title в терминах PS5) и назвал его PS5LM Plus, чтобы не путать с оригиналом. Этот вариант проекта предложен и автору оригинала в пул-реквесте cobanov/PS5LM#12.
Разница между двумя форматами запуска — и есть причина, почему появился форк:
- Payload получает около 6 ГиБ памяти и вообще не имеет доступа к GPU.
- Нативное приложение получает все 12 ГиБ прямой памяти консоли и саму видеокарту.
PS5LM Plus запускает всё сразу: llama-server с бэкендом ggml на Vulkan поверх RADV-порта Mihawk-99, в одном куче устройства размером 11,44 ГиБ.
Скорость генерации
Цифры из репозитория, все модели работают на GPU консоли:
| Модель | Контекст | Скорость |
|---|---|---|
| Qwen3.8-27B UD-Q2_K_XL (9,2 ГиБ) | 32k, кэш q4_0 | 20,3 токена/с |
| Qwen3.8-27B UD-IQ2_XXS (6,8 ГиБ) | 64k, кэш q8_0 | 20,7 токена/с |
| Gemma 4 E4B QAT q4_0 (4,8 ГиБ), с USB | 64k, кэш q4_0 | 61 токен/с |
| Llama 3.2 3B Instruct Q4_K_M (1,9 ГиБ), с USB | 64k, кэш q8_0 | 124 токена/с |
Для сравнения: та же 27B-модель на CPU в виде payload, когда она читается с диска, выдавала примерно один токен в минуту. Разница не в оптимизациях, а в том, где вообще считаются веса.
Возможности
Дашборд. Скорость генерации с историей, загрузка GPU и CPU, энергопотребление SoC и затраты энергии на один токен, температуры и вентилятор, пул памяти с разбивкой на модель, KV-кэш и остальное, занятый контекст, свободное место на каждом накопителе и загруженная модель. Кнопка Cross разворачивает карточки USAGE, POWER и MODEL.
Библиотека моделей. Приложение видит все файлы .gguf на внутренней памяти, на M.2 и на USB. Файлы сгруппированы по накопителям, для каждого показано, сколько контекста и какого типа кэш он получит и влезет ли вообще. Cross загружает модель. Модель на USB или M.2 открывается прямо с накопителя.
Настройки. Модель, которая загрузится при старте, максимальный контекст, тип KV-кэша, файловые инструменты чата и папка, в которой работают эти инструменты, звуки, накопитель для загрузок. Всё сохраняется в /data/PS5LM/settings.json.
Логи. app.log и llama.log прямо на экране телевизора, с фильтром только по ошибкам.
Получение моделей. Каталог GGUF-репозиториев Hugging Face — по популярности или по семейству. У каждого файла показан размер и впишется ли он в эту приставку (Square проверяет по первым 16 МиБ файла). Cross скачивает.
Загрузки. Очередь, которая переживает обрыв связи, паузу и перезапуск приложения. Каждая загрузка продолжается с места обрыва, повторяет попытки сама и показывает скорость и оставшееся время. Cross ставит паузу и снимает её, Square отменяет. Файлы сверяются по SHA-256.
Отдельные проверки безопасности: перед загрузкой приложение смотрит, хватает ли места (сам файл плюс 1 ГиБ запаса), и предлагает другой накопитель, если место есть там. Если память занята загруженной моделью, сначала спросит и может выгрузить её. Файловые инструменты чата ограничены папкой /data/PS5LM/scratch.
В сети. Веб-интерфейс llama.cpp доступен на http://<IP приставки>:8081; для моделей с поддержкой картинок (например, Gemma 4) можно отправлять изображения, положив рядом с моделью файл mmproj. На этом же порту работает API: OpenAI Chat Completions, OpenAI Responses и Anthropic Messages. Подробности про подключение coding-инструментов — в docs/CLI.md.
Под капотом. Планировщик сам подбирает самый длинный контекст и лучший тип KV-кэша, которые влезают в свободную память для конкретной модели. Есть готовые пресеты сэмплирования для Qwen 3.5/3.6/3.8, Gemma 4, gpt-oss, Granite, Nemotron, Mistral и Llama. Приложению не хватает доступа к датчикам температуры, вентилятора и питания, а также к реальному числу свободных байт на накопителе (statvfs внутри приложения — заглушка), поэтому оно носит с собой ps5-exporter и передаёт его загрузчику elfldr.
Что нужно
Взломанная PS5 и набор payload'ов, загруженных до старта приложения:
| Payload | Для чего | Нужно |
|---|---|---|
| kstuff-lite | патчи ядра, на которых работают homebrew-приложения | обязательно |
| etaHEN | поддержка homebrew | обязательно |
| ShadowMountPlus | регистрирует PS5LM Plus из /data/homebrew на главном экране |
обязательно |
| elfldr (порт 9021) | позволяет приложению запускать ps5-exporter | очень желательно |
| ftpsrv (порт 2121) | установка и обновление, копирование моделей с компьютера | желательно |
Установка
- Скачайте
ps5lm-app-vX.Y.Z.zipиз релизов форка и сверьте его с.sha256. - Распакуйте и скопируйте папку
PPSA99581в/data/homebrew/PPSA99581по FTP. После этого ShadowMountPlus добавит PS5LM Plus на главный экран. - Запустите приложение. Выберите модель в разделе Get models, либо скопируйте файл
.ggufв/data/PS5LM/models, либо положите его вPS5LM/modelsна USB-накопителе (exFAT) или M.2. - Выберите модель в библиотеке. Когда дашборд покажет Ready, откройте
http://<IP приставки>:8081с телефона или компьютера.
Обновление простое: закройте приложение и скопируйте новую папку PPSA99581 поверх старой. Настройки, модели и загрузки лежат в /data/PS5LM и не затрагиваются.
Подбор моделей описан в docs/MODELS.md. Подойдёт всё, что умеет запускать llama.cpp, если библиотека показывает LOAD.
Управление
| Где | Кнопка | Действие |
|---|---|---|
| Везде | L1 / R1 | предыдущая / следующая страница |
| Дашборд | стрелки, Cross | переход между карточками, раскрыть карточку; Cross на MODEL открывает библиотеку |
| Библиотека | Cross | загрузить модель под курсором (приложение перезапускается под неё) |
| Get models | L2 / R2 | сменить поиск: Popular, Qwen, Gemma и так далее |
| Get models | Square | проверить, впишется ли файл |
| Get models | Cross | открыть репозиторий, а на файле — скачать |
| Downloads | Cross | пауза, продолжить, повторить упавшую загрузку |
| Downloads | Square | отменить (дважды; недокачанный файл удаляется) или очистить завершённую |
| Логи | Square, Triangle | переключить лог, только ошибки |
Как это сделано
Подробные заметки лежат в docs/CONSOLE.md, а оригинальный payload описан в docs/PAYLOAD.md. Коротко:
- Сначала CPU. Первая версия считала Qwen 3.8 27B на CPU Zen 2, читая модель с диска, примерно один токен в минуту. Это доказало, что llama.cpp на консоли работает, и стало ясно, что нужен GPU.
- Приложение, а не payload.
llama-serverсобран в fSELFeboot.binс написанной с нуляlibc.prxи зарегистрирован через ShadowMountPlus. Приложения не умеют вызыватьexit(), часть импортов из libc резолвится в никуда, и нужны рабочиеgetaddrinfo,accept4иHOME. Каждую из этих проблем находили по падению. - GPU. ggml-vulkan поверх RADV из PS5_Vulkan без загрузчика Vulkan и с единой кучей RADV на 11,44 ГиБ.
- Экран. Интерфейс от ps5-homebrew-ui через ps5-opengl в том же процессе, что и RADV.
- Смена модели. Выгрузка на месте оставляет около 5 ГиБ пула занятыми, поэтому при смене модели приложение перезапускает само себя.
- HTTPS. Скачивания идут через системные libSceHttp2 и libSceSsl, поэтому в приложении нет ни своей библиотеки TLS, ни сертификатов.
Сборка из исходников
Приложение собирает llama.cpp вместе с ggml-vulkan поверх RADV из PS5_Vulkan. Сначала нужно подготовить PS5_Vulkan и его форки в .deps/src (PS5_Vulkan, PS5_Mesa и PS5_PayloadSDK на ревизиях, которые закреплены в PS5_Vulkan), затем:
git clone --recursive https://github.com/abhi245y/PS5LM
cd PS5LM
(cd .deps/src/PS5_Vulkan && tools/setup-native-dependencies.sh && tools/build-radv.sh release && make app)
scripts/build-app.sh
scripts/release-app.sh
С компьютера, когда приложение уже на приставке:
scripts/preview-app-ui.sh
PS5_HOST=<IP приставки> scripts/ps5lm-app.sh cycle
PS5_HOST=<IP приставки> scripts/ps5lm-app.sh press r1
PS5_HOST=<IP приставки> scripts/ps5lm-app.sh screenshot out.bmp
Приложение закрывается само по запросу (по файлу /data/PS5LM/quit), чтобы его не убивали посреди отрисовки. Файл /data/PS5LM/app-args.txt (по одному аргументу в строке) переопределяет то, что решил планировщик.
Лицензия и авторы
GPL-3.0-or-later, текст в LICENSE. Сам llama.cpp остаётся под MIT.
Оригинальный PS5LM, порт llama.cpp, payload и исследования — работа Mert Cobanov (cobanov/PS5LM). RADV на PS5 — Mihawk-99, инструменты интерфейса и протокола разработки — BlackBearReloaded, ps5-exporter — Marice, SDK, загрузчик ELF и ftpsrv — ps5-payload-dev.
Источник: https://github.com/abhi245y/PS5LM