openTPU — открытый AI-ускоритель на FPGA, спроектированный агентами
📂 Исходный код на GitHubОткрытый AI-ускоритель на FPGA, спроектированный ИИ-агентами. Десять языковых моделей от LFM2.5-230M до Gemma 4 работают на PCIe-карте Inspur YPCB-00338 и выдают бит в бит те же токены, что и симулятор. В монорепозитории лежат RTL на SystemVerilog, набор команд, симулятор, язык ядер с компилятором и профилировщик. Лицензия Apache 2.0.
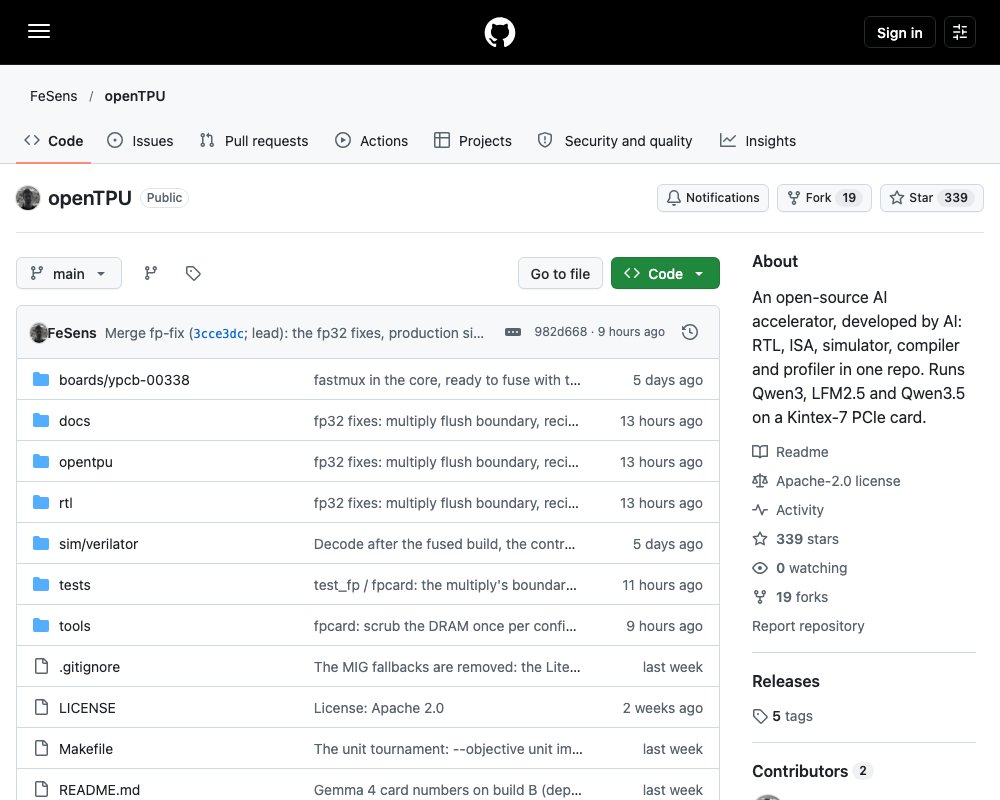
openTPU — это открытый ускоритель для запуска языковых моделей на FPGA-карте. Проект интересен тем, что его проектировали ИИ-агенты. Это те же агенты, чей собственный inference он и выполняет. Репозиторий отвечает на два вопроса: как далеко ИИ-агенты могут зайти в проектирование железа и смогут ли они построить чип, который считает их самих.
Второй смысл проекта — учебный. Весь ускоритель помещается в один небольшой монорепозиторий, который можно прочитать от начала до конца: схема железа на SystemVerilog, набор команд, симулятор с результатом бит в бит, язык ядер с компилятором и хостовое ПО для управления настоящей PCIe-картой. Если хочется понять, как работает ускоритель, — от умножения матриц в Python до уровня проводов, — это хорошее место для начала.
Что показано на реальной карте
Дизайн запускает десять современных моделей с настоящими весами на карте Inspur YPCB-00338: чип Xilinx Kintex-7 xc7k480t и два канала DDR3. Карта выдаёт ровно те же токены, что и симулятор, бит в бит.
| Модель | Веса | Decode, карта | Decode, вместе с хостом | Prefill, карта | DRAM при декодировании |
|---|---|---|---|---|---|
| LFM2.5-230M | int8 | 59.0 tok/s | 52.3 tok/s | 295.6 tok/s | 14.5 GB/s (85% от пика) |
| Qwen3-0.6B | int8 | 21.6 tok/s | 21.3 tok/s | 92.1 tok/s | 14.4 GB/s (84%) |
| Qwen3.5-0.8B | int8 | 17.6 tok/s | 16.3 tok/s | 61.4 tok/s | 14.5 GB/s (85%) |
| LFM2-2.6B | int8 | 6.05 tok/s | 6.03 tok/s | 21.4 tok/s | 16.1 GB/s (94%) |
| SmolLM3-3B | int8 | 5.00 tok/s | 4.99 tok/s | 21.1 tok/s | 16.0 GB/s (94%) |
| Phi-4-mini (3.8B) | int8 | 3.99 tok/s | 3.98 tok/s | 13.8 tok/s | 16.0 GB/s (94%) |
| Qwen3.5-2B | int8 | 8.02 tok/s | 8.00 tok/s | 38.2 tok/s | 16.0 GB/s (94%) |
Несколько деталей о том, как снимали эти цифры, — чтобы результат можно было проверить.
- Decode — это 64 токена, выбранных жадно (всегда берётся самый вероятный), после запроса длиной 512 токенов. Выбирает следующий токен хост, а не карта. «Карта» считает только циклы, в которые ускоритель занят. «Вместе с хостом» добавляет время хоста.
- Prefill — это тот же запрос из 512 токенов, целиком на карте.
- Трафик DRAM взят из собственных счётчиков карты во время работы.
- Карта стоит в обычном ПК на Intel Core i7-4790.
Если логиты уходят на хост по мере вычисления, decode становится быстрее. Например, LFM2-2.6B в 4 бита даёт 11.07 tok/s на карте против 10.96 в таблице выше.
Прошивка работает на 133.33 MHz. Контроллеры памяти LiteDRAM калибруются маленьким CPU внутри самого ядра памяти: при старте прошивки он настраивает оба канала DDR3 за 12 секунд, без участия хоста. DDR3-1066 даёт пик 17.1 GB/s.
Сравнение с предыдущей рабочей прошивкой se-cand3: decode отличается не больше чем на 2.3% во всех конфигурациях. Причина в том, что decode упирается в DRAM, а LiteDRAM читает на 82–85% пика — ровно как Xilinx MIG. Prefill при этом стал быстрее на 30% на Qwen3.5 и вдвое на LFM2 в 4 бита.
Как устроен конвейер
  Ядра на ol              mlp, attention, полный слой модели
        |  @ol.jit
  Язык + компилятор       раскладки, адресация циклов, слияние
        |
  ISA                    8 x 32-битных слов на инструкцию
        |
  Симулятор ISA  <====>  RTL         одинаковые биты, проверяются тестами
  (Python)                (SystemVerilog)
                             |  Битстрим Vivado
                            FPGA-карта    Kintex-7 xc7k480t
                             |  PCIe
                            Хост           otpu-chat, otpu-smi, otpu-lens
Машина намеренно простая. Блок управления выдаёт одну инструкцию за цикл сразу нескольким исполнителям. DMA переносит данные. Матричный блок умножает веса в int8, которые потоком приходят из DRAM. Векторный блок считает в fp32. Квантователь переводит результат обратно в int8. Кэша нет, скрытого планирования нет. Каждое перемещение данных — это отдельная инструкция, поэтому трассировка показывает, куда уходят циклы. Полный набор команд описан в docs/isa.md.
Ядро выглядит так:
from opentpu import language as ol

@ol.jit
def mlp(h, gamma, w_gate, w_up, w_down, out, eps):   # simplified; see opentpu/kernels
    x = ol.load(h)
    xs = ol.quantize(rmsnorm(x, ol.load(gamma), eps))
    g = ol.dot(xs, w_gate)
    u = ol.dot(xs, w_up)
    a = ol.all_gather(silu(g) * u)
    y = ol.all_gather(ol.dot(a, w_down))
    if ol.program_id() == 0:
        ol.store(out, x + y)
Компилятор превращает это в инструкции. Он раскладывает тензоры в памяти, раскрывает циклы, адресуя данные через смещения, и сливает соседние операции. Как именно это работает — в docs/compiler.md, реальные ядра лежат в opentpu/kernels.
Lens: профилировщик, который показывает циклы
Lens записывает прогон прямо из RTL, из симулятора или с карты и открывает его в браузере. Внутри — график предельных возможностей (roofline), таймлайн и таблицы по каждой инструкции. Всё это работает как раз потому, что в машине нет кэша и скрытого планирования: трасса сама объясняет скорость. Описание — в docs/lens.md.
Вес в 4 бита и модели с большим числом экспертов
Веса в 4 бита — это значения FP4 с двухуровневыми блочными масштабами, 4.25 бита на вес. Голову языковой модели оставляют в int8 ради точности. Число байт на токен падает примерно на треть, а скорость decode растёт на 40% (Qwen3.5) и до 45% (Qwen3, LFM2). Плата за это — заметное падение perplexity, то есть качества предсказания следующего токена. По каждой модели цифры приведены в docs/quant.md.
Модели с mixture-of-experts (MoE), которые не помещаются в 4 GiB памяти карты, работают за счёт подкачки экспертов с диска хоста. Карта сама выбирает нужного эксперта для каждого токена и сама считает их все. Эксперты она хранит в отдельных слотах в своей DRAM. Хост только копирует недостающие эксперты из файла-пула в эти слоты, и делает это на скорости самой PCIe-ссылки.
Замеры от 2026-10-01 на карте, эксперты в 4 бита, голова в int8:
- LFM2.5-8B-A1B (8.5B параметров, 1.7B активных): 10.6 tok/s на 160 токенах. В 98.5% обращений к экспертам данные уже лежали в слотах, на токен подкачивалось 5.2 MB.
- Qwen3.5-35B-A3B (34.7B параметров, 3.0B активных): 3.95 tok/s. Здесь в слоты попадает только 62% обращений, и на токен уходит 153 MB на скорости 1.41 GB/s по PCIe.
Обе модели совпадают с симулятором бит в бит. Подробности — в docs/offload.md.
Хост почти не участвует
Для LFM2 и Qwen3 карта выполняет одну программу декодирования, скомпилированную один раз. Сама читает позицию токена из регистра. Сама достаёт нужную строку эмбеддинга и строку RoPE (это поворот вектора, который кодирует позицию токена). Логиты уходят на хост, пока карта ещё считает. Хост добавляет 0.17–0.30 мс на токен на системе omarchy и 0.45–1.3 мс на opentpu.
У Qwen3.5 decode устроен так же. А вот prefill у него компилируется на хосте по частям — программа для очередного куска готовится заранее, пока карта занята предыдущим.
Попробовать на ноутбуке
Всё, кроме самой карты, работает на обычном ноутбуке:
pip install -e .
pip install pytest torch transformers
python3 -m pytest -q          # для RTL-тестов нужен ещё Verilator 5

hf download LiquidAI/LFM2.5-230M --local-dir models/LFM2.5-230M
otpu-chat --model lfm2 --backend isa    # чат на симуляторе
С картой прошивку собирают командой make bit в каталоге boards/ypcb-00338, заливают по JTAG, выполняют sudo otpu-setup и запускают otpu-chat --backend board. Пошаговый разбор — в docs/board.md.
| Команда | Что делает |
|---|---|
otpu-chat |
чат с Qwen3-0.6B, LFM2.5-230M, Qwen3.5-0.8B, LFM2-2.6B, SmolLM3-3B, Phi-4-mini, Qwen3.5-2B и 4B |
otpu-smi |
температура, потребление, пропускная способность DRAM и загрузка блоков |
otpu-lens |
записать прогон и открыть его в профилировщике |
otpu-selftest, otpu-diag |
проверить, что карта работает |
С чего начать читать
- docs/isa.md — набор команд. Всё остальное построено на нём.
- opentpu/kernels и docs/compiler.md — как ядро становится инструкциями.
- opentpu/isasim.py — симулятор, который и есть спецификация.
- rtl/top/otpu_top.sv — железо, точка входа.
- docs/lfm2.md, docs/qwen35.md, docs/benchmarks.md — модели целиком и их циклы.
- docs/board.md — физическая карта, от тактовых частот до PCIe.
Что дальше и где границы
Проект честно называет свои узкие места.
- Последние проценты по DRAM. Decode упирается в эффективность памяти: чтение идёт на 82–85% пика DDR3-1066. Работа над этим уже идёт.
- Запас по времени и площадь. Дизайн еле-еле сходится на 133.33 MHz — это частота, при которой 128-байтовый порт совпадает по скорости с двумя каналами DDR3. Запас по времени (WNS) всего +0.032 ns. Серия прогонов Vivado продолжает его увеличивать. Поскольку decode ограничен памятью, более быстрые часы помогают в основном prefill.
- Быстрый prefill. Четырёхколоночный систолический матричный блок уже в рабочей прошивке, но prefill всё ещё упирается в скорость умножений этого блока.
Участие в проекте приветствуется, и для большинства задач FPGA не нужна — хватает Python и Verilator. Правки в ISA, симуляторе и RTL не должны ломать тесты python3 -m pytest -q. А утверждения о скорости должны сопровождаться описанием замера.
Лицензия — Apache 2.0, файл LICENSE. Проект вырос из auto-arch-tournament, где ИИ-агенты соревновались в проектировании архитектур.
Источник: https://github.com/FeSens/openTPU