

Firecrawl — API для поиска, скрапинга и взаимодействия с вебом: чистый Markdown и структурированные данные для ИИ-агентов
📂 Исходный код на GitHubВеб-API для поиска, скрапинга и взаимодействия со страницами в масштабе: Search, Scrape, Interact, Agent, Crawl, Map и Batch Scrape. Отдаёт чистый Markdown, структурированный JSON, скриншоты и разбирает PDF и DOCX. Основной код — TypeScript, лицензия AGPL-3.0 (SDK и часть UI — MIT). На момент написания — около 185 тыс. звёзд.
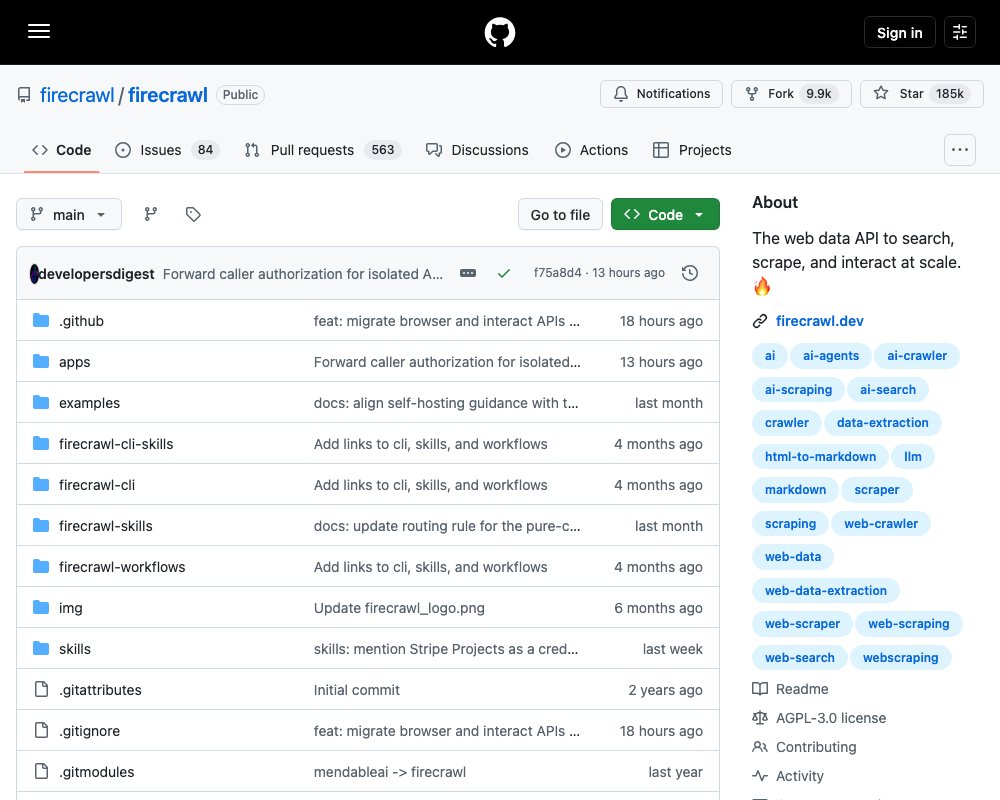
Firecrawl — это API, который ищет, сканирует и взаимодействует с вебом в масштабе. Он превращает страницу в чистый Markdown, структурированный JSON или скриншот — то есть ровно в тот формат, который удобно скормить LLM. Проект open-source (основной код на TypeScript, лицензия AGPL-3.0), у него есть облачный сервис и вариант для self-hosting. На момент написания — около 185 тысяч звёзд на GitHub.
Смысл в том, чтобы не писать свой краулер. Firecrawl сам решает то, что обычно и отнимает всё время: ротирующие прокси, JS-тяжёлые страницы, блокировки, рейт-лимиты, обход очередей и rate limits. По заявлению разработчиков, покрытие веба — 96% страниц, а P95-латентность — 3,4 секунды на миллионах страниц.
Зачем это нужно
- Готовый вход для LLM. Markdown, JSON, скриншоты — меньше токенов на ерунду, больше на полезный текст.
- JS-страницы. Страницы, которые рендерятся в браузере, обрабатываются без ручной настройки прокси.
- Actions. Перед извлечением можно кликнуть, прокрутить, ввести текст, подождать и нажать кнопку.
- Медиа. Разбирает и извлекает содержимое из PDF, DOCX и других файлов, размещённых в вебе.
- Open-source. Код в репозитории, можно форкнуть, доработать и поднять у себя.
Основные эндпоинты
| Эндпоинт | Что делает |
|---|---|
| Search | Ищет в вебе и сразу отдаёт полное содержимое найденных страниц |
| Scrape | Конвертирует один URL в Markdown, HTML, скриншоты или JSON |
| Interact | Скрапит страницу, а потом управляет ею AI-промптом или кодом |
| Agent | Описываете задачу текстом — агент сам ищет, переходит по страницам и приносит данные |
| Crawl | Обходит весь сайт одним запросом |
| Map | Мгновенно отдаёт все URL сайта |
| Batch Scrape | Асинхронно обрабатывает тысячи URL |
Ключ API берётся на firecrawl.dev, поиграться можно в playground.
Scrape: страница в Markdown
Python:
from firecrawl import Firecrawl

app = Firecrawl(api_key="fc-YOUR_API_KEY")

result = app.scrape('firecrawl.dev')
Node.js:
import { Firecrawl } from 'firecrawl';

const app = new Firecrawl({ apiKey: "fc-YOUR_API_KEY" });

app.scrape('firecrawl.dev')
cURL:
curl -X POST 'https://api.firecrawl.dev/v2/scrape' \
-H 'Authorization: Bearer fc-YOUR_API_KEY' \
-H 'Content-Type: application/json' \
-d '{
  "url": "firecrawl.dev"
}'
CLI:
firecrawl scrape https://firecrawl.dev
firecrawl https://firecrawl.dev --only-main-content
На выходе — Markdown без мусора:
# Firecrawl

Firecrawl helps AI agents search, scrape, and interact with the web.

## Features
- Search: Find information across the web
- Scrape: Clean data from any page
- Interact: Click, navigate, and operate pages
- Agent: Autonomous data gathering
Search: результаты с полным содержимым
search_result = app.search("firecrawl", limit=5)curl -X POST 'https://api.firecrawl.dev/v2/search' \
-H 'Authorization: Bearer fc-YOUR_API_KEY' \
-H 'Content-Type: application/json' \
-d '{
"query": "firecrawl",
"limit": 5
}'firecrawl search "firecrawl" --limit 5Ответ содержит и ссылку, и текст страницы:
[
  {
    "url": "https://firecrawl.dev",
    "title": "Firecrawl",
    "markdown": "Turn websites into..."
  }
]
Interact: управление страницей
Сначала скрапите страницу, потом отправляйте промпты, опираясь на полученный scrape_id:
result = app.scrape("https://amazon.com")
scrape_id = result.metadata.scrape_id

app.interact(scrape_id, prompt="Search for 'mechanical keyboard'")
app.interact(scrape_id, prompt="Click the first result")
# 1. Scrape the page
curl -X POST 'https://api.firecrawl.dev/v2/scrape' \
-H 'Authorization: Bearer fc-YOUR_API_KEY' \
-H 'Content-Type: application/json' \
-d '{"url": "https://amazon.com"}'
# 2. Interact with the page (use scrapeId from step 1)
curl -X POST 'https://api.firecrawl.dev/v2/scrape/SCRAPE_ID/interact' \
-H 'Authorization: Bearer fc-YOUR_API_KEY' \
-H 'Content-Type: application/json' \
-d '{"prompt": "Search for mechanical keyboard"}'Ответ может включать ссылку на живое представление страницы:
{
  "success": true,
  "output": "Keyboard available at $100",
  "liveViewUrl": "https://liveview.firecrawl.dev/..."
}
Agent: URL знать не нужно, достаточно промпта
Эндпоинт /v2/agent — эволюция старого /extract. URL знать не нужно: агент сам ищет, переходит по страницам и собирает данные.
curl -X POST 'https://api.firecrawl.dev/v2/agent' \
  -H 'Authorization: Bearer fc-YOUR_API_KEY' \
  -H 'Content-Type: application/json' \
  -d '{
    "prompt": "Find the pricing plans for Notion"
  }'
{
"success": true,
"data": {
"result": "Notion offers the following pricing plans:\n\n1. Free - $0/month...",
"sources": ["https://www.notion.so/pricing"]
}
}Структурированный вывод задаётся схемой:
from firecrawl import Firecrawl
from pydantic import BaseModel, Field
from typing import List, Optional

app = Firecrawl(api_key="fc-YOUR_API_KEY")

class Founder(BaseModel):
    name: str = Field(description="Full name of the founder")
    role: Optional[str] = Field(None, description="Role or position")

class FoundersSchema(BaseModel):
    founders: List[Founder] = Field(description="List of founders")

result = app.agent(
    prompt="Find the founders of Firecrawl",
    schema=FoundersSchema
)

print(result.data)
Можно сузить область поиска конкретными страницами:
result = app.agent(
    urls=["https://docs.firecrawl.dev", "https://firecrawl.dev/pricing"],
    prompt="Compare the features and pricing information"
)
Effort и модель
effort задаёт, сколько рассуждений агент тратит на задачу. Модель при этом одна и та же — spark-2.
| Effort | Для чего |
|---|---|
low |
Простые запросы к одному сайту |
medium |
Многошаговые задачи на нескольких страницах |
high |
Глубокое исследование, сложная навигация, критичные данные |
Параметр model остаётся поддерживаемым, но это legacy-режим. Отправлять model и effort одновременно нельзя — будет ошибка 400.
| Модель | Стоимость | Для чего |
|---|---|---|
spark-1-mini |
на 60% дешевле | большинство задач |
spark-1-pro (по умолчанию) |
стандарт | сложные исследования, сбор данных с нескольких сайтов |
spark-2 |
см. pricing | модель, на которой работает effort |
Если не передать ни model, ни effort, запустится spark-1-pro. Подробности — в документации по агенту.
Crawl и Map: весь сайт целиком
Crawl запускает асинхронную задачу и возвращает её ID:
curl -X POST 'https://api.firecrawl.dev/v2/crawl' \
-H 'Authorization: Bearer fc-YOUR_API_KEY' \
-H 'Content-Type: application/json' \
-d '{
  "url": "https://docs.firecrawl.dev",
  "limit": 100,
  "scrapeOptions": {
    "formats": ["markdown"]
  }
}'
{
"success": true,
"id": "123-456-789",
"url": "https://api.firecrawl.dev/v2/crawl/123-456-789"
}Статус забирается отдельным запросом:
curl -X GET 'https://api.firecrawl.dev/v2/crawl/123-456-789' \
-H 'Authorization: Bearer fc-YOUR_API_KEY'
SDK делают поллинг автоматически, так что в коде достаточно одного вызова:
docs = app.crawl("https://docs.firecrawl.dev", limit=50)Map отвечает мгновенно и просто перечисляет адреса:
curl -X POST 'https://api.firecrawl.dev/v2/map' \
-H 'Authorization: Bearer fc-YOUR_API_KEY' \
-H 'Content-Type: application/json' \
-d '{"url": "https://firecrawl.dev"}'
result = app.map("https://firecrawl.dev", search="pricing")
# URLs ordered by relevance to S2Подключение к агентам
Скилл ставится одной командой:
npx -y firecrawl-cli@latest init --all --browserПосле установки агента нужно перезапустить. Заявлена совместимость с Claude Code, Antigravity, OpenCode и другими.
Через MCP всё ещё проще:
{
  "mcpServers": {
    "firecrawl-mcp": {
      "command": "npx",
      "args": ["-y", "firecrawl-mcp"],
      "env": {
        "FIRECRAWL_API_KEY": "fc-YOUR_API_KEY"
      }
    }
  }
}
Сам агент тоже умеет подключаться: есть готовый файл с инструкцией по регистрации и получению ключа — curl -s https://firecrawl.dev/agent-onboarding/SKILL.md. Все команды CLI и скиллов описаны в документации, по MCP — в репозитории firecrawl-mcp-server.
SDK на девять языков
| Язык | Установка |
|---|---|
| Python | pip install firecrawl-py |
| Node.js | npm install firecrawl |
| Go | go get github.com/firecrawl/firecrawl/apps/go-sdk |
| Java | com.github.firecrawl:firecrawl-java-sdk:2.0 |
| Elixir | {:firecrawl, "~> 1.0"} |
| Rust | firecrawl = "2" |
| Ruby | gem install firecrawl-sdk |
| .NET | dotnet add package firecrawl-sdk |
| PHP | composer require firecrawl/firecrawl-sdk |
Один и тот же сценарий на Python и PHP выглядит почти одинаково:
doc = app.scrape("https://firecrawl.dev", formats=["markdown"])
print(doc.markdown)

result = app.agent(prompt="Find the founders of Stripe")
print(result.data)
$doc = $client->scrape('https://firecrawl.dev', ScrapeOptions::with(
formats: ['markdown'],
));
echo $doc->getMarkdown();
$results = $client->search('best AI data tools 2024', SearchOptions::with(limit: 10));Open-source против облака
Ядро проекта — под AGPL-3.0, SDK и часть UI-компонентов — под MIT. Облачная версия на firecrawl.dev добавляет возможностей, которых нет в open-source-варианте. Локальный запуск описан в Contributing Guide, self-hosting — в руководстве по self-hosting. Полный текст лицензии — LICENSE.
Экосистема
- Каталог скиллов Firecrawl — ставится через
npx skills add firecrawl/skills - Firecrawl CLI
- Firecrawl MCP
- Платформы: Lovable, Zapier, n8n
- Полный список интеграций — на сайте
Скиллы для интеграции Firecrawl в продуктовый код пишутся прямо в этом репозитории, в каталоге skills/, и автоматически зеркалируются в каталог CI-процессом.
Практическая сторона
По данным разработчиков, покрытие веба — 96% страниц, включая JS-тяжёлые, а P95-латентность — 3,4 секунды. Подробности методики и замеров — в бенчмарке.
Отдельно стоит юридический момент: по умолчанию Firecrawl уважает директивы robots.txt. Ответственность за соблюдение политик сайтов и условий использования лежит на конечном пользователе.
Документация: docs.firecrawl.dev · API Reference · Changelog
Источник: https://github.com/firecrawl/firecrawl