

Maxun — open-source платформа, которая превращает любой сайт в структурированный API
📂 Исходный код на GitHubOpen-source веб-платформа для скрейпинга, краулинга, поиска, мониторинга и AI-извлечения данных: роботы на базе браузерной автоматизации, дашборд, API, SDK, CLI и MCP. Лицензия AGPLv3, ~17.5k звёзд.
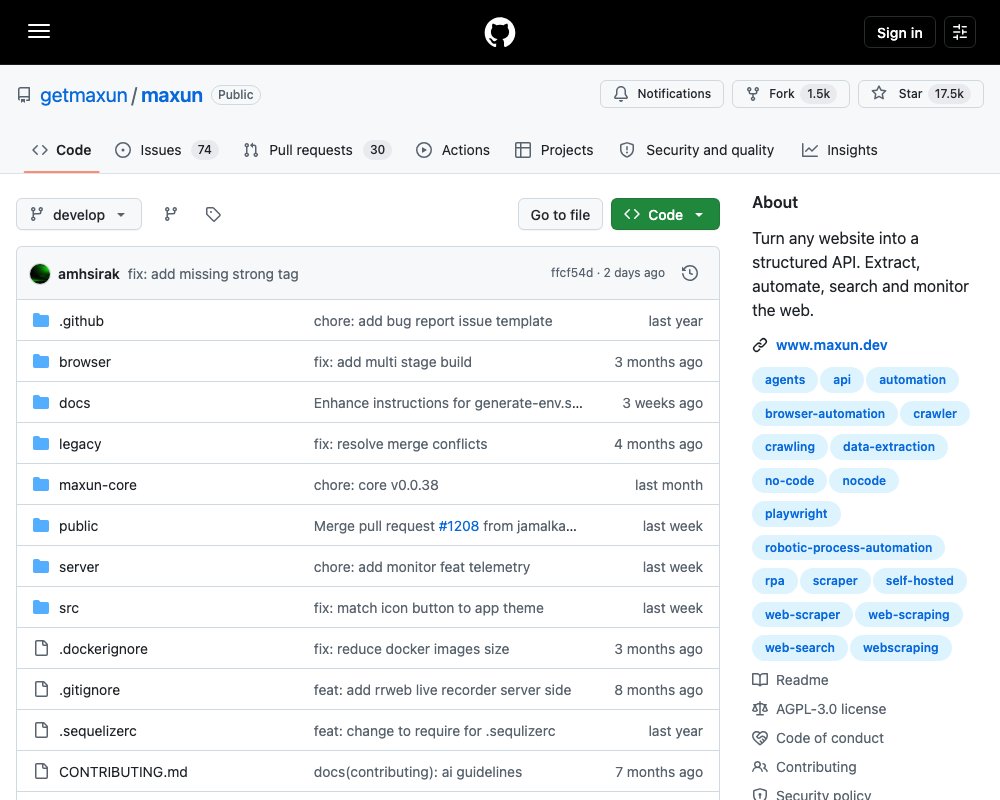
Maxun — open-source веб-платформа со слоганом «Turn Any Website Into A Structured API»: скрейпинг, краулинг, поиск, мониторинг и AI-извлечение данных в одном инструменте. Проект позиционирует себя как open-source платформа веб-данных для real-time задач — сбора, поиска и наблюдения за вебом. На GitHub — около 17.5k звёзд, 1.5k форков и 7.6k коммитов; преобладающий язык — TypeScript, лицензия AGPLv3. Есть hosted-версия на app.maxun.dev, официальный сайт www.maxun.dev и документация. Среди тегов репозитория: browser-automation, crawler, data-extraction, no-code, playwright, rpa, scraper, self-hosted, web-scraping.
Идея проста: вместо ручного написания парсеров и XPath-селекторов под каждый сайт вы строите «роботов» — визуально в дашборде или описанием задачи на естественном языке, — а затем получаете структурированные данные, Markdown, скриншоты и API-доступ к вебу. Роботы имитируют реальное поведение пользователя в браузере, поэтому платформа подходит и для динамических страниц, которые не отдаются обычным HTTP-запросом.
Что умеет Maxun
- Extract (документация) — извлечение структурированных данных с любого сайта имитацией реального поведения пользователя. Два режима записи:
- Recorder Mode (детали) — записываете действия в браузере (клики, переходы, прокрутку), и они превращаются в переиспользуемых роботов извлечения: заскриптовали один раз, запускаете сколько нужно;
- AI Mode (детали) — описываете нужные данные обычным языком, структурированное извлечение делает AI. Полезно, когда селекторы заранее неизвестны или разметка сайта часто меняется.
- Scrape (документация) — конвертация целых веб-страниц в Markdown и HTML плюс захват скриншотов. Готовый сценарий «страница → контент для LLM» без отдельного парсинг-слоя.
- Crawl (документация) — обход целых сайтов и извлечение контента по страницам: когда данных нужно больше, чем с одной URL.
- Search (документация) — поиск в вебе с фильтрами по времени и извлечением результатов: веб-данные по запросу, а не только по известным ссылкам.
- Monitoring (документация) — отслеживание сайтов во времени, детекция изменений и уведомления о них: классический use-case мониторинга конкурентов, цен, вакансий или документации.
- Document Extraction & Parsing (документация) — извлечение и парсинг структурированных данных из документов, а не только со страниц.
Как использовать
| Интерфейс | Что даёт |
|---|---|
| Dashboard | Визуальная сборка, запуск и управление роботами |
| API | Встраивание скрейпинга и извлечения в свои приложения |
| SDK | Программное использование для скрейпинга, извлечения, автоматизации и работы с роботами |
| CLI | Создание роботов, запуск задач и получение данных из терминала |
| MCP | Подключение Maxun к AI-агентам через Model Context Protocol |
Дашборд — основной вход для no-code-сценария: собрали робота мышкой, запустили, посмотрели результаты. API и SDK нужны, когда Maxun становится частью бэкенда или ETL-пайплайна. CLI удобен для локальных прогонов и скриптов. MCP-интерфейс важен в контексте AI-инструментов: агент может дергать роботов Maxun как инструмент и получать живые веб-данные, не реализуя собственный скрейпинг-слой с прокси, рендером JS и антибот-обходом.
Быстрый старт
Самый простой и быстрый путь — hosted-версия: https://app.maxun.dev. Ничего не нужно устанавливать: заводите аккаунт и работаете в облаке.
Локальный запуск — с Docker или без него:
Для self-hosting и дальнейших обновлений:
Кому это подойдёт
- Продуктовым и аналитическим командам, которым нужны структурированные данные со сайтов (цены, каталоги, вакансии, контент) без отдельной разработки парсера под каждый источник.
- Владельцам мониторинга: режим Monitoring закрывает цикл «обнаружить изменение → получить уведомление», то есть не только собрать данные один раз, но и следить за ними постоянно.
- Разработчикам, которые встраивают веб-данные в свои сервисы: есть API, SDK и CLI — Maxun можно поставить как отдельный data-сервис в инфраструктуре.
- Командам с AI-агентами: через MCP агент получает инструменты извлечения и поиска по вебу, не собирая собственный скрейпинг-стек.
- Тем, кому важен контроль: рядом с hosted-версией доступен полный self-hosted-вариант — данные и расписание остаются на вашей стороне.
Из репозитория видно, что проект активно развивается: тысячи коммитов, Dockerfile для фронтенда и бэкенда, docker-compose, отдельные каталоги docs, server, browser и maxun-core. Такая структура типична для продуктов, которые переходят из «полезного утилитного репозитория» в полноценную платформу с API и интерфейсами для разных ролей.
Лицензия и ценности проекта
Лицензия — AGPLv3 (файл LICENSE). Авторы прямо заявляют позицию: они верят в честное и ответное использование open source — если проект используется коммерчески, стоит внести вклад в его развитие или поддержать авторов. Помочь можно и звёздой репозитория, и contribution в код. Учтите AGPLv3 до того, как встраивать Maxun в закрытый коммерческий продукт: это сильная copyleft-лицензия.
Итог
Maxun закрывает сценарий «сайт → структурированные данные/API» без ручного написания селекторов под каждый проект: запись действий в браузере или AI-описание задачи — затем скрейпинг, краулинг, поиск, парсинг документов и мониторинг с уведомлениями об изменениях. Пять интерфейсов — визуальный дашборд, API, SDK, CLI и MCP — позволяют встроить его и в веб-продукт, и в терминальный пайплайн, и в AI-агента. Если нужен self-hosted инструмент веб-данных с открытым кодом, Playwright-базой и живым сообществом, Maxun — сильный кандидат: AGPLv3, TypeScript-база, Docker-first установка и hosted-вариант для быстрого старта без инфраструктуры.
Источник: https://github.com/getmaxun/maxun