

Machine Learning Systems — открытый учебник по ML-системам от Гарварда
📂 Исходный код на GitHubОткрытый учебник Machine Learning Systems от Гарварда: четыре тома о проектировании ML-систем плюс TinyTorch, симулятор MLSys·im, лаборатории и наборы для работы с железом.
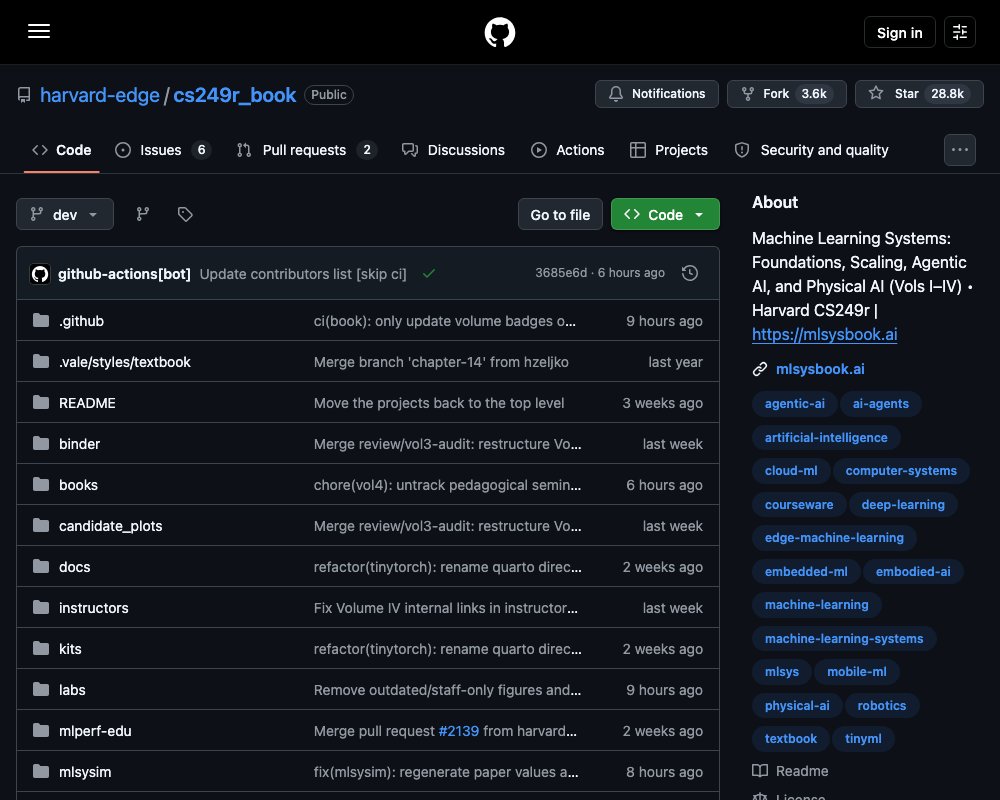
Machine Learning Systems — открытый учебник по проектированию систем машинного обучения. Его написал Виджай Джанапа Редди (Vijay Janapa Reddi), профессор Гарварда. Книга выросла из университетского курса CS249r. Весь материал бесплатен: читать можно онлайн на mlsysbook.ai, исходники открыты на GitHub. В 2026 году выйдет печатное издание — его выпустит MIT Press.
Миссия проекта сформулирована жёстко: «Мир спешит строить ИИ-системы, но не проектирует их». Пробел между «строить» и «проектировать» авторы и называют AI engineering. Цель амбициозная — помочь 100 000 учащихся освоить ML-системы за год, а к 2030 году довести число до миллиона.
Что такое AI engineering
Центральная мысль книги проста: модель — это ещё не система. Модель нужно обучить, разместить на железе, обслуживать под нагрузкой и следить за качеством, пока мир вокруг меняется. Классические книги по глубокому обучению заканчиваются на модели. Эта книга начинается там, где они заканчиваются.
AI engineering авторы определяют как дисциплину о создании эффективных, надёжных и безопасных интеллектуальных систем, которые работают в реальном мире. Они хотят поставить её в один ряд с разработкой ПО и компьютерной инженерией.
Четыре тома
Серия построена как последовательность из четырёх книг. Каждый следующий том расширяет границы системы, о которой идёт речь.
| Том | Статус | О чём |
|---|---|---|
| Том I. Основы | Вышел | Как интеллектуальная система работает на одной машине: данные, обучение, инференс, оценка, развёртывание |
| Том II. Масштабирование | Предпросмотр | Распределённое обучение, ускорители, память, параллелизм, надёжность на уровне датацентров |
| Том III. Агентные системы | В разработке | Циклы «рассуждение — действие», память, инструменты, планирование, MCP, многоагентные системы |
| Том IV. Физический ИИ | В разработке | Сенсоры, восприятие, модели мира, роботы, ограничения реального времени, безопасность |
Том I уже доступен онлайн: Vol I. Том II открыт как предпросмотр: Vol II. Тома III и IV ещё пишутся, их можно читать в текущем виде на GitHub: Vol III и Vol IV. Авторы честно предупреждают: эти две части быстро меняются, цитировать и преподавать по ним пока рано.
Для аудитории этого сайта особенно интересен третий том. Он про то, как управлять ИИ, который действует автономно: иерархии памяти контекста, протоколы вызова инструментов вроде MCP, песочницы, восстановление после сбоев.
Связь между томами выстроена логично. Том I отвечает за модель на одном узле. Том II переносит её на тысячи ускорителей. Том III добавляет состояние и автономность: агент совершает много шагов, а не отвечает одним запросом. Том IV выводит ИИ из цифрового мира в физический, где ошибка стоит необратимо дорого.
Не только книга
Ключевая идея проекта: «репозиторий — это и есть учебная программа». Текст даёт ментальные модели, а остальное заставляет строить руками.
- TinyTorch — вы собираете собственный ML-фреймворк с нуля за 20 модулей. Авторы считают, что систему нельзя понять, пока не построил её сам.
- Labs — интерактивные ноутбуки Marimo. Меняете параметр и видите, что ломается.
- MLSys·im — симулятор инфраструктуры. Считает узкие места по памяти, насыщение сети и пределы планировщика там, где реальный кластер вам не по карману.
- Hardware Kits — лаборатории на Arduino, Seeed и Raspberry Pi. Настоящие лимиты памяти, энергии и задержки.
- StaffML — вопросы с собеседований по ML-системам. База вопросов, тренажёр и пробные интервью.
Каждый компонент живёт по своей лицензии. Учебник — CC BY-NC-SA 4.0, TinyTorch — MIT, симулятор — Apache 2.0, StaffML — AGPL v3. Полные условия описаны в LICENSE.md и на странице лицензий.
Для преподавателей
Проект задуман не только для самоучек. Преподавателям предлагают AI Engineering Blueprint: два готовых 16-недельных плана курса, руководство по методике, критерии оценки и справочник для ассистентов. Есть слайды к каждой главе в четырёх темах оформления и рассылка с новостями учебной программы.
Чему учит книга
Каждая глава связывает алгоритмы с инфраструктурой, на которой они работают. Несколько примеров из книги:
| Вы знаете | Вы узнаете |
|---|---|
| Как обучить модель | Как обучение масштабируется на GPU-кластеры |
| Что квантизация сжимает модели | Как арифметика INT8 ложится на кремний |
| Что такое трансформер | Почему KV-cache съедает память при инференсе |
| Что модели работают на GPU | Как планировщики балансируют задержку и пропускную способность |
| Что у edge-устройств есть лимиты | Как совместно проектировать модель и железо |
Чем это не «ещё одна книга по ML»
В FAQ авторы аккуратно разводят три близких жанра.
Книги по глубокому обучению (Goodfellow, d2l.ai, fast.ai) учат проектировать и обучать модели. Эта книга начинается после: модель здесь — один компонент большой системы с бюджетами на энергию и задержку.
Книги по MLOps — это инструкции по сборке: как подключить feature store, пайплайн и настроить развёртывание на сегодняшних инструментах. Этот учебник учит слой ниже: физику и количественные оценки, которые объясняют, почему эти инструменты вообще существуют. Авторы сравнивают это с рецептом и пониманием готовки. Рецепт работает, пока не изменилась кухня. Понимание позволяет готовить на любой.
Классические справочники вроде «The Datacenter as a Warehouse-Scale Computer» описывают одну готовую систему. Этот проект — учебная программа: с задачами, примерами с расчётами и лабораториями. Он нейтрален к вендорам и постоянно обновляется.
Отдельный вопрос — зачем учебник в эпоху LLM. Ответ авторов: книга даёт перспективу, а не поиск фактов. Она выстраивает знания в правильном порядке и учит, какие вопросы вообще стоит задавать. Со ссылкой на статью Textbooks in Tokenland они формулируют так: книга передаёт модель мира от человека к человеку, а хороший LLM помогает отвечать на вопросы, которые эта книга научила задавать.
С чего начать
Порядок действий из README:
- Прочитайте том I или сразу откройте том II, если основы уже знаете.
- Выберите практический путь: соберите фреймворк в TinyTorch, поэкспериментируйте в лабораториях, посчитайте ограничения в симуляторе или разверните модель на железе из Kits.
- Проверьте себя на StaffML.
- Преподавателям — Blueprint и слайды.
Учебный цикл проекта звучит так: читай → исследуй → строй → моделируй → внедряй → тренируйся → преподавай.
Учебник переведён на китайский, японский и корейский: китайский, японский, корейский. Русского перевода пока нет. Вопросы обсуждают в Issues и Discussions, поддержку проект принимает через Open Collective.