

Qlib — открытая платформа Microsoft для количественных инвестиций на базе AI
📂 Исходный код на GitHubОткрытая AI-платформа Microsoft для количественных инвестиций: полный конвейер машинного обучения от данных до бэктеста, десятки готовых моделей и интеграция с LLM-агентами RD-Agent.
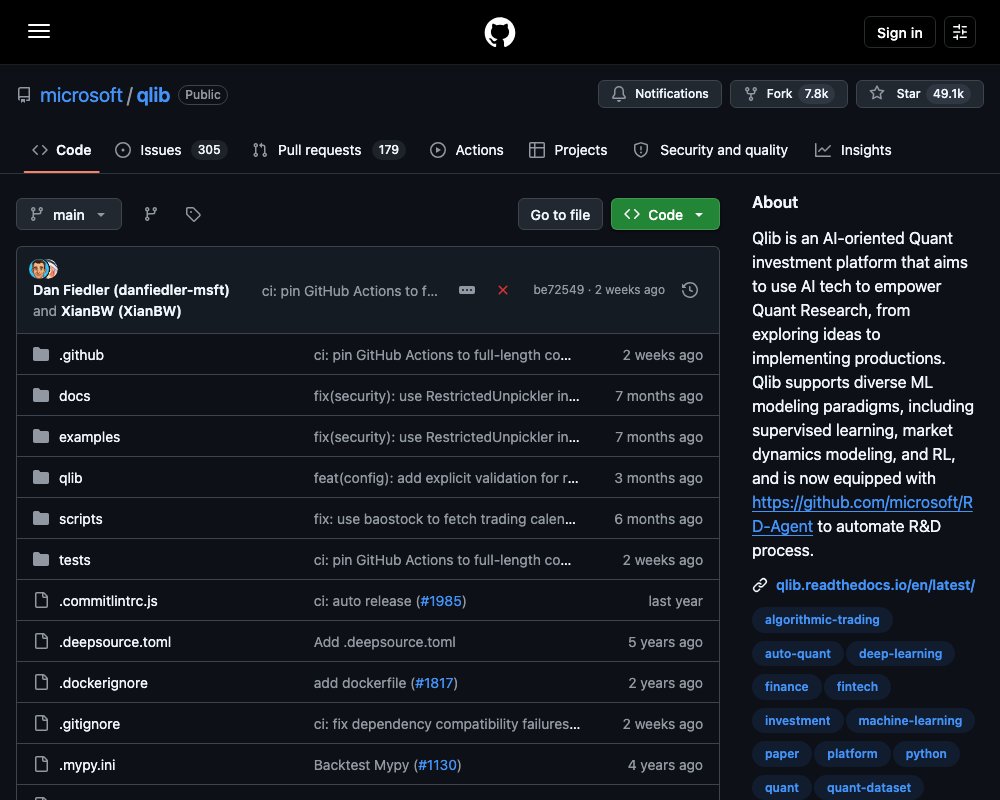
Qlib — открытая платформа Microsoft для количественных инвестиций (quant). Она построена вокруг машинного обучения и закрывает весь цикл работы квант-исследователя: от обработки данных до обучения модели, бэктеста и вывода стратегии на реальные торги. Проект развивает Microsoft Research. До сентября 2020 года Qlib был внутренним инструментом, затем его опубликовали под лицензией MIT. Название пакета в PyPI — pyqlib.
Что такое Qlib
Платформа поддерживает три парадигмы машинного обучения, каждая закрывает свою задачу квант-исследований:
- Обучение с учителем. Поиск сложных нелинейных закономерностей в разнородных финансовых данных.
- Моделирование динамики рынка. Распределение данных меняется со временем, и модели нужно подстраиваться под эти сдвиги.
- Обучение с подкреплением (RL). Моделирование непрерывных решений, например оптимизация исполнения заявок.
Конвейер охватывает всю цепочку количественных инвестиций: поиск альфа-сигналов, моделирование риска, оптимизацию портфеля и исполнение ордеров. Внутри — обработка данных, обучение моделей и бэктест.
Архитектура модульная. Компоненты слабо связаны друг с другом, и каждый можно использовать отдельно: взять только хранилище данных или только фреймворк для RL. Дизайн платформы описан в научной статье «Qlib: An AI-oriented Quantitative Investment Platform».
Установка и быстрый старт
Поддерживаются Python 3.8–3.12. Авторы рекомендуют ставить пакет в окружение conda: без него при сборке иногда не хватает системных заголовков. Самый простой путь:
pip install pyqlibВетка main активно развивается, поэтому для свежих возможностей пакет ставят из исходников:
git clone https://github.com/microsoft/qlib.git && cd qlib
pip install .
Есть и готовые Docker-образы на Docker Hub — pyqlib/qlib_image_stable:stable. Пользователям Mac на чипах M1 понадобится brew install libomp перед сборкой, иначе не соберётся LightGBM.
Данные
Из-за ужесточённой политики безопасности официальный датасет временно отключён. Вместо него авторы предлагают источник данных от сообщества:
wget https://github.com/chenditc/investment_data/releases/latest/download/qlib_bin.tar.gz
mkdir -p ~/.qlib/qlib_data/cn_data
tar -zxvf qlib_bin.tar.gz -C ~/.qlib/qlib_data/cn_data --strip-components=1
В репозитории есть скрипты-краулеры, которые собирают данные с Yahoo Finance и конвертируют их в формат Qlib. Данные Yahoo неидеальны, поэтому для серьёзной работы платформа советует готовить свой датасет: документы описывают конвертацию из CSV. Отдельный скрипт проверяет здоровье данных — пропуски и аномальные скачки цен.
Автоматический workflow: qrun
Утилита qrun запускает полный цикл по одному YAML-конфигу: строит датасет, обучает модель, делает бэктест и оценку.
cd examples
qrun benchmarks/LightGBM/workflow_config_lightgbm_Alpha158.yaml
На выходе — таблица метрик: средняя избыточная доходность, годовая доходность, information ratio и максимальная просадка, отдельно с учётом комиссий и без. Для визуальных отчётов есть Jupyter-блокнот workflow_by_code.ipynb: он строит графики кумулятивной доходности по группам, распределения доходностей и коэффициента информации (IC).
Если готовый workflow не подходит, те же шаги собирают вручную через Python API — компоненты можно комбинировать как угодно.
Зоопарк моделей
В каталоге examples/benchmarks собраны десятки готовых моделей с конфигами и бенчмарками:
- GBDT: XGBoost, LightGBM, CatBoost.
- Классические нейросети: MLP, LSTM, GRU, ALSTM, TCN, Transformer, Localformer, TabNet.
- Графовые и гибридные: GATs, SFM, HIST.
- Модели из свежих статей: TRA, TCTS, DoubleEnsemble, ADARNN, ADD, IGMTF, KRNN, Sandwich.
Базовые датасеты признаков — Alpha158 и Alpha360. Они работают и для рынка США, и для рынка Китая. Метрики каждой модели на этих датасетах сведены в таблицу в README каталога benchmarks.
Скрипт run_all_model.py прогоняет сразу все модели. Для каждой он создаёт отдельное виртуальное окружение и удаляет его после обучения — остаются только результаты: значения IC и бэктеста. Скрипт пока работает только на Linux.
Динамика рынка и обучение с подкреплением
Финансовые данные нестационарны. Модель, обученная на одном периоде, теряет качество на другом. Qlib даёт два готовых подхода: регулярное дообучение (Rolling Retraining) и метод DDG-DA на основе мета-обучения, опубликованный на AAAI 2022.
RL-фреймворк решает другую задачу — непрерывные решения. Главный сценарий — исполнение заявок (order execution): как крупный ордер разложить на мелкие сделки, чтобы не двигать рынок. В комплекте бенчмарки TWAP, PPO и OPDS. Поддерживается NestedExecutor: стратегии разных уровней — например, управление портфелем и исполнение заявок внутри него — оптимизируются вместе.
Хранилище данных и производительность
Обычные базы данных плохо подходят для ML-задач в финансах. Данные проходят слишком много слоёв интерфейсов и лишних преобразований форматов — загрузка тормозит. Qlib хранит данные в компактном формате, который быстро собирается в массивы для научных вычислений.
Авторы сравнили своё хранилище с популярными решениями на одной задаче: собрать датасет из 14 признаков по дневным данным 800 акций за 2007–2020 годы.
| Решение | Время (1 CPU) |
|---|---|
| HDF5 | 184,4 с |
| MySQL | 365,3 с |
| MongoDB | 253,6 с |
| InfluxDB | 368,2 с |
| Qlib с кешами выражений и датасетов | 7,4 с |
Сервер данных работает в двух режимах. В offline-режиме данные лежат локально — это вариант по умолчанию. В online-режиме данные и кеш разделяются между всеми клиентами как общий сервис. Так растёт доля попаданий в кеш и экономится место на диске. Online-режим разворачивается автоматически скриптами на основе Azure CLI.
RD-Agent: LLM-агенты для квант-исследований
Самая свежая часть экосистемы — RD-Agent. Это отдельный проект Microsoft: LLM-агенты автономно ведут исследования и разработки. В связке с Qlib они автоматически ищут новые факторы и оптимизируют модели — авторы называют это Auto Quant Factory.
Подход описан в статье R&D-Agent-Quant: мультиагентный фреймворк одновременно оптимизирует факторы и модели. На YouTube есть демо всех трёх сценариев: поиск факторов, извлечение факторов из исследовательских отчётов и оптимизация моделей.
Здесь и смыкаются два мира: классический ML-конвейер Qlib и агентные системы на LLM. Квант-исследование превращается из ручного труда в задачу, которую ставят и направляют, а выполняют агенты.
Кому стоит посмотреть
- Квант-исследователям и аналитикам — как единая основа для экспериментов с воспроизводимыми бенчмарками.
- Инженерам по данным — как пример быстрого специализированного хранилища временных рядов.
- ML-инженерам — как справочник реализаций моделей из свежих статей по финансам.
- Разработчикам агентных систем — как пример предметной области, где LLM-агенты уже автоматизируют полный цикл R&D.
Документация доступна онлайн на qlib.readthedocs.io, там же инструкции по сборке из исходников. Обучающие блокноты лежат в каталоге examples/tutorial. План развития ведётся как GitHub-проект, вопросы принимают через issues и чат Gitter.
Источник: https://github.com/microsoft/qlib