

Kev — компактные модели принятия решений на базе Qwen3.5
📂 Исходный код на GitHubСемейство компактных моделей принятия решений, построенных на Qwen3.5, с возможностью самостоятельного обучения и запуска
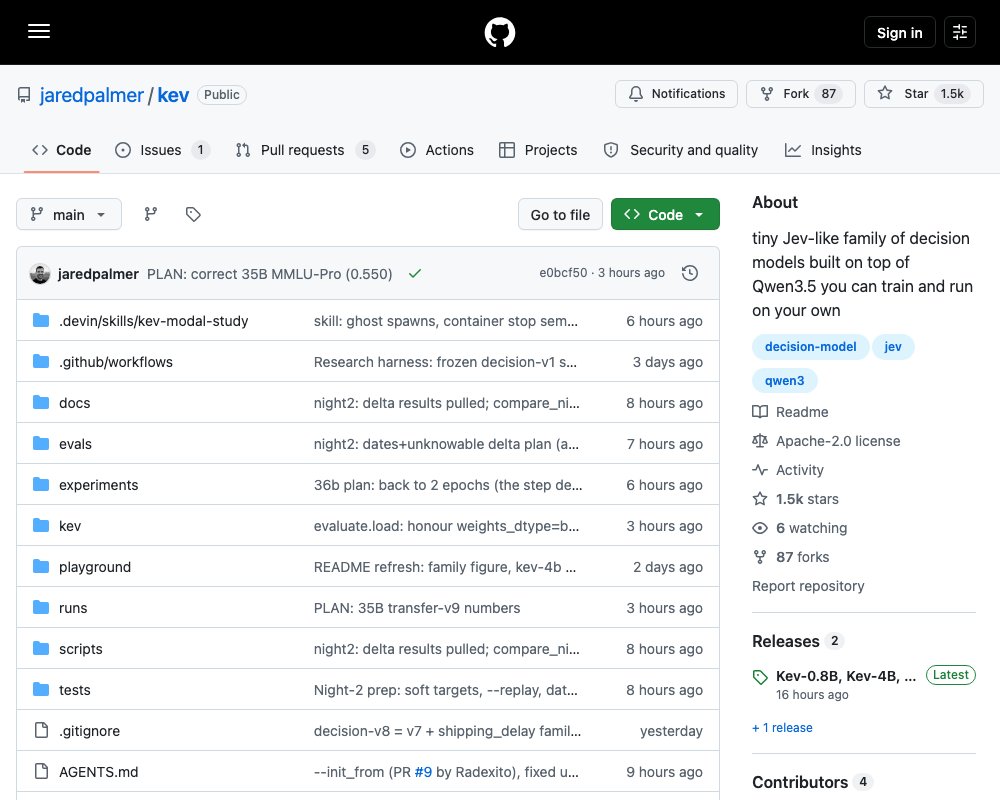
Kev — это семейство компактных моделей принятия решений, построенных на базе Qwen3.5. Автор проекта — Jared Palmer (создатель React Query и TanStack). Модели решают задачи классификации тикетов, маршрутизации обращений, оценки тональности и других сценариев, где нужна вероятностная оценка вместо однозначного ответа. Веса опубликованы, код обучения открыт, API совместим с TypeSafe System One.
Типы задач
Kev поддерживает три типа вопросов в одном запросе:
- noul — бинарный ответ да/нет с вероятностью (подходит для триггеров типа «нужна ли эскалация?»)
- choice — множественный выбор из 1–255 вариантов с вероятностями по каждому
- score — рейтинговая оценка по шкале от 2 до 255 уровней
Ключевая особенность — вопросам передаётся общий текст (state), но они не видят результатов друг друга. Это гарантирует изоляцию: классификация отдела не влияет на оценку тональности.
Модели
| Модель | База | Точность (train) | Точность (new sources) | Brier (new) |
|---|---|---|---|---|
| Kev-0.8B | Qwen3.5-0.8B-Base | 0.829 | 0.643 | 0.513 |
| Kev-4B | Qwen3.5-4B-Base | 0.877 | 0.794 | 0.316 |
| Kev-9B | Qwen3.5-9B-Base | 0.876 | 0.812 | 0.291 |
Для сравнения: hosted-модель Jev показывает 0.857 на new sources. Kev-9B отстаёт на ~4.5 п.п., но это open-weight модель с полным контролем над данными и обучением.
Старое поколение на Qwen3 (0.6B, 4B, 8B) всё ещё доступно и работает быстрее на Apple Silicon — на Mac модели Qwen3.5 из-за отсутствия быстрых ядер для DeltaNet-слоёв отрабатывают в разы дольше.
Запуск и API
Минимальный стек: Python 3.12+, uv, CUDA или Apple Silicon. Сервер поднимается одной командой:
uv sync --extra serve
KEV_DTYPE=bf16 uv run --extra serve python -m kev.serve --run jaredpalmer/kev-4b --port 8009
Пример запроса — маршрутизация тикета поддержки:
{
  "state": "Shoes arrived two weeks late and in the wrong size. Also I see two charges on my card.",
  "model": "kev-latest",
  "questions": {
    "department": {"type": "choice", "instructions": "Which team should handle this?",
                   "criteria": {"returns": "Exchanges, refunds", "shipping": "Delivery delays", "billing": "Charges, invoices"}},
    "escalate":   {"type": "noul",  "instructions": "Does this need urgent human attention?"},
    "frustration":{"type": "score", "instructions": "How frustrated is the customer?",
                   "criteria": ["Calm", "Frustrated", "Very angry"]}
  }
}
Ответ содержит вероятности по каждому варианту, confidence и latency. Для Python-интеграции есть SDK TypeSafe, совместимый с тем же сервером.
Обучение и fine-tuning
Базовое обучение с нуля:
uv run python -m kev.train --suite evals/v7/decision-v7 --base Qwen/Qwen3.5-4B-Base \
    --epochs 2 --lr 5e-5 --batch 4 --accum 2 --dtype bf16 --device cuda --out runs/kev-4b
Для адаптации под свой домен (свои категории маршрутизации, свои правила эскалации) доступен fine-tuning через --init_from:
uv run python -m kev.train --data train.jsonl --base Qwen/Qwen3.5-4B-Base --init_from jaredpalmer/kev-4b \
    --epochs 2 --lr 2e-5 --batch 1 --accum 8 --dtype bf16 --device cuda --out runs/mine
Формат данных — JSONL, тот же что и API-запросы, но с полем label на каждом вопросе. Файнтюнинг с --init_from сохраняет базовые знания модели и добавляет доменную специфику: в тесте на 836 решениях поддержки fine-tune с init_from набрал 0.88 на новом домене против 0.33 при обучении с нуля.
Для масштабных экспериментов есть интеграция с Modal — каждый триал получает выделенный H100, результаты сохраняются при отключении.
Оценка
Эталонные данные заморожены в evals/. Бенчмарк отвечает за accuracy, Brier score, калибровку, долю автоматизируемых решений при 5% бюджете ошибок и влияние порядка вариантов. Внешние тесты включают 144 решения из SemIf и 900 тикетов поддержки из scienthoon — Kev-9B показывает 0.952 на маршрутизации и 0.911 на тональности.
Ограничения
- Вероятности плохо калиброваны на новых данных: Kev-4B называет >= 0.9 вероятности для неверного ответа в 8.2% случаев
- Fine-tuning может ухудшить отдельные навыки базовой модели (арифметика дат — яркий пример)
- На Apple Silicon модели заметно медленнее (Kev-4B: 779 мс vs 174 мс для Qwen3-версии)
- Порядок вариантов в choice может влиять на ответ
- Сервер обрабатывает один запрос за раз
Источник: https://github.com/jaredpalmer/kev