

autoresearch: кодинг-агент проводит ИИ-исследования, пока вы спите
📂 Исходный код на GitHubИИ-агенты автономно проводят исследования обучения LLM на одной GPU в упрощённой версии nanochat.
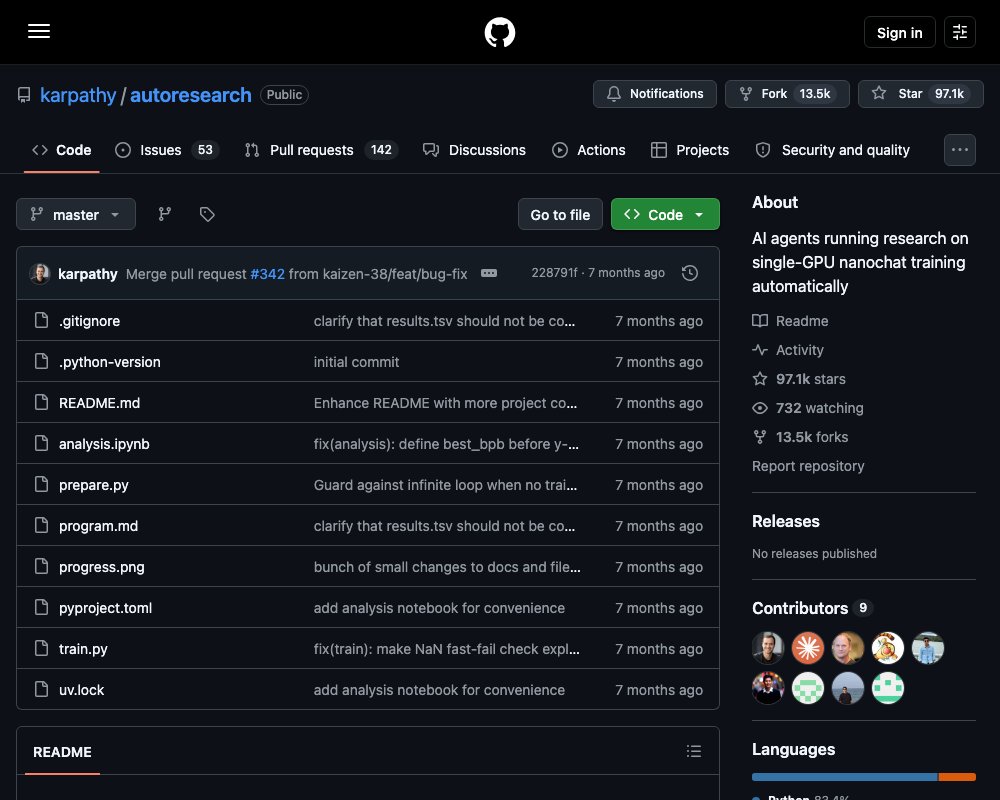
Андрей Карпаты выпустил проект autoresearch. Задумка простая и дерзкая: дать кодинг-агенту настоящий, но компактный стенд для обучения языковых моделей и отпустить его работать автономно на всю ночь. Агент сам правит код, тренирует модель пять минут, смотрит на метрику и решает, оставить изменение или откатить его. Утром человек просыпается и видит журнал экспериментов и, если повезло, улучшенную модель.
Идея нашла отклик: на момент написания у репозитория почти 100 тысяч звёзд на GitHub.
Что внутри
autoresearch — это упрощённая реализация nanochat, компактного стека Карпаты для полного цикла обучения GPT-подобной модели на одной GPU. Но подход тут необычный. Исследователь не редактирует Python-код. Вместо этого он программирует Markdown-файл program.md, который задаёт контекст и правила для ИИ-агента и превращает его в автономную исследовательскую лабораторию.
В репозитории всего три файла, которые имеют значение:
| Файл | Что делает | Кто меняет |
|---|---|---|
prepare.py |
Константы, подготовка данных, BPE-токенизатор, даталоадер, оценка качества | Никто, файл только для чтения |
train.py |
Модель GPT, оптимизаторы (Muon + AdamW), цикл обучения | Агент |
program.md |
Инструкции для агента | Человек |
Дефолтный program.md намеренно минималистичен. Автор называет его «супер-лёгким скиллом» и предлагает итерировать: искать формулировки, которые дают самый быстрый исследовательский прогресс, добавлять новых агентов и так далее. По сути, вы программируете не модель, а исследовательскую организацию из агентов.
Два ключевых правила
Фиксированный бюджет времени. Каждый запуск train.py длится ровно 5 минут по настенным часам, без учёта старта и компиляции. У этого решения два плюса. Во-первых, эксперименты сравнимы между собой независимо от того, что поменял агент: размер модели, архитектуру, batch size. Во-вторых, autoresearch находит оптимум именно для вашей платформы. Обратная сторона: результаты с разных машин напрямую сравнивать нельзя.
Одна метрика — val_bpb (validation bits per byte). Чем ниже, тем лучше. Метрика не зависит от размера словаря, поэтому архитектурные изменения сравниваются честно.
Арифметика приятная: около 12 экспериментов в час и около 100 за среднюю ночь сна.
Быстрый старт
Понадобятся одна NVIDIA GPU (проект тестировали на H100), Python 3.10+ и менеджер пакетов uv:
# Install uv project manager
curl -LsSf https://astral.sh/uv/install.sh | sh

# Install dependencies
uv sync

# Download data and train tokenizer (one-time, ~2 min)
uv run prepare.py

# Manually run a single training experiment (~5 min)
uv run train.py
Если всё отработало, можно включать режим автономного исследования. Запустите в репозитории Claude Code, Codex или любого другого агента и отключите запросы разрешений, чтобы он не останавливался. Стартовый промпт из README:
Hi have a look at program.md and let's kick off a new experiment! let's do the setup first.Что происходит внутри прогона
program.md расписывает агенту весь ритуал. Вот его суть.
Подготовка. Агент договаривается с человеком о теге прогона, например mar5. Затем создаёт ветку autoresearch/<тег>, читает файлы репозитория для контекста и инициализирует журнал results.tsv.
Свобода и границы. Агент может менять только train.py: архитектуру, оптимизатор, гиперпараметры, batch size, размер модели. Нельзя трогать prepare.py, менять функцию оценки или ставить новые пакеты.
Критерий простоты. При равном результате проще — лучше. Микроулучшение на 0.001 val_bpb, ради которого пришлось добавить 20 строк костылей, будет отвергнуто. А вот удалить код без потери качества — это победа. Улучшение взвешивается против роста сложности.
Бесконечный цикл. Схема каждого шага: идея, правка train.py, commit, запуск, чтение метрики из лога, решение. Если val_bpb снизился, коммит остаётся в ветке. Если нет, агент делает git reset и пробует другую идею.
Журнал. Каждый эксперимент пишется в results.tsv с пятью колонками: хеш коммита, val_bpb, пиковая память, статус (keep, discard или crash) и описание идеи. Файл не коммитится в git.
commit  val_bpb memory_gb   status  description
a1b2c3d 0.997900    44.0    keep    baseline
b2c3d4e 0.993200    44.2    keep    increase LR to 0.04
c3d4e5f 1.005000    44.0    discard switch to GeLU activation
d4e5f6g 0.000000    0.0 crash   double model width (OOM)
Работа со сбоями. Если запуск упал из-за опечатки или пропущенного импорта, агент чинит и перезапускает. Если идея в принципе нежизнеспособна, он пишет статус crash и идёт дальше. Запуск дольше 10 минут считается провалом и убивается.
Никогда не останавливаться. Самая характерная инструкция: агенту запрещено спрашивать человека, продолжать ли работу. Хозяин может спать. Если идеи кончились, нужно думать усерднее: перечитать статьи, упомянутые в коде, попробовать комбинации почти удавшихся вариантов, замахнуться на радикальную смену архитектуры. Цикл крутится, пока человек не прервёт его вручную.
Вариант для слабого железа
H100 есть не у всех. Автор даёт советы, как ужать настройки под ноутбук:
- Взять датасет с низкой энтропией, например TinyStories — короткие истории, сгенерированные GPT-4. Данные уже по охвату, поэтому приличные результаты дают даже крошечные модели.
- Уменьшить
vocab_sizeс 8192 до 4096, 2048 или 1024. Можно даже взять байтовый токенизатор на 256 токенов. - Снизить
MAX_SEQ_LENвprepare.py, вплоть до 256. Взамен можно немного поднятьDEVICE_BATCH_SIZEвtrain.py: число токенов на проход равно произведению этих двух значений. - Уменьшить
EVAL_TOKENS, чтобы валидация шла по меньшему объёму данных. - Основная ручка сложности модели в
train.py— константаDEPTH(по умолчанию 8). Многие переменные считаются от неё, можно опустить до 4. - Поставить
WINDOW_PATTERNв значение"L"вместо"SSSL": чередующаяся ленточная схема внимания на малых моделях может работать неэффективно. - Урезать
TOTAL_BATCH_SIZEдо2**14(около 16K токенов), сохраняя степени двойки.
Проще всего скормить этот список своему кодинг-агенту вместе с исходниками и попросить помощи.
Форки под другие платформы
Поддержка отличных от NVIDIA GPU платформ в основной код не вносилась, чтобы не раздувать проект. Зато появились форки:
| Форк | Платформа |
|---|---|
| miolini/autoresearch-macos | macOS |
| trevin-creator/autoresearch-mlx | macOS |
| jsegov/autoresearch-win-rtx | Windows |
| andyluo7/autoresearch | AMD |
Лицензия — MIT. Контекст запуска автор описал в твите и ещё одном. А если нейросети для вас в новинку, посмотрите «гид для чайников», на который ссылается README.
Источник: https://github.com/karpathy/autoresearch