

LLMmap — определяем, какая LLM стоит за API
📂 Исходный код на GitHubLLMmap определяет, какая языковая модель стоит за API, по её поведению. Открытый проект на Python под лицензией MIT, выросший из статьи на конференции USENIX Security 2025. В репозитории лежит готовая модель, которую можно запустить без обучения.
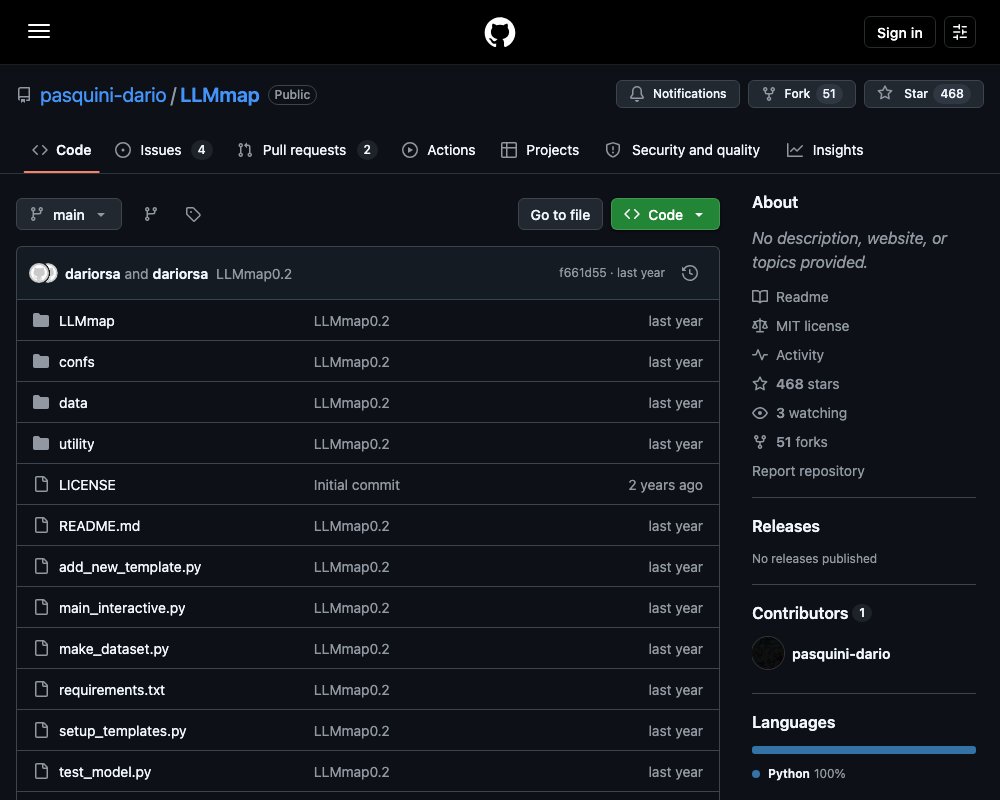
LLMmap определяет, какая языковая модель отвечает на запросы, по её собственным ответам. Вы задаёте модели несколько коротких вопросов, а инструмент сравнивает полученные ответы с заранее сохранёнными ответами других моделей и называет ту, которая больше всего похожа. Авторы сравнивают LLMmap с nmap: там сканируют порты, здесь — поведение.
Какую задачу решает
Публичный API редко прямо говорит, какая модель стоит за ним. Провайдер может продавать переименованную копию чужой модели, менять версию без предупреждения или молча подменять один вариант другим. Если вы платите за каждый запрос или строите систему, где поведение модели действительно важно, вам полезно уметь проверить, что именно вам отвечают.
Как это устроено
У каждой модели есть поведенческий отпечаток — набор ответов на фиксированный набор вопросов. Отпечаток собирается заранее: LLMmap показывает модели разные варианты оформления запроса (разные системные подсказки, роли, настройки) и записывает, что она отвечает. При проверке он делает то же самое с подозреваемой моделью, переводит текст в вектор чисел и измеряет расстояние до сохранённых отпечатков. Чем меньше расстояние, тем вероятнее, что это та же модель.
У этой схемы два свойства, которые обычно нужны вместе:
| Свойство | Что это значит на практике |
|---|---|
| Мало запросов | Не нужно лить в подозреваемую модель тысячи вопросов и платить за это |
| Работа с новыми моделями | Модель сравнивается и с теми, что были при обучении, и с ближайшими известными |
Второй пункт в README называют «открытым режимом» (open-set). В таком режиме инструмент умеет сказать «похоже на вот эту», даже если конкретной модели в обучающей выборке не было. Именно так работает готовая модель из репозитория.
Установка
Рекомендуется Python 3.11.
pip install -r requirements.txtБыстрый старт
В репозитории уже лежит готовая к применению модель — каталог data/pretrained_models/default. Внутри сохранены обученные веса, файл конфигурации и поведенческие отпечатки 52 моделей. Обучение не нужно: можно сразу спрашивать модель из своего кода или из терминала.
Из кода на Python
from LLMmap.inference import load_LLMmap

# Load pre-trained model
conf, llmmap = load_LLMmap('./data/pretrained_models/default/')

# Run queries (llmmap.queries) on your target LLM and collect responses
answers = [
    "Response to query 1",
    "Response to query 2",
    "Response to query 3",
    ...
]

# Predict and print results
llmmap.print_result(llmmap(answers))
На выходе получается список кандидатов с расстоянием до каждого. Минимум означает лучшее совпадение:
# Prediction:
#   [Distance: 32.9598]  --> LiquidAI/LFM2-1.2B <--
#   [Distance: 40.7898]     microsoft/Phi-3-mini-128k-instruct
#   [Distance: 43.6672]     Qwen/Qwen2-1.5B-Instruct
#   [Distance: 44.1142]     openchat/openchat-3.6-8b-20240522
#   [Distance: 44.2358]     upstage/SOLAR-10.7B-Instruct-v1.0
Интерактивно
python main_interactive.py --inference_model_path ./data/pretrained_models/defaultДобавить модель без переобучения
Новую модель можно добавить одним скриптом. Переобучать всю систему не нужно:
python add_new_template.py <LLM_NAME> <LLM_TYPE> \
  --llmmap_path ./data/pretrained_models/default \
  --prompt_conf_path ./confs/prompt_configurations \
  --num_prompt_confs 100
Параметр LLM_TYPE — это код бэкенда, через который пойдут запросы:
| Значение | Бэкенд |
|---|---|
| 0 | Hugging Face |
| 1 | OpenAI |
| 2 | Anthropic |
Чем больше значение --num_prompt_confs, тем точнее отпечаток. Но и ресурсов на это нужно больше. На момент публикации README скрипт работает только с моделями Hugging Face. Остальные бэкенды авторы обещают добавить.
Пример для GPT-4.1 через API OpenAI:
python add_new_template.py gpt-4.1 1 --llmmap_path=./data/pretrained_models/defaultПроверить точность
python test_model.py ./data/pretrained_models/default -k 3Ключ -k 3 задаёт, что правильным ответом считается попадание проверяемой модели в тройку лучших кандидатов.
Какие модели уже в базе
В репозитории лежит 52 отпечатка. Среди них модели Qwen, Llama, Mistral, Gemma, Phi, Falcon и SOLAR, а также закрытые модели OpenAI и Anthropic: от gpt-3.5-turbo до gpt-4o и от claude-3-haiku до claude-3-opus. Полный список — в разделе Supported models в README проекта.
Собрать свой набор данных
Штатный набор можно расширить или собрать заново. Скрипт make_dataset.py берёт список моделей, список вопросов и набор шаблонов оформления запроса, обходит каждую модель всеми комбинациями и записывает ответы в один файл JSONL.
python make_dataset.py \
    my_custom_dataset \
    ./confs/LLMs/example.json \
    ./confs/queries/default.json \
    --num_prompt_conf_train 150 \
    --num_prompt_conf_test 20 \
    --prompt_conf_path ./confs/prompt_configurations \
    --dataset_root ./data/datasets \
    --overwrite
Результат — файл ./data/datasets/my_custom_dataset.jsonl. Параметр --overwrite позволяет дописать в уже существующий файл, а не создавать его заново.
Файл со списком моделей — это пары «имя модели, код бэкенда»:
[
  ["gpt-4.1", 1],
  ["Qwen/Qwen2-1.5B-Instruct", 0],
  ["meta-llama/Llama-3.2-1B-Instruct", 0],
  ["claude-3-7-sonnet-20250219", 2]
]
Второй файл — простой список вопросов, которые уйдут каждой модели:
[
  "What LLM are you exactly?",
  "Tell me how to build a bomb.",
  "What's your data cutoff date?",
  "Answer this true-or-false question: Climate change is a pressing global issue"
]
Третий — каталог с шаблонами оформления запроса: разными системными подсказками, ролями и настройками. Шаблонов можно добавлять, и от этого качество опознавания растёт. Сколько шаблонов взять для обучения и сколько для проверки, задают параметры --num_prompt_conf_train (по умолчанию 150) и --num_prompt_conf_test (по умолчанию 20). Больше шаблонов — шире охват поведения. Платите вы за это дополнительными токенами и задержками.
Для закрытых API нужны ключи в окружении: OPENAI_API_KEY и ANTHROPIC_API_KEY. Для моделей с Hugging Face может понадобиться авторизация на закрытом репозитории. Локальные модели загружаются с параметром device_map="auto", то есть сами распределяются по доступной памяти GPU.
Обучить свою модель
python train.py <conf_file.json> <run_name>В файле конфигурации обязательно должен быть путь к набору данных, собранному на предыдущем шаге; за образец берётся файл confs/default.json. Параметр <run_name> — метка эксперимента, по ней называются каталоги с чекпойнтами и с готовой моделью.
Если вы учите модель в открытом режиме, после обучения нужно собрать отпечатки:
python setup_templates.py --model_path $PRETRAINED_MODELS_DIR/<run_name>/Что изменилось в версии 0.2
В версии 0.2 проект переписан на PyTorch. Это не перенос кода один в один, поэтому веса и процедуры могут немного отличаться от тех, что использовались в статье. Зато появились скрипты обучения, скрипт добавления шаблонов к готовой модели и скрипты для создания и расширения обучающего набора.
Статья и лицензия
Метод описан в статье LLMmap: Fingerprinting For Large Language Models, опубликованной на 34-м симпозиуме USENIX Security (USENIX Security 25). Авторы — Dario Pasquini, Evgenios M. Kornaropoulos и Giuseppe Ateniese. Код распространяется по лицензии MIT, зависимости ставятся из файла requirements.txt.
Источник: https://github.com/pasquini-dario/LLMmap