Strands Decider — модель решений для агентов: выбор варианта, оценка, да или нет
📂 Исходный код на GitHubОткрытая модель решений для агентных процессов и CLI к ней. Основа Qwen3.5-2B-Base без головы для генерации текста и с неболькой головой на миллион параметров: выбор из вариантов, вопрос да или нет, оценка по шкале. Работает на RTX 3090, Mac с процессором Apple Silicon и CPU, есть серверный режим и работа с изображениями. Лицензия Apache 2.0.
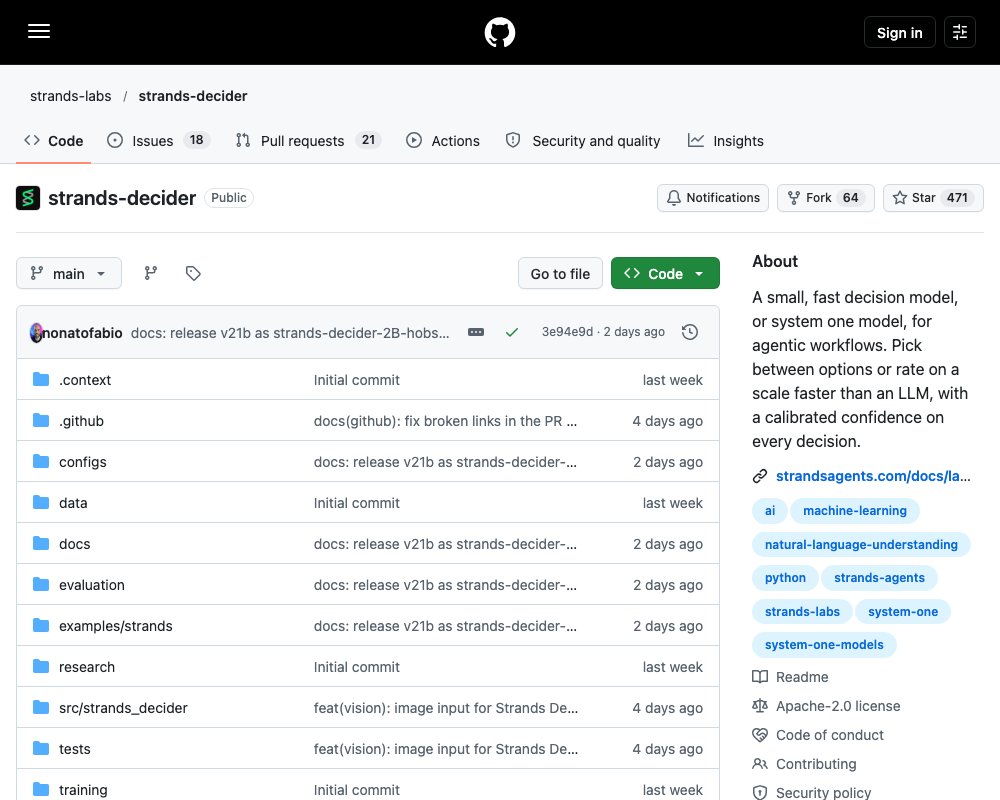
Strands Decider — это модель, которая не пишет текст, а принимает решения. На вход она получает текст и вопрос. Ответ она выбирает из готового списка либо ставит оценку по шкале. В отличие от LLM, она ничего не генерирует: один проход вперёд, без цикла генерации.
Репозиторий лежит на GitHub: https://github.com/strands-labs/strands-decider
Зачем нужна отдельная модель для решений
Разница между LLM и моделью решений — не в размере, а в устройстве. LLM умеет писать произвольный текст и в этом сильна. Но когда нужно просто выбрать один вариант из трёх или понять, насколько текст тревожный, генерация текста не нужна. Классический классификатор решает такую задачу, но его надо обучать, а для этого нужны размеченные данные и отдельный специалист.
Модель решений занимает промежуток между этими двумя вариантами. Она отвечает быстрее LLM и не требует обучения под каждую задачу. Авторы называют такие модели «system one». По смыслу это быстрый первый слой, который стоит перед основной LLM и снимает с неё простые решения.
Три типа вопросов
Все три типа вопросов обрабатываются одним и тем же способом, различается только то, как читается ответ.
Выбор из вариантов — список прямо в вопросе:
strands-decider ask StrandsAgents/strands-decider-2B-hobson-v21 \
  --state "Help! My payouts have been failing for 3 days!" \
  --choice "Which team should handle this?=billing,sales,retail"
choice_0 -> billing (confidence 0.835)
billing 0.890
sales 0.056
retail 0.054Да или нет. В проекте этот тип называется noul:
strands-decider ask StrandsAgents/strands-decider-2B-hobson-v21 \
  --state "Help! My payouts have been failing for 3 days!" \
  --noul "Does this convey urgency?"
noul_0 noul = 0.875Чем ближе к единице, тем увереннее модель отвечает «да».
Оценка по шкале — варианты задаются в порядке от меньшего к большему:
strands-decider ask StrandsAgents/strands-decider-2B-hobson-v21 \
  --state "Help! My payouts have been failing for 3 days!" \
  --score "How frustrated is the writer?=calm,frustrated,depressed"
score_0 score = 1.07 (confidence 0.602)
0: calm 0.140
1: frustrated 0.648
2: depressed 0.212Три вопроса можно задать одной командой. Текст при этом читается моделью только один раз, поэтому несколько вопросов об одном тексте стоят почти столько же, сколько один. Подробнее об этом в docs/inference.md.
Уверенность в ответе
Каждый ответ модель снабжает оценкой уверенности. На коротких задачах, которых она раньше не видела, ответы с уверенностью от 0.9 оказываются верными примерно в 95% случаев. Ниже этого порога авторы рекомендуют переспрашивать или подключать человека. У внешних API больших LLM аналогичной оценки нет.
Модель можно запустить и как сервер, тогда вопросы уходят по HTTP:
strands-decider serve StrandsAgents/strands-decider-2B-hobson-v21 --port 8000curl -s localhost:8000/v1/systemone \
-H 'content-type: application/json' \
-d '{
"state": "Help! My payouts have been failing for 3 days!",
"questions": {
"is_urgent": {"type": "noul", "instructions": "Does this convey urgency?"}
}
}'Ответ содержит саму оценку, число входных и выходных токенов и задержку в миллисекундах.
Как устроена модель
Основа — обычная декодерная модель Qwen3.5-2B-Base. Из неё убирают «голову» для предсказания следующего слова, то есть отнимают саму способность писать текст. Вместо неё ставят маленькую голову примерно на миллион параметров.
Эта голова оценивает каждый вариант ответа так: берёт внутреннее представление текста (скрытое состояние) на позиции <answer> и сравнивает его со скрытым состоянием последнего токена этого варианта. Дальше — один проход вперёд, и всё. Никакой генерации, никакого цикла декодирования. Саму основу модели дообучают через LoRA-адаптер ранга 16, а голова считается в fp32.
Из этого следует важное свойство: в голове нет параметров, привязанных к конкретным вариантам. Значит, модель не может «выучить», что первый вариант в списке обычно правильный. Число вариантов ничем не ограничено, а сами списки задаются запросом, а не зашиты в веса.
Подробное описание архитектуры и цели обучения — в docs/architecture.md.
Цифры
Модель strands-decider-2B — первая в семействе, в ней 1.9 миллиарда параметров. Ответ на вопрос занимает в среднем 115 мс на RTX 3090, модель работает на Mac с процессором Apple Silicon и на обычном CPU.
| Замер | v21 | v19 |
|---|---|---|
| JevBench v1, 231 задача, точность | 0.762 (176 из 231) | 0.723 (167 из 231) |
| Оценка Бриера и ошибка калибровки | 0.323 / 0.064 | 0.342 / 0.052 |
| Разбивка задач: простые / обычные / сложные | 1.000 / 0.931 / 0.550 | 1.000 / 0.875 / 0.505 |
| Задержка на вопрос, RTX 3090, медиана и 95-й процентиль | та же архитектура, что у v19 | 115 мс / 299 мс |
| Задержка на вопрос, M3 Pro | та же архитектура, что у v19 | 153 мс / 234 мс |
Текущая эталонная модель — v21. Это один из шести случайных стартов обучения. Выбрали его по правилу, которое составили заранее, до сравнения результатов. Модель v19 остаётся опубликованной.
С этими числами нужно быть осторожным. Авторы прямо предупреждают, что разница в точности укладывается в шум от повторного обучения: 231 задача — это мало, а разница меньше десяти задач между двумя одиночными прогонами считается нерешённой. Подробности и ограничения описания в evaluation/README.md.
Работа с картинками
Основа модели Qwen3.5-2B-Base умеет работать с изображениями изначально. С флагом --vision сервер сохраняет визуальную часть, и в запрос можно передать картинку в base64. Опубликованные модели v21 и v19 отвечают по картинкам без отдельного обучения на изображениях.
strands-decider serve StrandsAgents/strands-decider-2B-hobson-v21 --vision --port 8000
strands-decider ask StrandsAgents/strands-decider-2B-hobson-v21 --state "" --image page.png \
  --noul "Is the signature block filled in?"
Нужен дополнительный пакет: pip install "strands-decider[vision]" и transformers версии 5.18 или новее. Чем считать, выбирается флагом: --device mlx на Mac с процессором Apple Silicon (быстрее MPS в 1.4–1.6 раза), а также cuda, mps и cpu.
Где это полезно
Модель рассчитана на решения внутри агентного процесса:
- выбор модели — подобрать подходящую LLM под задачу;
- выбор инструмента — решить, какой инструмент агент должен вызвать дальше;
- проверка аргументов — проверить аргументы вызова до того, как он выполнится;
- разбор входящих — отправить запрос в нужную команду или очередь;
- ограничения — проверка безопасности, проверка по политикам;
- оценки — оценить ответы модели дёшево и быстро;
- гибридные агенты — сложные решения остаются у LLM, а простые берёт на себя модель решений.
В репозитории есть готовый пример: хук before_tool_call, который не даёт агенту вызвать инструмент погоды, пока тот не ответит на два вопроса с ответом да или нет. Вместо того чтобы угадать город, агент спрашивает его. Разбор примера — в examples/strands/README.md.
Обучение
Нужна Linux-машина или WSL2 с GPU от NVIDIA. Есть две точки входа. training/recipe.sh all собирает корпус, обучает, калибрует и считает метрики на одной машине с 1–8 GPU. training/run_recipe.sh all вместе с training/aws/ рассчитан на распределённый хост с 8 GPU и добавляет тайминги по этапам, проверки числа строк и выгрузку результатов в S3.
Полный цикл занимает около 11 часов на одной RTX 3090 или 1 час 10 минут на восьми H100 с флагом FAST=1. Подробности настройки — в training/README.md, список источников данных и их лицензий — в data/sources.md.
Почему такой размер
Две причины. Первая — эксперименты. На 1.9 миллиарда параметров модель можно обслуживать и переобучить целиком на железе, которое уже есть: это 11 часов на одной RTX 3090. Идею можно проверить быстро и без больших потерь. Вторая — сам размер: примерно 2 миллиарда параметров хватает, чтобы делать полезную работу, и остаются достаточно маленькими, чтобы с ними удобно работать.
Исследовательская часть
С девятой версии каждый запуск обучения сначала записывает свои предсказания и условия провала, и только потом запускается. Итог дописывается после, уже написанное не правится. По этому правилу провалившийся запуск не становится эталонной моделью, хотя в пяти случаях авторы всё же оставили её — и это тоже отмечено в записях.
Большинство запусков не дотянули до своей планки, в том числе v20: 169 задач из 231 против 168 у v19, то есть в пределах шума, и четыре предсказания не подтвердились. Список запусков с итогами лежит в research/README.md, история изменений бенчмарка — в research/history.md.
Установка
pip install strands-deciderМодели лежат на Hugging Face под именем StrandsAgents/strands-decider-2B-hobson-v21. Лицензия — Apache 2.0, текст в LICENSE. Свой эксперимент можно предложить через issue на GitHub с заранее описанными условиями проверки, формат описан в CONTRIBUTING.md.
Связанные ссылки:
- обзор модели в блоге Strands: https://ai4coding.ru/articles/strands-decider
- Strands Agents SDK, для которого модель и сделана: https://github.com/strands-agents/sdk-python
- чат в Discord: https://discord.gg/Wa4CQrxsP