llm-openai-decisions — оценка текста и изображений через OpenAI Decisions API
📂 Исходный код на GitHubПлагин для LLM от Саймона Уиллисона, который отправляет запросы в OpenAI Decisions API и возвращает структурированный ответ: вероятность выполнения условия, выбранную категорию из списка или оценку по упорядоченной шкале. Текст и изображения на входе, JSON на выходе. Apache-2.0.
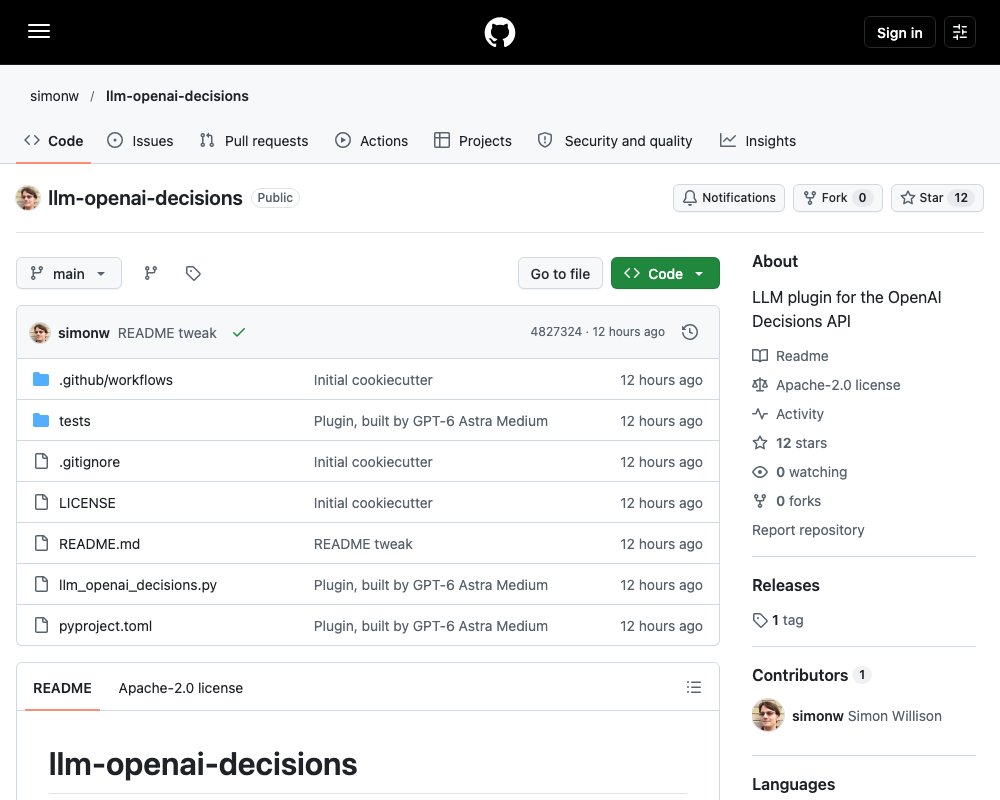
llm-openai-decisions — плагин для LLM от Саймона Уиллисона, который работает с OpenAI Decisions API. Обычный запрос к модели просит сгенерировать текст. Здесь всё наоборот: вы задаёте условие, а модель сообщает, сработало оно или нет. Вопрос «просит ли человек возврат платежа?» превращается в число от 0 до 1.
Это удобно там, где нужен разбор, а не текст: сортировка обращений по отделам, оценка серьёзности бага, проверка картинок, разметка данных для обучения. На вход идут текст и изображения, на выход — всегда JSON с готовым ответом.
Установка
Плагин ставится одной командой, ключ прописывается следующей:
llm install llm-openai-decisions
llm keys set openai
Ключ можно вместо этого положить в переменную окружения OPENAI_API_KEY или передать флагом --key. Нужен Python 3.10 или новее. Лицензия Apache 2.0. Исходный код лежит на GitHub, пакет опубликован на PyPI.
В плагине зарегистрирована одна модель — openai-decisions/gpt-6-luna. Запросы уходят на адрес https://api.openai.com/v1/decisions.
Три типа ответов
Тип ответа выбирается опцией answer_type. Всего их три, и каждый подходит под свою задачу: проверить условие, выбрать один из вариантов или поставить оценку по шкале.
Проверка условия — predicate
Это вопрос с двумя ответами: да или нет. Вход идёт как обычный промпт. Сам вопрос передаётся флагом -s — в терминах LLM это системный промпт.
llm -m openai-decisions/gpt-6-luna 'Please refund my last payment.' \
-s 'Does this message explicitly request a refund?'{"name": "evaluation", "type": "predicate", "probability": 0.99}Значение probability — оценка от 0 до 1: насколько вероятно, что условие выполнено. Тип predicate используется по умолчанию. Имя вопроса по умолчанию — evaluation. Чтобы дать вопросу другое имя, добавьте -o name refund-request.
Выбор категории — choice
Тип choice раскладывает вход по заранее заданным категориям и выбирает одну. Список категорий передаётся опцией -o choices в виде JSON-объекта: ключ — название категории, значение — её описание.
llm -m openai-decisions/gpt-6-luna 'I was charged twice.' \
  -s 'Which department should handle this message?' \
  -o answer_type choice \
  -o choices '{
    "billing": "Charges, invoices, and refunds",
    "technical": "Problems using the product",
    "other": null
  }'
{
"type": "choice",
"name": "evaluation",
"choice": "billing",
"probabilities": [
{"value": "billing", "probability": 1.0},
{"value": "technical", "probability": 0.0},
{"value": "other", "probability": 0.0}
],
"confidence": 1.0
}Описание null означает, что для этой категории достаточно самого названия. В ответе есть выбранная категория в поле choice. Поле confidence показывает, насколько уверенно сделан выбор. Массив probabilities содержит вероятности всех вариантов.
Вариантов должно быть минимум два, а их значения — разными. Плагин проверяет это сам и не отправит запрос, если вариантов меньше двух.
Если ответ по сути да или нет, передайте массив объектов с описаниями для true и false:
llm -m openai-decisions/gpt-6-luna 'I was charged twice.' \
  -s 'Does this require billing support?' \
  -o answer_type choice \
  -o choices '[
    {"value": true, "description": "Billing issue"},
    {"value": false, "description": "Anything else"}
  ]'
В ответе тогда choice равно true, а в массиве вероятностей две записи.
Оценка по шкале — score
Тип score работает со списком уровней. Уровни идут от меньшего к большему.
llm -m openai-decisions/gpt-6-luna 'Export fails in Safari but works in Chrome.' \
  -s 'How severe is this issue?' \
  -o answer_type score \
  -o levels '["Cosmetic","Workaround available","Fully blocked"]'
{
"type": "score",
"name": "evaluation",
"score": 0.96,
"probabilities": [
{"value": 0, "label": "Cosmetic", "probability": 0.04},
{"value": 1, "label": "Workaround", "probability": 0.96},
{"value": 2, "label": "Blocked", "probability": 0.0}
],
"confidence": 0.94
}Уровней должно быть минимум два. Если уровню нужно пояснение, передайте объекты с полями label и description:
llm -m openai-decisions/gpt-6-luna 'Export fails in Safari but works in Chrome.' \
  -s 'How severe is this issue?' \
  -o answer_type score \
  -o levels '[{"label":"Cosmetic","description":"Appearance only"},{"label":"Workaround","description":"Another way works"},{"label":"Blocked","description":"No workaround"}]'
Число score — среднее по индексам уровней, взвешенное по вероятностям. Индексы начинаются с нуля, поэтому при трёх уровнях score лежит в диапазоне от 0 до 2.
Работа с изображениями
Картинка добавляется флагом -a. Текст рядом с ней не обязателен — можно отправить только изображение.
llm -m openai-decisions/gpt-6-luna -a https://static.simonwillison.net/static/2025/two-pelicans.jpg \
-s 'Does this image contain any mammals?'{"type": "predicate", "name": "evaluation", "probability": 0.0}Поддерживаются PNG, JPEG, WebP и GIF. В одном запросе проходит не больше 128 изображений. Флаг -a принимает и ссылку, и путь к локальному файлу.
Несколько вопросов за один раз
Опция -o questions собирает несколько вопросов про один и тот же вход. У каждого вопроса должно быть уникальное имя в поле name, тип в поле type и формулировка в поле instructions. Вопросу типа choice дополнительно нужны choices. Вопросу типа score — levels. Передаются они в уже знакомом формате массива объектов.
llm -m openai-decisions/gpt-6-luna 'I was charged twice and need my money back.' \
  -o questions '[
    {
      "name": "refund",
      "type": "predicate",
      "instructions": "Does this request a refund?"
    },
    {
      "name": "department",
      "type": "choice",
      "instructions": "Which department should handle this?",
      "choices": [{"value": "billing"}, {"value": "other"}]
    }
  ]'
[
{"type": "predicate", "name": "refund", "probability": 0.94},
{
"type": "choice",
"name": "department",
"choice": "billing",
"probabilities": [
{"value": "billing", "probability": 1.0},
{"value": "other", "probability": 0.0}
],
"confidence": 1.0
}
]Ответ приходит массивом в том же порядке, в котором шли вопросы, даже если вопрос был всего один.
У questions есть ограничения. Его нельзя сочетать с системным промптом, с choices и с levels. Нельзя менять и значения answer_type и name. Формулировку каждого вопроса пишите внутри самого вопроса. Плагин проверяет всё это сам и объясняет ошибку внятным текстом.
Если модель отказалась отвечать на вопрос, её ответ сохраняется на своём месте. Выглядит он иначе: {"name":"...","type":"refusal"}.
Готовые шаблоны
Вопрос можно сохранить как шаблон, чтобы не набирать его заново:
llm -m openai-decisions/gpt-6-luna \
  -s 'Does this message explicitly request a refund?' --save refund-request
cat message.txt | llm -t refund-request
Кроме шаблонов, доступны фрагменты (fragments), ввод через stdin и хранение ключей. Всё это работает через обычный интерфейс LLM.
Python
Из кода плагин вызывается так:
import json
import llm

model = llm.get_model("openai-decisions/gpt-6-luna")
response = model.prompt(
    "Please refund my last payment.",
    system="Does this message explicitly request a refund?",
)
print(json.loads(response.text())["probability"])
print(response.json())  # Complete provider response
print(response.usage())  # Token counts and details
Опции принимают и JSON-строки, и обычные списки и словари Python. Для асинхронного режима есть llm.get_async_model():
import asyncio
import llm

async def main():
    model = llm.get_async_model("openai-decisions/gpt-6-luna")
    response = await model.prompt(
        "I was charged twice.",
        system="Which department should handle this?",
        answer_type="choice",
        choices={"billing": "Payments and refunds", "other": None},
    )
    print(await response.text())
    print(await response.json())

asyncio.run(main())
Изображение в Python добавляется параметром attachments:
response = model.prompt(
    system="Does this image contain any mammals?",
    attachments=[llm.Attachment(path="product.png")],
)
Чтобы передать байты напрямую, есть llm.Attachment(content=image_bytes, type="image/png").
Что проверяет плагин
Внутри используется библиотека Pydantic. Она не пропускает ни плохой ввод, ни плохой вывод. Имя вопроса и его формулировка не могут быть пустыми. Имена вопросов не должны повторяться. Варианты у choice и уровни у score должны быть разными, и их должно быть не меньше двух.
На выходе плагин ждёт по одному ответу на каждый вопрос. Он сверяет имя и тип ответа с вопросом и требует отчёт с расходом токенов. Если хоть что-то не совпало, вместо тихого результата вы получите ошибку с описанием, что именно сломалось. Отказ (refusal) ошибкой не считается. Разбор JSON строгий: повторяющиеся ключи и значения NaN и Infinity не допускаются.
Запрос одноразовый. Модель принимает текст и картинки из сообщения пользователя, а ещё текст системного сообщения. Диалога нет, потоковой выдачи нет, вызова инструментов нет, схем ответа нет. Ошибки HTTP и неожиданный формат ответа превращаются в понятное сообщение об ошибке.
Разработка
Тесты и список доступных опций запускаются так:
cd llm-openai-decisions
uv run pytest
uv run llm models -m openai-decisions/gpt-6-luna --options
Исходный код — один файл llm_openai_decisions.py, тесты лежат в каталоге tests, а список изменений публикуется в релизах.