

Jeff — маленькие модели быстрого выбора варианта без генерации текста
📂 Исходный код на GitHubТонко настроенные версии Qwen3.5 и Gemma 4 для выбора варианта ответа без генерации текста: вероятности по всем вариантам за один прямой проход, локальный запуск через PyTorch или MLX
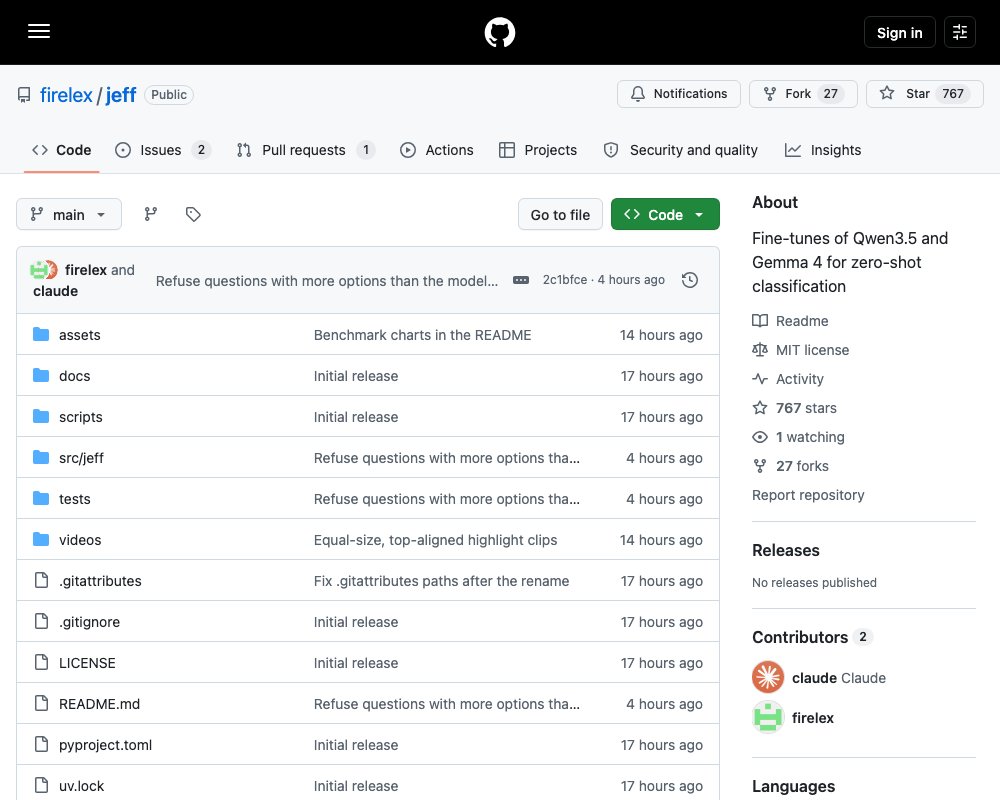
Jeff — это набор очень маленьких моделей, которые выбирают один вариант из списка. Вы описываете ситуацию и перечисляете варианты обычными словами. Модель отвечает не текстом, а вероятностью для каждого варианта. Ответ получается за один прямой проход, без генерации и без разбора ответа.
Скорость главная причина, почему Jeff вообще интересен. Одно решение занимает около 22 мс на видеокарте NVIDIA RTX PRO 6000 и 28 мс на Mac M4 Max через MLX. Это не чат-бот, а быстрый переключатель, который можно звать из кода часто и без ощутимых задержек.
Что за модель и что нет
Модели в Jeff совсем маленькие: 0.8B и 2B параметров у Qwen3.5, плюс Gemma 4 E2B. Они не умеют рассуждать в несколько шагов. Зато они быстро и честно по вероятности выбирают между вариантами, которые вы сами описали.
Варианты при этом могут быть любыми. Классы не обязаны быть заранее известны — в обучающих данных вашего домена их может не быть вообще. Вы описываете их словами, а Jeff выбирает. Так работают очереди поддержки, намерения пользователя, модерационные метки, голосовые команды и ходы в играх.
Если качества без обучения не хватает, короткое дообучение на своих примерах даёт большой скачок. В тесте с голосовой навигацией точность на отложенной выборке выросла с 31.7% до 95.8% меньше чем за полчаса на одной видеокарте.
Модели
| Модель | Параметры | Веса (16 бит) |
|---|---|---|
| Jeff-Qwen3.5-0.8B | 0.8B | 1.7 ГБ |
| Jeff-Qwen3.5-2B | 2B | 4.2 ГБ |
| Jeff-Gemma4-E2B | 2B активных (4.6B в файле) | 9.3 ГБ |
Веса лежат на Hugging Face: Jeff-Qwen3.5-0.8B, Jeff-Qwen3.5-2B и Jeff-Gemma4-E2B.
Формат запроса
Jeff использует тот же формат запроса, что и Jev, но не связан с TypeSafe и не одобрен ими.
uv sync
uv run hf download mstrasser/Jeff-Qwen3.5-0.8B --local-dir checkpoints/jeff-0.8b

# NVIDIA GPU или CPU (PyTorch)
JEFF_CHECKPOINT=checkpoints/jeff-0.8b PORT=8765 uv run jeff-serve

# Apple silicon (MLX, на Mac быстрее; только модели Qwen)
uv sync --extra mac
JEFF_BACKEND=mlx JEFF_CHECKPOINT=checkpoints/jeff-0.8b PORT=8765 uv run jeff-serve
Пример запроса:
curl -s localhost:8765/v1/systemone -H 'content-type: application/json' -d '{
  "model": "jeff-latest",
  "state": "Refund request: the customer says the parcel arrived crushed and wants their money back.",
  "questions": {
    "route": {"type": "choice", "instructions": "Which team should handle this?",
              "criteria": {"1": "Refunds and payments", "2": "Damaged or lost parcels", "3": "Account and login problems"}},
    "angry": {"type": "noul", "instructions": "Is the customer angry?"}
  }
}'
В ответе по каждому варианту стоит вероятность, выбранный вариант и общая уверенность. Поддерживаются три типа вопросов:
choice— выбрать один вариант из списка (до 26 вариантов у готовых моделей)noul— да или нет, тоже возвращается как вероятностьscore— оценка по шкале, которую вы описали сами
Несколько независимых вопросов можно отправить в одном запросе, и ответы придут вместе.
Результаты на тестах
Замеры сделаны на 4599 вопросах из пяти публичных наборов данных. Для сравнения добавлен публичный сложный уровень JevBench — 105 заданий, он считается отдельно. Опубликованные цифры Jev и AutoJev измерены на другой выборке тех же наборов.
| Набор | Qwen3.5-0.8B без обучения | Jeff-Qwen3.5-0.8B | Qwen3.5-2B без обучения | Jeff-Qwen3.5-2B | Gemma 4 E2B без обучения | Jeff-Gemma4-E2B | Jev |
|---|---|---|---|---|---|---|---|
| Всего (5 наборов) | 45.3 | 79.1 | 46.5 | 83.1 | 62.5 | 81.6 | 83.0 |
| BBH | 39.5 | 64.0 | 46.0 | 68.0 | 51.3 | 66.4 | 94.3 |
| Financial PhraseBank | 36.0 | 96.4 | 53.4 | 96.3 | 86.0 | 96.1 | 77.0 |
| JudgeBench | 56.6 | 62.6 | 57.4 | 64.6 | 46.9 | 60.6 | 78.6 |
| RAGTruth | 49.1 | 86.1 | 35.9 | 88.9 | 63.8 | 87.4 | 77.3 |
| WinoGrande | 49.2 | 68.6 | 52.2 | 79.0 | 51.0 | 77.4 | 90.7 |
| JevBench, сложный (отдельно) | 36.2 | 47.6 | 45.7 | 53.3 | 41.0 | 48.6 | 73.3 |
Общая цифра Jeff складывается из задач на классификацию и привязку к источнику, где маленькие модели догоняют большие и обгоняют их. На наборах, где нужно рассуждение (BBH, JudgeBench, JevBench), отставание заметное — этого стоит ждать при таком размере модели.
Скорость
Медианное время одного решения на 200 вопросах из набора данных, примерно по 200 входных токенов, один вопрос за раз, от сырого текста до вероятностей:
| Модель | NVIDIA RTX PRO 6000 | Apple M4 Max (MLX) | CPU (32 потока) |
|---|---|---|---|
| Jeff-Qwen3.5-0.8B | 22 мс | 28 мс | 463 мс |
| Jeff-Qwen3.5-2B | 24 мс | 60 мс | 708 мс |
| Jeff-Gemma4-E2B | 29 мс | — (MLX работает только с Qwen) | 1.0 с |
| Jev (API) | 114–212 мс за вызов с учётом сети |
Как использовать Jeff хорошо
- Рассуждайте в коде, решайте моделью. Jeff — это классификатор, а не планировщик. Описывайте, к чему приведёт каждый вариант («этим ходом тебя собьёт машина»). Если спросить о прогнозе («через два хода приедет машина»), результат не лучше случайного.
- Формулировки решают очень многое. Описывайте варианты одинаково. Когда в Frogger варианту с целью дали те же слова, что и всем остальным вперёд, результат в одной серии поднялся с 15 переходов до 23.
- Короткие ключи и понятный текст. Лучше
{"1": "Engagement letter"}, чем длинные идентификаторы: длинные ключи только тратят время. - Независимые вопросы отправляйте одним запросом.
- Дообучайте, если без обучения не хватает. Дообучение под голосовую навигацию на 11 тысячах примеров заняло около получаса на одной видеокарте и подняло точность с 31.7% до 95.8%, при 40 мс на решение на M4 Max.
- Берите размер под задачу. Для быстрого выбора варианта 0.8B — лучший выбор. 2B осторожнее и играет в игры хуже, хотя на тестах набирает больше.
Игры как проверка без обучения
Состояние игры — не самый удобный материал для проверки, но это наглядный тест. Каждый ход код описывает словами, модель выбирает один вариант. Варианты говорят, к чему приведёт каждый ход, но не какой из них правильный. По 20 серий на игру, зерно 1234.
| Модель | Doom, убийств | Frogger, переходов | Pac-Man, из 98 |
|---|---|---|---|
| Случайные ходы | −0.05 | 0 | 11.2 |
| Простое правило в коде | 6.55 | 10.25 | 94.1 |
| Qwen3.5-0.8B, без обучения | 5.0 | 1.0 | 25.8 |
| Jeff-Qwen3.5-0.8B | 6.55 | 10.3 | 57.0 |
| Qwen3.5-2B, без обучения | 0.55 | 0.05 | 72.1 |
| Jeff-Qwen3.5-2B | −0.9 | 6.0 | 41.2 |
| Gemma 4 E2B, без обучения | −0.55 | 0 | 3.2 |
| Jeff-Gemma4-E2B | 0.55 | 0.15 | 53.2 |
Jeff-Qwen3.5-0.8B в Doom упирается в потолок в 6.55 убийств. Опубликованный прогон Jev дал 6.55, но только когда модели сообщили правило прицеливания; без этого правила было −0.60. Одно решение в Jeff на M4 Max занимало 29–49 мс, у Jev — 212 мс за вызов. Время мерили на разном железе, так что сравнение приблизительное.
Повторить замеры:
uv sync --extra games
uv run python -m jeff.games --game doom --player jeff --criteria situation --url http://127.0.0.1:8765 --video --out runs/games/doom.json
uv run python -m jeff.games --game frogger --player jeff --criteria outcomes --url http://127.0.0.1:8765 --out runs/games/frogger.json
uv run python -m jeff.games --game pacman --player rule --out runs/games/pacman-rule.json
Своё обучение
uv run autojev-mix ...          # собрать набор данных (публичные данные, синтетика, фильтр утечек)
scripts/train.sh RUN data/mix/public.jsonl data/mix 5e-6 40 Qwen/Qwen3.5-0.8B <revision> --epochs 1
uv run autojev-evaluate --data data/panel.jsonl --local --checkpoint checkpoints/RUN/selected --output runs/eval/RUN.json
Весь конвейер — синтетика от локальной учительской модели, фильтр утечек, перебор скорости обучения, панель результатов — описан в scripts/train_all.sh. Все источники данных с их лицензиями перечислены в docs/data-sources.md.
Сама схема обучения простая: дообучение всех весов, одна эпоха, пачки по 256 примеров, потери на буквах вариантов и одна подобранная температура для калибровки вероятностей. Контрольные точки выбираются на отложенной выборке, а не на итоговом наборе тестов. Как минимум половина каждой группы обучающих данных повторяет оформление панели, но ни один вопрос из самой панели не попадает в обучение.
Ограничения
- Не больше 26 вариантов на вопрос. Варианты кодируются буквами A–Z, потом AA, AB и так далее. Самый большой вопрос в обучающих данных содержал 19 вариантов, поэтому готовые модели так и не научились выбирать двухизначный код. Вариант на позиции 27 и дальше практически никогда не выбирается, какой бы текст у него ни был. Сервер поэтому отказывает в вопросах с большим числом вариантов — длинные списки приходится сокращать заранее. Модели на 255 вариантов уже дообучают.
- Маленькие модели не рассуждают. Ждите быстрого и откалиброванного выбора между описанными вариантами, а не рассуждения в несколько шагов. Для размера 0.8B–2B это верно для любой модели, не только для Jeff.
- Jeff-2B играет в игры хуже Jeff-0.8B. Нетронутая модель 2B выглядит осторожнее нетронутой 0.8B, а обучение, похоже, усилило разницу. Причина пока не разобрана.
- Цифры на тестах не предсказывают игру. Нетронутая Gemma 4 E2B обгоняет нетронутые модели Qwen на тестах, но играет хуже всех: угадывает чаще, но ненадёжно. Обучение починило её Pac-Man (3.2 → 53.2), но не Doom и не Frogger.
- Формулировка запроса решает всё. Собственный промпт Jev для Doom — сырое число направления плюс правило прицеливания — не работает ни на одной из этих моделей. Работают варианты, где последствия описаны словами.
- Только английский язык и только текст.
История и лицензии
Jeff начался как форк AutoJev Дениса Яраца (MIT) — открытого рецепта дообучения Qwen3.8-27B, который отдаёт решения в стиле Jev. От него оставили основную задумку: один прямой проход на решение, обученный слой чтения ответа и подобранная температура для калибровки. Дальше добавили маленьких учеников (Qwen 0.8B и 2B, Gemma 4 E2B), локальный конвейер синтетических данных с фильтром утечек, оформление запросов под доменные дообучения, запуск через MLX на Apple silicon, игровые тесты и панель обучения. Исходное уведомление об авторских правах сохранено в файле LICENSE.
Код распространяется под MIT, веса — под Apache 2.0. Обвязка для Doom взята из jev-plays-doom (MIT). Веса и код открыты, а обучающие данные — нет; часть источников требует соблюдения тех же условий распространения (CC BY-SA).
Проект независимый. Всё обучение шло на своём железе: на одной рабочей станции RTX PRO 6000 (0.8B — около двух часов, 2B — около трёх с половиной), синтетические данные писала открытая модель на двух DGX Spark, тесты шли на MacBook. Облачные видеокарты не использовались, и в обучающих данных нет вывода закрытых моделей.
Источник: https://github.com/firelex/jeff