

Практический гайд по GPT-6: модели, промпты и длинные задачи
Практический гайд по GPT-6: как получить от модели результат за разумные деньги
2 октября 2026 года OpenAI опубликовала гайд по семейству GPT-6. Это не описание архитектуры и не список возможностей. Это инструкция для разработчика: как выбрать модель под задачу, как потратить меньше токенов на повторяющейся работе, как написать инструкции, которые модель действительно выполнит, и как не потерять контроль над задачей, которая идёт несколько часов.
Документ получился сухим и без рекламного тона. Почти каждый совет — это либо ссылка на конкретную функцию API, либо тест, который стоит прогнать до выката в продакшен. Ниже — содержание гайда и комментарии о том, что в нём действительно важно для практики.
Коротко о главном
OpenAI сводит весь гайд к четырём пунктам.
- Экономить деньги и время через prompt caching и compaction, а скорость и стоимость измерять на реальных задачах.
- Подбирать модель и уровень reasoning под характер работы, а не по принципу «взять самую умную».
- Держать промпты, skills и инструкции репозитория согласованными: что модель должна выдать, что может делать сама, что считается готовым результатом.
- Удерживать длинные задачи в нужном русле через steering, асинхронные инструменты и делегирование.
Последний пункт — новинка. Раньше агент либо работал, либо молчал. Теперь его можно поправить прямо посреди работы, не начиная задачу заново.
Три модели и разница в цене
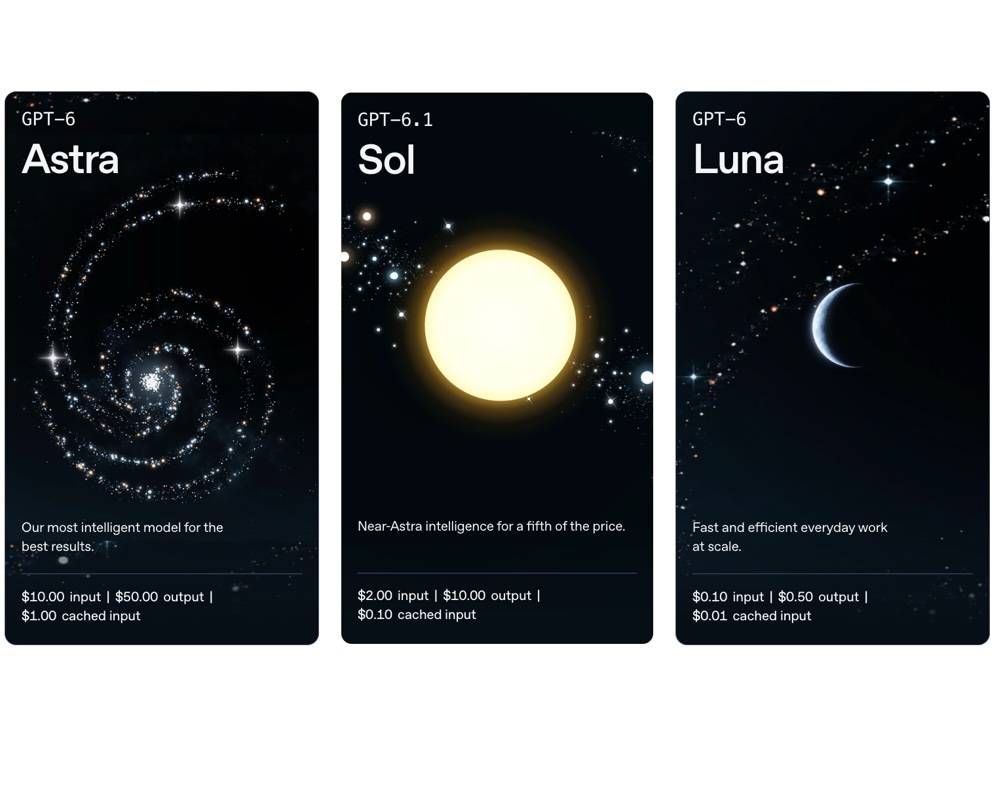
В семействе три модели. Разница между ними не в общем качестве, а в цене под конкретный класс задач.
| Модель | Ввод | Вывод | Кэшированный ввод | Для чего |
|---|---|---|---|---|
GPT-6 Astra (gpt-6-astra) |
$10.00 | $50.00 | $1.00 | Самая сложная работа по рассуждению |
GPT-6.1 Sol (gpt-6.1-sol) |
$2.00 | $10.00 | $0.10 | Сложный код, исследования, computer use |
GPT-6 Luna (gpt-6-luna) |
$0.10 | $0.50 | $0.01 | Типовые задачи на потоке |
Цены указаны за миллион токенов. Разница между Astra и Sol по вводу — в пять раз. Это значит, что выбор модели влияет на счёт сильнее, чем любой другой трюк оптимизации.
OpenAI даёт прямое указание, что делать с каждой:
- Astra — самая сложная работа по рассуждению, где нужны лучшие ответы из возможных.
- Sol — сложное программирование, исследования и работа с интерфейсом.
- Luna — точечные задачи на потоке: вытащить поля из счёта, классифицировать обращение, собрать структурированное резюме.
Что настроить до выката
Раздел про подготовку к продакшену состоит из пяти пунктов, и все они про деньги и контроль.
Режьте лишний контекст. Убирайте из запроса то, что задаче не нужно, но сохраняйте факты, на которых строится вывод. Там, где приложение это позволяет, запускайте независимые задачи параллельно, чтобы один медленный шаг не тормозил остальную работу.
Переиспользуйте контекст через prompt caching. Здесь самая заметная цифра гайда: кэшированные входные токены стоят на 95% дешевле обычных — цифра зависит от модели. Чтобы кэш срабатывал, стабильные инструкции и справочные материалы нужно ставить перед изменяемыми деталями задачи. Определения инструментов тоже должны оставаться одинаковыми от запуска к запуску. Понять, где кэш перестаёт срабатывать, помогают дашборд кэширования и диагностический гайд.
Сжимайте длинные диалоги. Compaction уменьшает объём контекста, сохраняя состояние, без которого нельзя продолжить. Для многодневных агентных сессий это уже не оптимизация, а условие работоспособности.
Определитесь с мониторингом и контролем данных. Гайд отсылает к мониторингу поведения модели и к настройкам хранения данных.
Тестируйте до выката. Прогнать представительные задачи и измерить три вещи: успешность выполнения, задержку и стоимость одной успешной задачи. Отдельно OpenAI просит учитывать стоимость записи в кэш и тарифы за длинный контекст — то есть считать не цену токена, а цену всего завершённого воркфлоу.
Уровень reasoning
Второй рычаг экономии — сколько усилий модель тратит на задачу. Уровень выбирается в API явно.
| Уровень | Когда нужен |
|---|---|
| Low | Рутина: извлечь факты, внести мелкие правки |
| Medium | Работа, где нужно решение: планирование фичи, сравнение вариантов |
| High | Сложная отладка, глубокий разбор, внимательное ревью |
| Extra high / Max | Точечно там, где High не хватило, и только если прирост стоит потраченного времени и денег |
Отдельная деталь, которой раньше не было: уровень reasoning можно менять прямо посреди диалога, и кэш при этом не ломается. То есть тяжёлый разбор можно начать на High, а рутинную часть в том же диалоге увести на Low.
В Codex логика простая: начинайте с уровня по умолчанию для модели, снижайте для простых задач, поднимайте для глубокого анализа.
Скорость: Fast и Ultrafast
Отдельно от уровня рассуждения есть скорость генерации токенов. Fast mode в API нужен там, где важно время ответа: чат, инструменты для написания кода. Он даёт более предсказуемые задержки, но токены стоят дороже, чем при Standard. Ultrafast работает в Codex и в API и ускоряет именно генерацию токенов, не затрагивая reasoning. На момент публикации гайда он доступен для GPT-6 Astra.
Промпты и skills
Самый спорный совет гайда — из тех, что ломают устоявшиеся привычки. Он опирается на заметку Eric Provencher из Developer Experience OpenAI:
«Модели стали гораздо лучше понимать нюансы и неоднозначность, поэтому чрезмерно точные указания теперь могут мешать там, где раньше помогали».
Отсюда рекомендация начинать не с подробных инструкций, а с ясного задания: какой результат нужен, для кого, какой контекст и ограничения действуют, что считается готовым.
Дальше гайд разбирает четыре зоны. Сводка взята из другой статьи OpenAI — Rethinking skills and prompts for GPT-6 Astra.
Пишите skills яснее. Skills — это пачка инструкций, которую модель подгружает под конкретную задачу. Описание должно быть коротким и прямо говорить, когда этот skill применяется. Вспомогательные детали стоит грузить только тогда, когда они действительно понадобились. Жёсткие пошаговые рецепты нужно заменять на указания, подходящие под те модели, которыми реально пользуется команда.
Обновляйте AGENTS.md. В файле с инструкциями репозитория стоит объяснить, какие документы и тесты относятся к какой задаче. И отдельно явно разрешить безопасные рутинные действия: например, прогонять локальные тесты на одноразовых данных и без доступа к продакшену.
Задавайте границы решений. Вместо общего правила «всегда спрашивай» нужно перечислить, какие действия модель выполняет сама, а какие требуют вашего подтверждения.
Описывайте, что значит «готово». В определение готовности стоит включить не только изменение кода, но и его запуск, проверку результата и починку неудач. Отдельно перечислите решения, которые всё равно ждут вас.
Вторая часть гайда звучит проще. Скажите модели три вещи: какие решения она вправе принимать сама, когда нужно спросить вас и как выглядит полезный ответ. Например, модель может сама выбрать структуру резюме, но обязана спросить, если собирается менять границы проекта. Полезный ответ — понятный язык, техническая глубина под аудиторию и короткая передача дел: что изменилось, что проверено, что осталось без внимания. Подробнее это разобрано в best practices для reasoning-моделей.
Длинные задачи: steering, async tools, subagents
С семейством GPT-6 задача может идти часами или днями. В API для этого появились три механизма.
Управление посреди захода. Mid-turn steering позволяет отправить поправку через WebSocket-режим Responses API, пока она ещё работает. Обновления ставятся в очередь: они не отменяют уже запущенные инструменты и не откатывают сделанное.
Работа параллельно с долгим инструментом. Asynchronous tool calling позволяет модели заниматься независимой работой, пока ваше приложение выполняет медленную задачу — например, тесты. Приложение возвращает результат, когда он готов. Модель должна дождаться его перед тем, как строить на нём что-то дальше.
Делегирование подзадач. GPT-6.1 Sol поддерживает multi-agent-сценарии в Responses API: модель может передать независимые подзадачи subagents (например, разобрать разные части кодовой базы) и собрать их выводы в один ответ. Пока эта функция в бета-версии.
В Codex всё иначе: там нужны уточняющие вопросы и управление ходом работы. С GPT-6 Astra Codex умеет задавать вопросы во время работы. Практический совет: решайте вопросы, которые влияют на следующий шаг, и отдельно укажите, какая независимая работа может продолжаться, пока вы думаете. Если вас не будет рядом, заранее скажите Codex, что продолжать и когда остановиться. Подробнее про steering в удалённом Codex.
Computer use
Computer use доступен во всех трёх моделях и позволяет им напрямую работать с сайтами и программами на рабочем столе — даже с теми, у которых нет API. Модель может разобраться с багом, починить код, открыть ваш продукт в браузере и проверить, что правка работает.
Правило выбора простое: берите самый простой надёжный способ. Если задачу решает API или подключённый инструмент — берите его. Computer use нужен тогда, когда модели надо прочитать экран, нажать кнопку или заполнить форму.
Если вы встраиваете это в своё приложение, дайте модели инструмент, который умеет управлять браузером или рабочим столом. Playwright подходит для браузеров, PyAutoGUI — для десктопных программ.
Как это уже работает
Гайд заканчивается разбором четырёх компаний, перешедших с тестов в продакшен.
- Harvey собирает для модели данные суда, прецеденты, документы фирмы и предпочтения юриста, чтобы черновики получались точнее. Сооснователь Gabe Pereyra говорит, что компания даёт модели больше контекста и получает более структурированный вывод.
- Cognition использует Astra внутри Devin для тестирования софта и возвращает доказательства. В примере с игрой для iPhone Devin отдал запись симулятора и отчёт, который отделяет пройденные проверки от непокрытых зон.
- Hex превращает вопросы про продажи в письменные выводы и интерактивные дашборды с разбивкой по регионам. Модель отдельно просят проверить, сходятся ли цифры и отвечает ли анализ на исходный вопрос.
- Invideo планирует правки таймлайна и создаёт эффекты, которые редактор затем дорабатывает. Компания говорит примерно о трёхкратном росте успешности на задачах цветокоррекции. Отдельные редакторы создавали около 50 эффектов за день.
Что стоит забрать из гайда
Главное из гайда — три вещи.
Первое: выбирать модель и уровень reasoning под задачу, а не по умолчанию. Между Astra и Sol разница в пять раз по цене ввода. Ошибка в этом выборе стоит дороже любой другой оптимизации.
Второе: кэш и compaction экономят до 95% на повторяющемся вводе, но только при правильном порядке токенов. Стабильное — вперёд, изменяемое — в конец.
Третье: инструкции для модели стали короче, а не длиннее. Чёткая граница «что я решаю сам, где я спрашиваю, что значит готово» заменяет длинные рецепты. Модели стали лучше понимать нюансы — и мешает им именно избыточная детализация.