

Transformer Explainer — интерактивный разбор того, как работает GPT, прямо в браузере
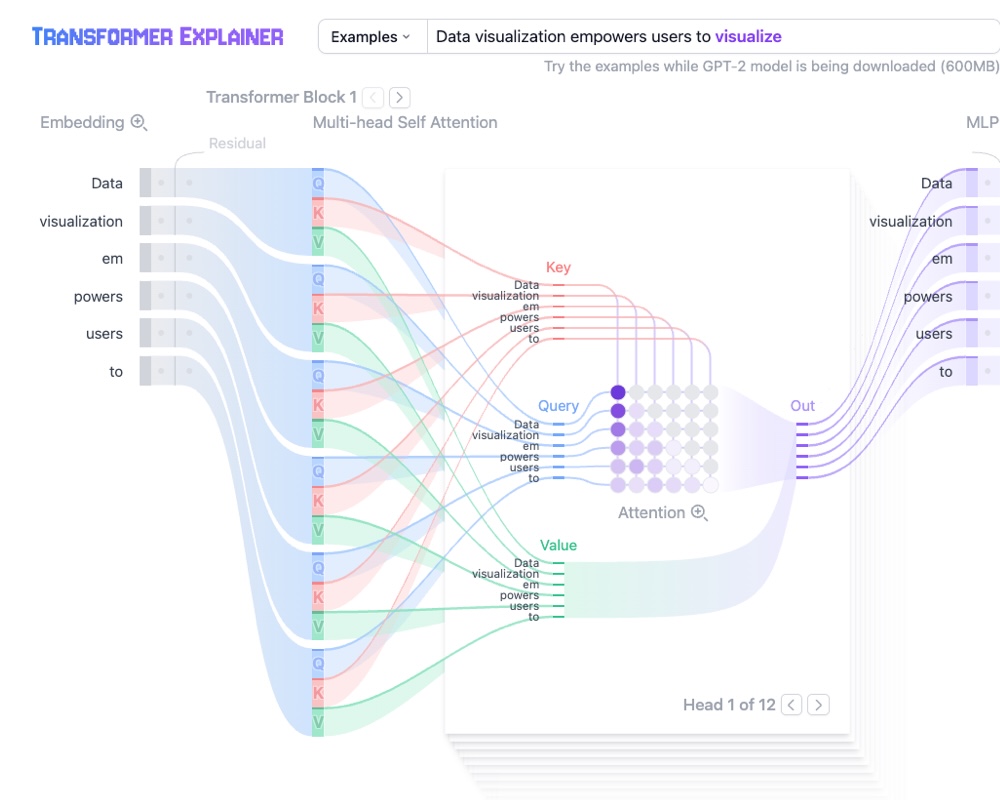
Transformer Explainer — это интерактивная визуализация от исследовательской группы Polo Club Технологического института Джорджии (Georgia Tech), которая объясняет, как устроены модели-трансформеры, лежащие в основе GPT, Llama и Gemini. Главная фишка проекта: внутри страницы запускается настоящая модель GPT-2 (small) со 124 миллионами параметров, и вы можете вводить собственный текст и в реальном времени наблюдать, как модель вычисляет следующий токен — вплоть до отдельных весов attention.
Ссылка на инструмент: https://poloclub.github.io/transformer-explainer/
Зачем это нужно
Архитектура transformer появилась в 2017 году после знаменитой статьи «Attention is All You Need» и с тех пор стала стандартом для генеративных моделей. На ней работают OpenAI GPT, Meta Llama, Google Gemini, а также системы генерации аудио, распознавания изображений и предсказания структуры белков. При этом для многих разработчиков внутренняя механика остаётся «чёрным ящиком»: все знают про next-token prediction, но далеко не все представляют, что происходит между вводом промпта и выдачей ответа.
Transformer Explainer закрывает этот пробел наглядно. Вместо статичных картинок вы получаете живую модель: меняете текст — пересчитываются все значения, наводите курсор на токен — видите его attention-веса. Такой подход подходит и новичкам, которые только знакомятся с темой, и опытным инженерам, которым нужно освежить детали.
Выбор GPT-2 (small) в качестве демо-модели не случаен: она не самая мощная, но использует те же архитектурные компоненты и принципы, что и современные state-of-the-art модели, поэтому идеально подходит для изучения основ.
Три ключевых компонента transformer
Любой текстовый генеративный transformer состоит из трёх частей, и визуализация показывает их все:
- Embedding — входной текст делится на токены, которые превращаются в числовые векторы, отражающие смысл слов.
- Transformer Block — основной строительный блок модели, включающий механизм attention (обмен информацией между токенами) и MLP-слой (доработка представления каждого токена по отдельности).
- Output Probabilities — финальные линейный слой и softmax превращают обработанные векторы в вероятности следующего токена.
Раскрывая каждый блок в визуализации, можно увидеть численные значения на любом этапе конвейера.
Embedding: от текста к векторам
Первый этап — превращение промпта в числовое представление. Визуализация разбирает его на четыре шага.
Токенизация. Входной текст разбивается на токены — слова или части слов. Например, слова «Data» и «visualization» становятся отдельными токенами, а «empowers» делится на два. Словарь GPT-2 содержит 50 257 уникальных токенов, и он фиксируется до начала обучения модели.
Token embedding. Каждый токен представляется вектором размерности 768. Все векторы хранятся в матрице формы (50 257, 768) — это около 39 миллионов параметров. Благодаря такой матрице токены с похожим смыслом оказываются рядом в многомерном пространстве, а далёкие по смыслу — далеко друг от друга.
Positional encoding. Модель должна знать не только что написано, но и в каком порядке. GPT-2 обучает собственную матрицу позиционного кодирования прямо в процессе тренировки.
Финальный embedding. Вектор токена складывается с позиционным кодированием — получается представление, которое несёт и смысл, и информацию о позиции в последовательности.
Transformer Block: внутри multi-head self-attention
В GPT-2 (small) — 12 последовательных transformer-блоков, через которые представления токенов постепенно усложняются. Сердце каждого блока — multi-head self-attention, и визуализация раскрывает его пошагово.
Шаг 1: матрицы Query, Key и Value. Каждый вектор токена преобразуется в три вектора: Query, Key и Value. Авторам удаётся объяснить их через аналогию с веб-поиском: Query — это поисковый запрос («что я хочу найти»), Key — заголовки страниц в выдаче (кандидаты, на которые можно обратить внимание), Value — содержимое найденных страниц (полезная информация).
Шаг 2: разбиение на головы. Векторы Q, K и V делятся на 12 attention-голов, каждая из которых независимо обрабатывает свой фрагмент embedding и ловит свои закономерности: одна может отслеживать короткие синтаксические связи, другая — более широкий семантический контекст.
Шаг 3: masked self-attention. Скалярное произведение Query и Key даёт матрицу attention-оценок. Затем применяется маска к верхнему треугольнику матрицы: модель не имеет права «подглядывать» за будущие токены, они получают значение минус бесконечность. После масштабирования и softmax каждая строка матрицы превращается в распределение вероятностей — степень важности всех предыдущих токенов.
Шаг 4: выход и конкатенация. Attention-оценки умножаются на матрицу Value, выходы всех 12 голов конкатенируются и проходят через линейную проекцию.
После attention идёт MLP-слой — полносвязная сеть с функцией активации GELU. Она сначала расширяет размерность представления с 768 до 3072 (захватывая более сложные паттерны), а затем сжимает обратно до 768. Принципиальное отличие от attention: MLP обрабатывает каждый токен независимо, обогащая его представление, тогда как attention маршрутизирует информацию между токенами.
Предсказание следующего токена
После всех 12 блоков финальный линейный слой проецирует представления в пространство размерности 50 257 — по одному значению (logit) на каждый токен словаря. Softmax превращает логиты в распределение вероятностей, из которого сэмплируется следующий токен.
Здесь визуализация особенно полезна: она показывает, как работают параметры генерации, которые разработчики обычно просто подставляют из документации API.
Temperature. Логиты делятся на значение temperature. При temperature = 1 ничего не меняется. При temperature < 1 распределение становится более «острым» — модель отвечает увереннее и предсказуемее. При temperature > 1 распределение сглаживается — в тексте появляется больше случайности, то, что часто называют «креативностью» модели.
Top-k sampling. В кандидатах остаются только k токенов с наивысшими вероятностями, маловероятные варианты отфильтровываются.
Top-p sampling. Берётся наименьший набор токенов, суммарная вероятность которого превышает порог p.
Двигая ползунки в визуализации, можно прямо на живой модели увидеть, как меняется распределение вероятностей следующего токена.
Отдельно на странице описаны вспомогательные компоненты, важные для обучения, но не для базового понимания архитектуры: Layer Normalization (стабилизирует обучение и ускоряет сходимость, применяется дважды в каждом блоке), Dropout (регуляризация от переобучения, отключается на инференсе) и Residual Connections (шунты вокруг слоёв, решающие проблему затухающих градиентов; впервые появились в ResNet в 2015 году).
Интерактивные возможности
Что можно делать прямо на странице:
- Вводить свой текст и смотреть, как модель его обрабатывает и предсказывает следующее слово: attention-веса, промежуточные вычисления и финальные вероятности.
- Двигать ползунок temperature и наблюдать, как меняется баланс между детерминированностью и «творчеством» модели.
- Переключать top-k и top-p и видеть, как меняется распределение кандидатов.
- Исследовать attention-карты: наведение курсора на токен подсвечивает его веса внимания к другим токенам.
Как это реализовано
Технически проект интересен сам по себе. Модель GPT-2 (small) работает целиком в браузере: реализация основана на PyTorch-коде GPT из проекта nanoGPT Andrej Karpathy и конвертирована в ONNX Runtime для выполнения на стороне клиента. Интерфейс написан на JavaScript с использованием фреймворка Svelte, а визуализации построены на D3.js. Все численные значения пересчитываются на лету в ответ на ввод пользователя.
Проект распространяется по лицензии MIT, исходный код доступен в репозитории: https://github.com/poloclub/transformer-explainer. Там же лежит исследовательская статья команды (опубликована на конференции CHI 2026) и инструкция по локальному запуску через npm — понадобится Node.js v20+ и NPM v10+.
Команда Polo Club известна и другими образовательными визуализациями того же формата: CNN Explainer, GAN Lab и Diffusion Explainer, который объясняет, как Stable Diffusion превращает текстовый промпт в изображение.
Почему это стоит bookmarks
Для разработчика, работающего с LLM API, визуализация даёт интуицию, которую не получить из документации: почему температура меняет стиль ответа, что на самом деле делает top-p, почему модель иногда «глючит» на длинном контексте и откуда берётся его стоимость в токенах. А если вы строите собственные AI-фичи и хотите глубже понимать, что происходит под капотом, — это, пожалуй, самый доступный способ пройтись по всей архитектуре transformer без чтения академических статей.